Ein einziger nicht konvertierbarer Datums-Text, und der ganze ETL-Lauf bricht ab. Das hier vorgestellte Design Pattern für die Architektur eines ETL-Prozesses verhindert genau das: schlechte Daten werden isoliert, nicht weitergereicht.
TL;DR — was dieser Artikel zeigt:
- Arbeitspakete und Schema-Schichtung E0–L2 — wie sich der ETL-Prozess in trennscharfe, in sich geschlossene Pakete mit jeweils eigenem Datenbankschema zerlegen lässt.
- Technische vs. strukturelle Transformation — warum Typisierung und Fremdschlüssel-Auflösung als getrennte Pässe sicherer und besser debugbar sind als in einem.
- Datenqualität an den Schema-Grenzen — fehlerhafte Datensätze werden an den Übergängen abgefangen, der Hauptstrom läuft sauber weiter.
- Historisierung als optionale Schicht — fachlich motiviert (SCD 1 / SCD 2), bei Delta-Loads mit technischem Zusatznutzen.
Voraussetzung. Grundverständnis von ETL-Prozessen. Konzeptueller Artikel — kein Schritt-für-Schritt-Tutorial. Die Technologie-Beispiele sind SQL-Server-zentriert, die Postgres-Pendants stehen in der FAQ. Ausgangspunkt der Artikelserie: Datenqualität in einem ETL-Prozess. Der vorliegende Artikel ist der Architektur-Teil.
Inhalt
Aufgaben des ETL-Prozesses
Ein ETL-Prozess besteht aus den drei allgemeinen Schritten E = Extract, T = Transform und L = Load. Was aber genau in diesen übergeordneten Arbeitsschritten durchzuführen ist, bleibt Definitionssache.
Extraktion
In diesem Schritt werden Daten aus verschiedenen Datenquellen extrahiert. Das können Datenbanken sein, Dateien oder auch APIs. Die zu extrahierenden Daten können strukturiert oder unstrukturiert sein und in verschiedenen Formaten vorliegen. In dieser Artikelserie werden ausschließlich strukturierte Daten behandelt. Strukturierte Datenquellen sind relationale Datenbanksysteme, aber auch CSV-Dokumente sowie XML- und JSON-Dokumente, sofern ihre Datenelemente einer logischen Struktur folgen. Unstrukturierte Daten wie zum Beispiel Texte aus sozialen Netzwerken werden hier nicht berücksichtigt.
Bei dieser allgemeinen Definition der Extraktion bleibt jedoch unklar, was genau mit Extraktion gemeint ist. Eine konkrete Ausgestaltung des Extraktionsprozesses wird in den folgenden Abschnitten beschrieben:
- Materialisierung der extrahierten Daten
- Erweiterte Aufgaben der Extraktion
- Keine fachliche Typisierung bei der Extraktion
Materialisierung der extrahierten Daten
Das hier vorgestellte Design Pattern speichert alle extrahierten Daten in einer Datenbank. Die Speicherung ist so auszulegen, dass ein einzelner ungültiger Wert sie nicht scheitern lässt. Abbrechen darf ein Extraktions-Schritt nur, wenn die Lieferung selbst nicht verarbeitbar ist (beschädigte oder nicht parsebare Dateien, unerwartetes Encoding) oder die Infrastruktur versagt (Speicherplatz, Netzwerk). Die Speicherung von Daten in einer Datenbank wird hier als Materialisierung der Daten bezeichnet.
Die Extraktion und Materialisierung der extrahierten Daten haben vor allem drei Vorteile:
- Minimierung der Zugriffsdauer auf die Daten des Quellsystems
- Verfügbarkeit aller extrahierten Daten in einer Datenbank
- Möglichkeit der nachträglichen Fehleranalyse
Der Zugriff auf Datenbanken des Quellsystems kann das Quellsystem so weit belasten, dass die Performance und Reaktionszeiten des Quellsystems in Mitleidenschaft gezogen werden. Durch eine Extraktion wird die Dauer des Zugriffs minimiert.
Liegen alle extrahierten Daten in einer Datenbank vor, können die extrahierten Daten über SQL weiterverarbeitet werden. Für die Weiterverarbeitung ist insbesondere kein ETL-Tool erforderlich, das Daten aus unterschiedlichen Systemen integriert. Hierdurch werden unter anderem technische Hürden reduziert, und nachfolgende Prozesse sind in Ausführung und Entwicklung oft deutlich performanter.
Erweiterte Aufgaben der Extraktion
Bei Textdateien im Format XML und JSON (und gegebenenfalls auch CSV) verhält es sich bei der Materialisierung ein wenig anders. XML- und JSON-Dokumente werden vor der Extraktion der darin enthaltenen Daten selbst in der Datenbank gespeichert. Als erweiterte Aufgabe der Extraktion sind die Attribute aus den Dokumenten über T-SQL-Funktionen wie OPENJSON oder OPENXML zu extrahieren und in der Datenbank zu speichern.
Keine fachliche Typisierung bei der Extraktion
Insbesondere Datenlieferungen über Textdateien sind problematisch. Die enthaltenen Daten liegen keineswegs typsicher vor. Ein Datum, das als Text geliefert wird, kann gegebenenfalls nicht in einen Wert vom Typ date konvertiert werden. Zwischen dem die Daten liefernden Prozess und dem ETL-Prozess muss es eine Vereinbarung darüber geben, in welchem Format zum Beispiel ein Datum geliefert wird (yyyy-MM-dd, dd.MM.yyyy, etc.). Die Konvertierung von Werten während der Extraktion ist eine Fehlerquelle und birgt die Gefahr des Abbruchs des ETL-Prozesses. Die fachliche Typisierung in die Zieldatentypen ist in diesem Pattern im Rahmen der Extraktion daher nicht zulässig: Eingangswerte werden zunächst in einem bewusst toleranten Textformat materialisiert und erst in der technischen Transformation in die fachlich benötigten Zieltypen konvertiert.
Transformation
Eine gängige Definition des Schrittes der Transformation könnte so lauten: Die Transformation hat zum Ziel, die extrahierten Daten in das gewünschte Format zu bringen. Eine andere mögliche Definition fasst die erforderlichen Aufgaben unter dem Begriff der Datenintegration zusammen. Beide Definitionen und der Begriff Datenintegration sagen alles und nichts. Einen Hinweis auf die konkret erforderlichen Maßnahmen geben sie nicht.
Ausgehend von den extrahierten Daten fallen nach dem hier vorgestellten Design Pattern grundsätzlich zwei verpflichtende und eine optionale Aufgabe an:
- Typisierung der extrahierten Daten
- Prüfung der Datenqualität
- Optional: Historisierung
Werden die Daten in Textdateien geliefert, dann sind die extrahierten Attribute zunächst in die Zieldatentypen zu konvertieren. Das gilt oft auch dann, wenn Daten aus Datenbanken extrahiert werden und die Datentypen des Quell- und des Zielsystems auseinanderlaufen. Dieser Abschnitt beschränkt sich aber auf Textdateien als Datenquelle. Wie oben beschrieben, werden aus Textdateien extrahierte Werte zunächst als Werte vom Typ Text gespeichert. Das Zielsystem erwartet aber stark typisierte Daten. So wird zum Beispiel ein Datum regelmäßig in einen Wert vom Typ date zu konvertieren sein.
Die Prüfung der Datenqualität ist zudem eine äußerst wichtige Aufgabe, die einen fundamentalen Einfluss auf das Ergebnis eines ETL-Prozesses hat. Sie beginnt hier mit der Prüfung, ob ein gelieferter Wert in den Datentyp des entsprechenden Zielfeldes im Zielsystem konvertiert werden kann. Gegebenenfalls müssen die gelieferten Daten auf Duplikate geprüft werden. Weitere Regeln betreffen etwa Wertebereiche, Abhängigkeiten zwischen Feldern, Referenzdaten und fachliche Plausibilitäten.
Bei der Historisierung werden die als geändert identifizierten Quelldaten (neue, geänderte oder gelöschte Daten) in separaten Tabellen fortgeschrieben, sodass immer nachvollziehbar ist, wann ein Datensatz eingefügt, geändert oder gelöscht wurde. Dieser Schritt ist optional. Ein Kollege hat die historisierten Daten einmal als das Gehirn des ETL-Prozesses bezeichnet. Bei vollständiger Historisierung und reproduzierbaren Transformations- und Mapping-Regeln lassen sich die Daten des nachfolgenden Zielsystems aus den historisierten Daten wiederherstellen. Natürlich erfordert die Historisierung weitergehende Wartungsaufgaben, wie zum Beispiel Sicherungsaufgaben.
Der Begriff Datenintegration bezeichnet am ehesten die strukturelle Transformation. Es werden Daten aus verschiedenen Datenquellen gefiltert, zusammengeführt und aggregiert. Obwohl es sich auch hier um eine Transformationsaufgabe handelt, wird diese Aufgabe nach dem hier vorgestellten Design Pattern nicht im Rahmen des T, sondern im Rahmen des L des ETL-Prozesses durchgeführt. An dieser Stelle ist es hilfreich, die in diesem Abschnitt beschriebenen Transformationsaufgaben von der strukturellen Transformation begrifflich scharf zu trennen. Die Transformationsaufgaben, die in diesem Abschnitt beschrieben und im Rahmen des T des ETL-Prozesses durchzuführen sind, werden daher als technische Transformation bezeichnet. Die Transformationsaufgaben, die im L des ETL-Prozesses durchzuführen sind, werden als strukturelle Transformation bezeichnet.
Die Grenzen für die Zuordnung einer Aufgabe zu einem der übergeordneten Schritte eines ETL-Prozesses sind fließend und am Ende eine Frage der Definition.
Typisierung der extrahierten Daten
Ist die Datenquelle eine Datenbank wie zum Beispiel SQL Server oder Oracle, liegen die Daten üblicherweise stark typisiert vor. Auch dann kann eine Typisierung entsprechend dem Datentyp im Zielsystem erforderlich sein.
Beispiel: Typische Fälle sind die Länge von Textfeldern und die Speicherung eines Zeitpunkts ohne Angabe der Zeitzone. Softwareentwickler legen bisweilen keinen starken Fokus auf die Begrenzung der Eingabe von Texten. Damit kann es vorkommen, dass zum Beispiel in einem Adressfeld im Quellsystem ganze Romane gespeichert werden können. Anwender, die solch eine Lücke bei der Nutzung einer Anwendung entdecken, werden diese erfahrungsgemäß auch nutzen, um dort weitere Informationen einzugeben, die dort einfach nicht hingehören. Liefert die Quelle einen Zeitpunkt ohne Zeitzonen-Angabe, muss vor der Konvertierung geklärt werden, in welcher Zeitzone dieser Zeitpunkt fachlich zu interpretieren ist. In SQL Server kommt als Zieldatentyp je nach Anforderung datetime2 oder datetimeoffset infrage.
Bei der Verarbeitung von extrahierten Attributen, die aus einer Textdatei gelesen werden, ist immer eine Typisierung der extrahierten Werte in die Zieldatentypen erforderlich.
Beispiel: Bei der Extraktion werden die extrahierten Attribute als Werte vom Typ Text gespeichert. Ein Text, der augenscheinlich wie ein Datum aussieht, muss nicht zwangsläufig in einen Wert vom Typ date konvertierbar sein. So ist der Text 30-02-2023 kein gültiges Datum. Ein weiteres Beispiel: Der Text 03-05-2023 kann nicht ohne zusätzliche Information über die Datenquelle als Datum interpretiert werden. Die Interpretation nach amerikanischer Schreibweise gemäß der Formatzeichenfolge MM-dd-yyyy ergibt als Datum den 05.03.2023, während die Interpretation gemäß deutscher Schreibweise und der in Deutschland üblichen Formatzeichenfolge dd-MM-yyyy das Datum 03.05.2023 ergibt. Für die korrekte Interpretation ist die Kenntnis über das Datums-Format — also die Formatzeichenfolge — erforderlich. Ähnliche Aufgaben und Herausforderungen gibt es bei Zahlen mit Bezug zum Dezimal- und Tausendertrennzeichen.
Prüfung der Datenqualität
Bei der Prüfung der Datenqualität werden die extrahierten und konvertierten Daten auf Vollständigkeit und Korrektheit geprüft. Diese Prüfungen umfassen ein weites Feld. Beispiele hierfür sind:
- Prüfung der Typisierung
- Identifikation von Duplikaten
- Prüfung der Schreibweise und Rechtschreibung von Texten
- Prüfung von Fremdschlüsseln
- Prüfung fehlender Werte für Pflichtfelder
- Validierung von Geschäftslogiken
Im Artikel Datenqualität in einem ETL-Prozess wurde der Begriff der technischen Datenqualität vorgestellt. Die Prüfung der technischen Datenqualität erfolgt auf den typisierten Daten. Für die Prüfung der Datenqualität in den typisierten Daten lassen sich einfache logische Bedingungen aufstellen, über die Fehler in einem Wert bzw. einem Datensatz identifiziert werden. Eine Datenqualitätsregel wird technisch als WHERE-Prädikat im ETL-Prozess hinterlegt und auf die typisierten Daten angewendet — das Prädikat ist so formuliert, dass es genau die fehlerhaften Datensätze selektiert. Jeder Treffer enthält im untersuchten Feld, auf das sich die Regel bezieht, einen Fehler.
Prüfung der Typisierung
Der Erfolg oder Misserfolg der Typisierung hat unmittelbaren Einfluss auf alle nachfolgenden Aufgaben. Kann ein Eingangswert nicht in den Zieldatentyp konvertiert werden, darf der Datensatz, der den Fehler enthält, gegebenenfalls nicht weiterverarbeitet werden. Über das hier vorgestellte Design Pattern wird für alle gelieferten Quelldaten geprüft, ob Eingangswerte in den jeweiligen Zieldatentyp konvertiert werden können.
Identifikation von Duplikaten
Die Identifikation von Duplikaten kann beliebig komplex sein. Diese Artikelserie beschränkt sich auf eine Kombination von Feldern, die in der Datenlieferung einer vorgegebenen Kardinalität entsprechen oder eindeutig sein müssen (Kardinalität = 1).
Prüfung der Schreibweise und Rechtschreibung von Texten
Für Telefonnummern gibt es zahlreiche Schreibweisen. Nach der DIN-Norm 5008 ist die Vorwahl ohne Klammern zu schreiben und von der restlichen Telefonnummer durch ein Leerzeichen zu trennen. Formatregeln wie diese können im Rahmen der technischen Transformation als Prüfregel verwendet werden. Welche Schreibweise fachlich als korrekt gilt, ist dabei keine Norm-Frage, sondern eine Konvention, die pro Zielsystem festzulegen ist.
Prüfung von Fremdschlüsseln
Enthalten die gelieferten Daten eine Fremdschlüssel-Beziehung, ist hier nur die syntaktische Gültigkeit eines gelieferten Fremdschlüssel-Werts zu prüfen — also Format, Pflicht-Vorhandensein und Datentyp. Die eigentliche Ermittlung des Fremdschlüssels gegen das Zielsystem (Mapping Source-Code → Target-Surrogate) erfolgt erst später, im Rahmen der strukturellen Transformation. Erst dort wird die referenzielle Gültigkeit gegen die Referenztabelle festgestellt. Der Grund für die Trennung: die Ermittlung braucht Kontext aus dem Zielsystem (etwa eine Länder-Tabelle), die Format- und Pflicht-Prüfung kommt mit dem Datensatz allein aus.
Prüfung fehlender Werte für Pflichtfelder
Ist ein Attribut im Zielsystem ein Pflichtfeld, für das ein Wert vorliegen muss, so sind die typisierten Daten daraufhin zu prüfen, ob hier ein entsprechender Wert geliefert wird.
Validierung von Geschäftslogiken
Die Prüfung von Geschäftslogiken ist ein weites Feld und kann beliebig komplex sein. Aber bereits die Prüfung einfacher Geschäftsregeln verbessert die Datenqualität spürbar. Ein Beispiel für eine einfache Geschäftslogik ist das Geburtsdatum eines Kunden: Es darf nicht in der Zukunft liegen.
Laden
Typisierte Daten werden im letzten Schritt des ETL-Prozesses strukturell entsprechend den Datenstrukturen des Zielsystems transformiert, gegebenenfalls noch einmal auf Datenfehler hin untersucht, gefiltert und aggregiert, historisiert und schließlich in das Zielsystem geladen. Es sind die folgenden Aufgaben durchzuführen:
- Strukturelle Transformation
- Prüfung der Datenqualität
- Filterung
- Datenaggregation
- Optional: Historisierung
- Laden der Daten in das Zielsystem
Die zuvor technisch transformierten Daten können in verschiedene Zielsysteme geladen werden. Das Zielsystem kann zum Beispiel ein CRM-System oder ein Data Warehouse sein. Die Aufgabe der strukturellen Transformation ist spezifisch für ein bestimmtes Zielsystem. Daher erfolgt die strukturelle Transformation im Rahmen des L des ETL-Prozesses.
Strukturelle Transformation
Die strukturelle Transformation arbeitet ausschließlich auf den typisierten, qualitätsgesicherten und gegebenenfalls historisierten Daten, die als fehlerfrei erkannt wurden. Technisch betrachtet entspricht die strukturelle Transformation einem SELECT-Statement, das die Daten aus den historisierten Tabellen über JOINs verknüpft und entsprechend den Strukturen der Daten im Zielsystem aufbereitet. Im Rahmen der strukturellen Transformation sind unter anderem Fremdschlüssel zu ermitteln sowie Lookup-Werte aufzulösen:
Das Ergebnis der strukturellen Transformation wird — wie schon bei der Extraktion und der technischen Transformation — in einer Datenbank materialisiert, um auch diese Daten für eine Analyse und Fehlersuche verfügbar zu machen. Die Datenstrukturen der strukturell transformierten Daten entsprechen weitestgehend den Datenstrukturen der Daten im Zielsystem. Insbesondere werden bei der strukturellen Transformation die Spaltennamen und Datentypen des Arbeitsergebnisses so gewählt, wie sie durch das Zielsystem vorgegeben sind.
Ermittlung von Fremdschlüsseln
Können Fremdschlüssel nicht auf der Basis der extrahierten Daten ermittelt werden, sind sie gegen die Daten des Zielsystems zu ermitteln.
Beispiel: So werden Länder im Zielsystem regelmäßig in einer separaten Tabelle gespeichert. Das Land United States wird im Zielsystem sowohl durch die Länderbezeichnung als auch — normalerweise — durch einen technischen Schlüssel (z. B. eine GUID) identifiziert. Bei der strukturellen Transformation eines Kunden ist das Land des Kunden, das in der Quelle durch den Text United States angegeben ist, in den Primärschlüssel dieses Landes im Zielsystem zu übersetzen und als Fremdschlüssel mit dem Kunden zu speichern.
Die Ermittlung des Fremdschlüssels erfordert einen direkten lesenden Zugriff auf die Tabelle Länder des Zielsystems. Besteht kein direkter Zugriff, ist diese Tabelle vor der strukturellen Transformation zu lesen, und ihre Daten sind in einer Datenbank verfügbar zu machen. An diesem Punkt angelangt, handelt es sich beim Lesen der Tabelle Länder wiederum um eine Extraktionsaufgabe.
Auflösung von Lookup-Werten
Häufig verwenden Quell- und Zielsysteme unterschiedliche Werte für die Speicherung eines Wertes eines Auswahlfeldes. Ein Auswahlfeld ist zum Beispiel ein Listenfeld, über das die Anrede eines Kunden ausgewählt werden kann.
In einer Datenbank wird selten die in der Anwendung angezeigte und ausgewählte Anrede gespeichert. Gespeichert wird möglicherweise der Wert 1 für die Anrede Herr und der Wert 2 für die Anrede Frau. Die Kodierung der Anrede im Quellsystem und dem Zielsystem weicht normalerweise voneinander ab.
Die Kodierung solcher Attribute ist häufig nicht in separaten Tabellen gespeichert. Die Übersetzung des Codes des Quellsystems in den Code des Zielsystems erfordert somit das Wissen um die Regeln für die Übersetzung des Codes. Die Übersetzung des Codes des Quellsystems in den Code des Zielsystems wird in Anlehnung an Begrifflichkeiten von Microsoft Dynamics CRM als Auflösung von Lookup-Werten bezeichnet. Für die Auflösung von Lookup-Werten sind die Codes des Quell- und des Zielsystems zu ermitteln und in einer Mapping-Tabelle zu speichern, die bei der strukturellen Transformation abgefragt wird.
Prüfung der Datenqualität
Die Erfahrung aus dem Projektgeschäft hat gezeigt, dass die Ermittlung von Fremdschlüsseln sowie die Auflösung von Lookup-Werten eine große Fehlerquelle darstellt, die in einer unvollständigen oder fehlerhaften Ermittlung des Mappings der Codes des Quellsystems auf die Codes des Zielsystems begründet ist.
Filterung
Sofern es sich nicht um eine initiale Befüllung des Zielsystems mit Daten handelt, sind nur Daten mit bestimmten Eigenschaften in das Zielsystem zu laden. Die Filterung auf tatsächlich zu ladende Daten kann — sofern möglich — bereits bei der technischen Transformation erfolgen. Ist das dort nicht möglich, sind die Daten während der strukturellen Transformation zu filtern.
Datenaggregation
Gegebenenfalls sind Daten vor dem Laden des Zielsystems zu aggregieren.
Wenn eine durchgängige Nachvollziehbarkeit aller Prozessschritte in einem ETL-Prozess gewährleistet sein soll, ist zu überlegen, ob der Aggregationsprozess auf den Daten der strukturellen Transformation nachgelagert als zusätzlicher Prozessschritt vorzunehmen ist. Aggregierte Daten wären in diesem Fall in separaten Tabellen einer Datenbank zu speichern.
Historisierung
Wie schon bei der technischen Transformation können die strukturell transformierten und geprüften Daten in separaten Tabellen fortgeschrieben werden. Neue Daten werden hier eingefügt, geänderte Datensätze werden hier aktualisiert und gelöschte Datensätze als gelöscht markiert.
Laden der Daten in das Zielsystem
Das abschließende Laden der geänderten Daten in das Zielsystem arbeitet somit auf qualitätsgesicherten, strukturell transformierten und historisierten Daten. Es werden nur fehlerfreie Datensätze, bei denen also Fremdschlüssel und Lookup-Wert erfolgreich ermittelt werden konnten, in das Zielsystem geladen.
Technologisch beschränkt sich dieser Artikel auf das Laden der Änderungsdaten in eine Ziel-Datenbank. Die Ziel-Datenbank wird über SQL-Statements aktualisiert, also über INSERT-, UPDATE– und gegebenenfalls auch DELETE-Statements. Andere Zielsysteme — wie zum Beispiel Dynamics 365 von Microsoft — erfordern die Nutzung einer proprietären API, um Daten in das Zielsystem schreiben oder auch um Daten von dort lesen zu können. In diesem Fall wird ein API-fähiger Integrationsmechanismus benötigt: SQL Server Integration Services mit geeigneten Komponenten, ein eigener API-Client oder ein anderes ETL-/ELT-Tool.
Architektur des ETL-Prozesses
Das Pattern lässt sich in einem Satz fassen: Jedes Arbeitspaket hat ein eigenes Datenbankschema, prüft die Datenqualität an seiner Grenze und reicht nur fehlerfreie Datensätze weiter. Die hier vorgestellte Architektur ist breit übertragbar und kann unabhängig von der Art der zu extrahierenden Datenquellen und der Zielsysteme in relationalen Datenmigrations- und Datenintegrationsprojekten eingesetzt werden. Sie eignet sich ebenso für die Datenbewirtschaftung eines Data Warehouses. Der ETL-Prozess wird in kleine, in sich geschlossene Arbeitspakete mit trennscharf definierten Aufgaben zerlegt. Am Ende des Prozesses stehen qualitätsgesicherte Daten in Datenstrukturen zur Verfügung, die ähnlich zu den Strukturen im Zielsystem sind und ohne weitere fachliche Transformationen direkt dorthin geladen werden können.
Arbeitspakete des ETL-Prozesses
Das folgende Schaubild veranschaulicht die Arbeitspakete des hier vorgestellten ETL-Prozesses:
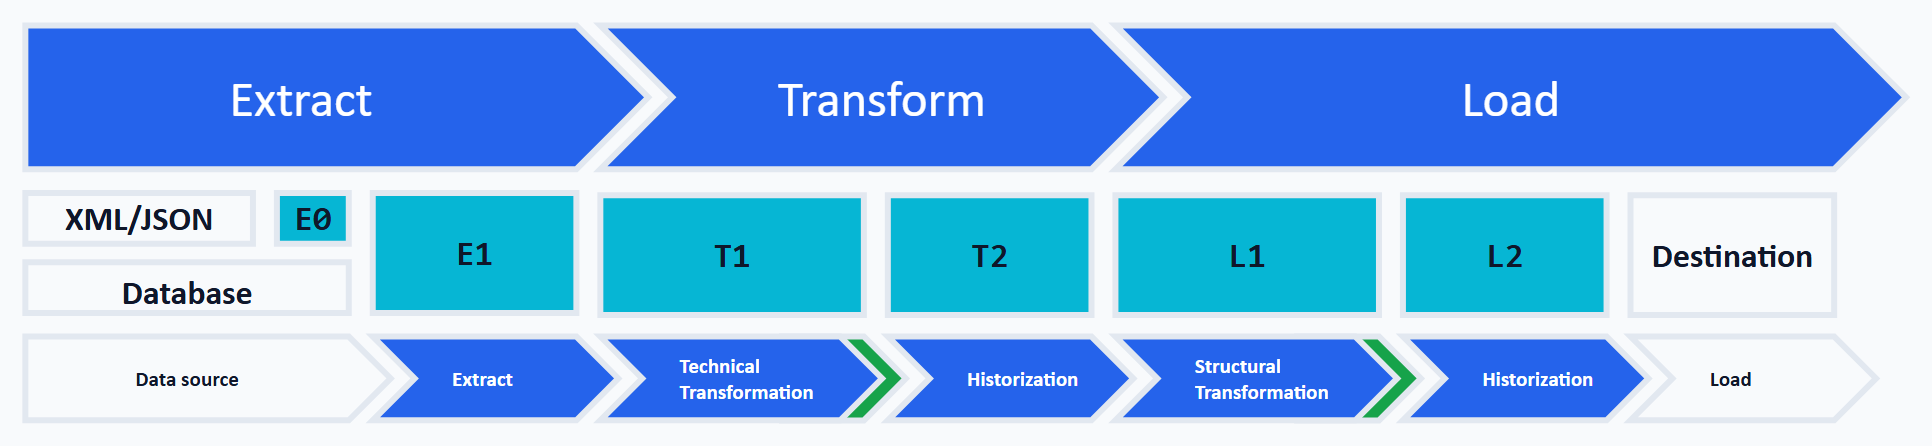
In der Abbildung werden in der oberen Zeile zunächst die übergeordneten Schritte analog zum Akronym ETL dargestellt: Extract, Transform und Load. Die untere Zeile benennt die konkreten Arbeitspakete des ETL-Prozesses und ordnet diese einem übergeordneten Schritt zu. Jedem Arbeitspaket ist ein Datenbankschema zugeordnet. In der Mitte werden die vom ETL-Prozess verwendeten Schemas je Arbeitspaket benannt (E0–L2). Bei der Verarbeitung werden die Daten von Arbeitspaket zu Arbeitspaket bzw. Schema zu Schema weitergereicht. Der ETL-Prozess besteht aus den folgenden Arbeitspaketen:
- Extraktion der Daten
- Technische Transformation
- Historisierung der technisch transformierten Daten
- Strukturelle Transformation
- Historisierung der strukturell transformierten Daten
- Laden der Daten in das Zielsystem
Die sechs Schemas im Überblick:
| Schema | Zweck | Fehlerklasse an der Grenze | Persistenz |
|---|---|---|---|
| E0 | Roh-Dokumente (XML/JSON) | Format-/Parserfehler | nur bei Dokument-Quellen |
| E1 | extrahierte Rohdaten, untypisiert | Infrastruktur-/Extraktionsfehler | ja |
| T1 | typisierte und geprüfte Daten | technische Datenqualität (Typ-Fehler) | ja |
| T2 | Historie der technisch transformierten Daten | — | optional |
| L1 | zielsystemnahe Strukturen | strukturelle Datenqualität (FK/Lookup) | ja |
| L2 | Historie der strukturell transformierten Daten samt Lade-Flags | — | optional |
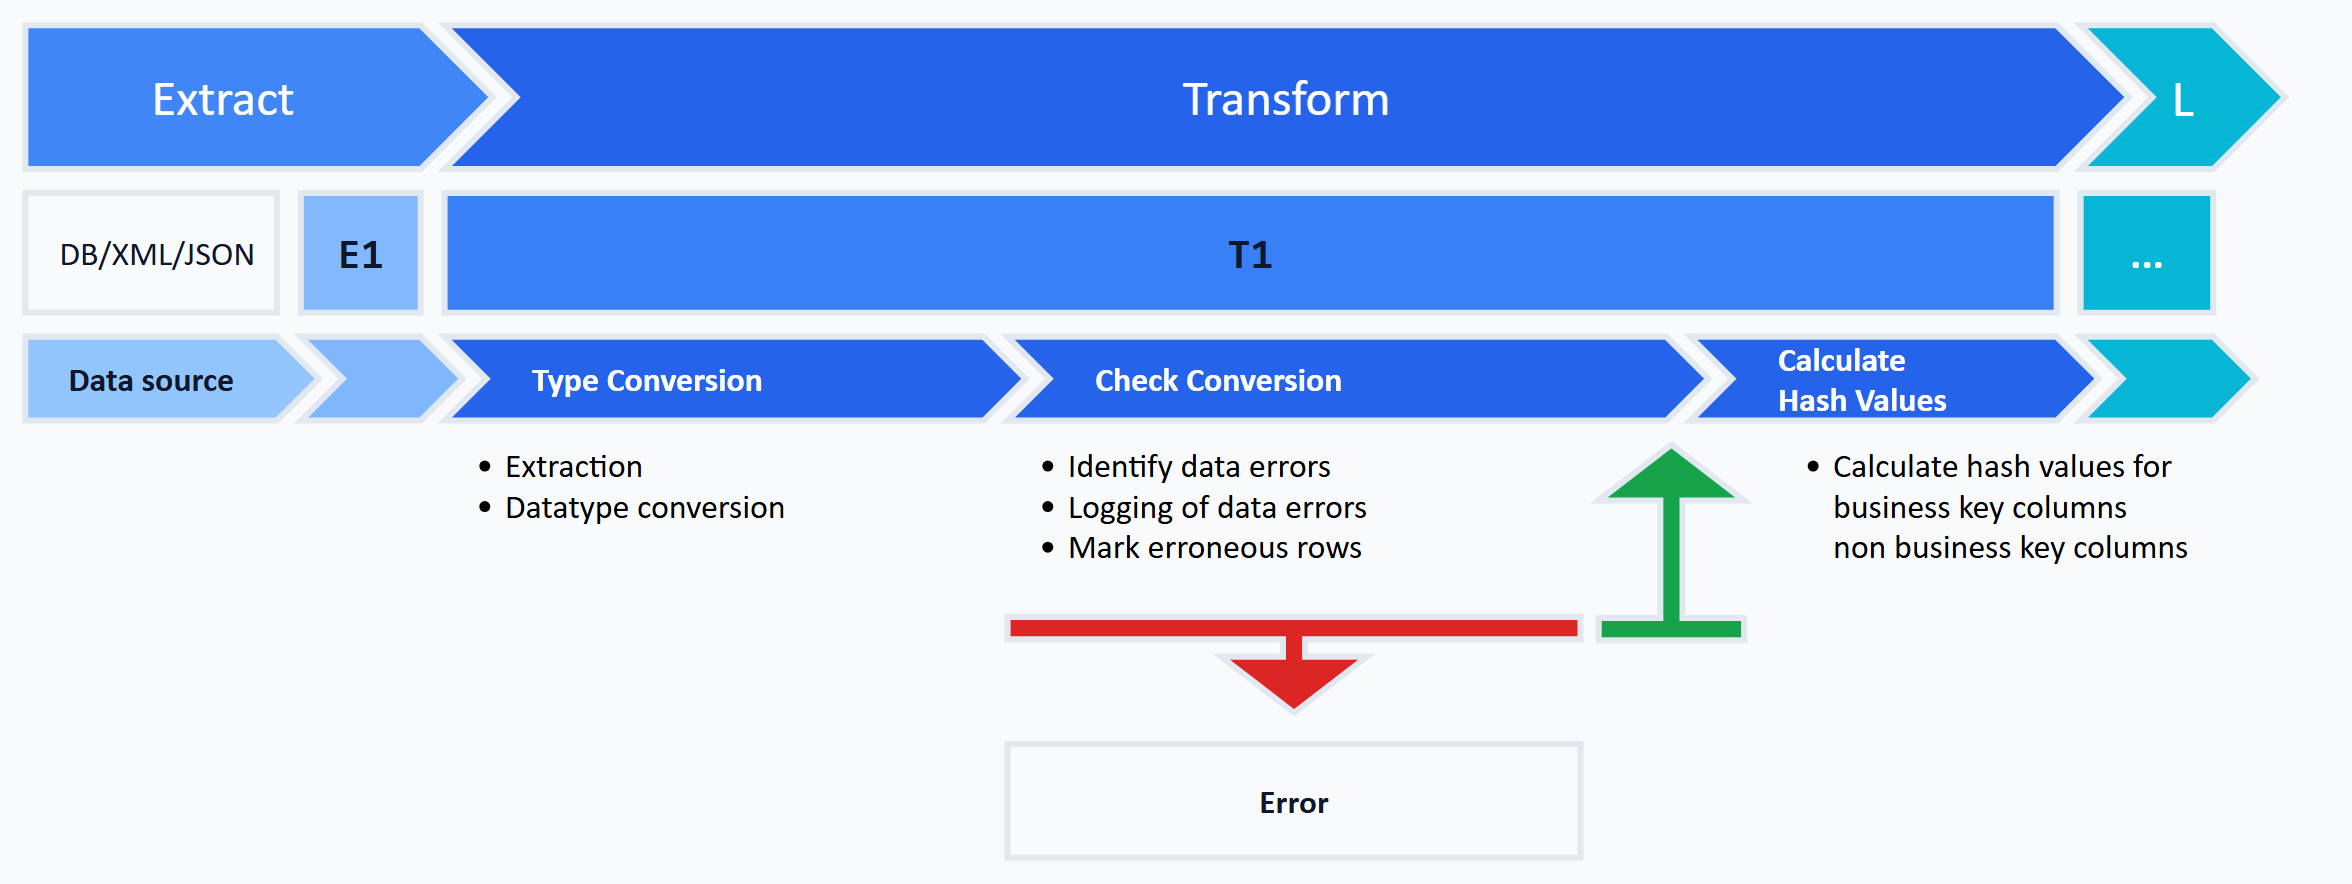
Die Arbeitspakete Technische Transformation und Strukturelle Transformation prüfen die Datenqualität der transformierten Daten und reichen nur fehlerfreie Daten an das folgende Arbeitspaket weiter. Die Prüfung der Daten ist in der Abbildung durch die dunklen Pfeil-Spitzen dargestellt. Die nachfolgenden Abschnitte fassen die Arbeitsschritte der einzelnen Arbeitspakete zusammen und geben einen Überblick über die zu verwendende Technologie, mit der die Arbeitsschritte in den Arbeitspaketen durchgeführt werden.
Extraktion
Ziel der Extraktion ist es, alle zu verarbeitenden Daten zunächst in der Schnittstellendatenbank (Staging-Datenbank) zu speichern. Bei der Extraktion ist zu unterscheiden, ob die zu extrahierenden Daten aus einer Datenbank oder aus Dokumenten mit tabellenähnlichen Strukturen (zum Beispiel Excel- oder CSV-Dokumente) gelesen werden oder ob Dokumente mit komplexen logischen Strukturen (zum Beispiel XML oder JSON) zu verarbeiten sind.
Extraktion aus einer Datenbank
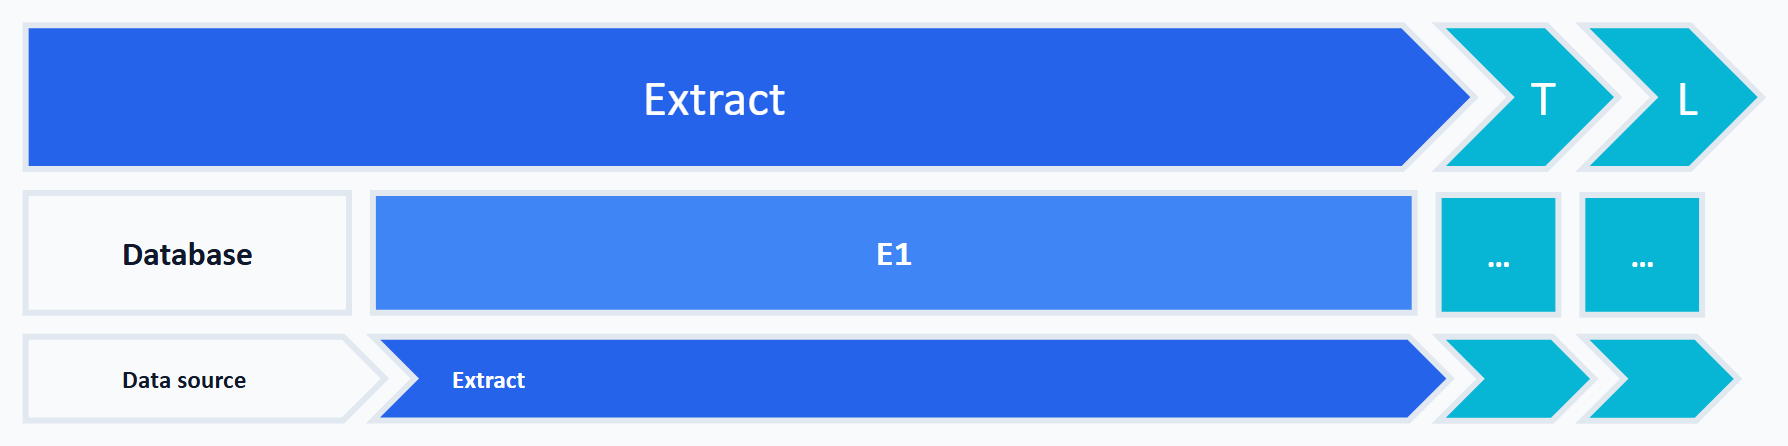
Werden Daten aus einer Datenbank oder tabellenähnlichen Strukturen gelesen, werden die Attribute/Spalten zunächst in Tabellen des Schemas E1 materialisiert. Die Strukturen der Tabellen im Schema E1 entsprechen weitestgehend den Strukturen im Quellsystem. Sind Daten aus einer Datenbank zu extrahieren, werden die Daten mit den Datentypen gespeichert, in denen sie im Quellsystem abgelegt sind. Werden die Datentypen des Quellsystems nicht durch SQL Server unterstützt, sind die Daten der Datenquelle in den Tabellen des Schemas E1 mit dem Datentyp nvarchar zu speichern. Das trägt für textuell darstellbare Werte. Binär- oder Spezialtypen (etwa Geodaten) brauchen stattdessen eine bewusste Strategie — zum Beispiel varbinary(max) oder ein Raw-Format.
Extraktion aus Dokumenten mit tabellenähnlichen Strukturen
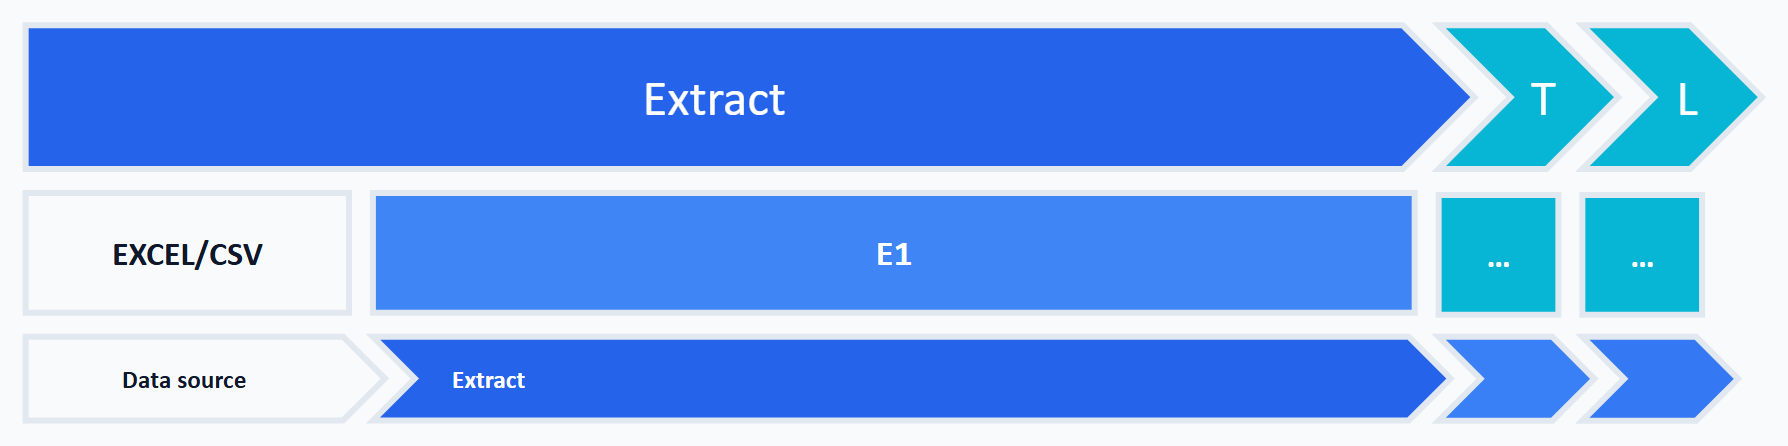
Daten aus Dokumenten mit tabellenähnlichen Strukturen, wie zum Beispiel Excel- und CSV-Dokumente, kommen ohne garantierte Typisierung an. Eine CSV-Datei transportiert keine Datentypen — jeder gelieferte Wert ist zunächst Text. Auch Excel erzwingt die Typisierung nicht: In einer als Datum angelegten Spalte kann in einzelnen Zeilen trotzdem eine Zahl oder freier Text stehen. Selbst eine Liefervereinbarung über das Spaltenformat ist nur eine Erwartung, keine Garantie. Die Prüfung bleibt Aufgabe des ETL-Prozesses, zumal diese Dokumente häufig manuell erstellt und gepflegt werden. Um sicherzustellen, dass alle Daten aus diesen Dokumenten in der Schnittstellendatenbank in den Tabellen des Schemas E1 materialisiert werden können, sind alle Daten zunächst mit dem Datentyp nvarchar zu speichern. Für die Speicherung in diesen Tabellen sind großzügige Textlängen zu verwenden — bei unbekannter Obergrenze nvarchar(max), damit die Materialisierung nicht an der Länge scheitert.
Extraktion aus Dokumenten mit komplexen logischen Strukturen
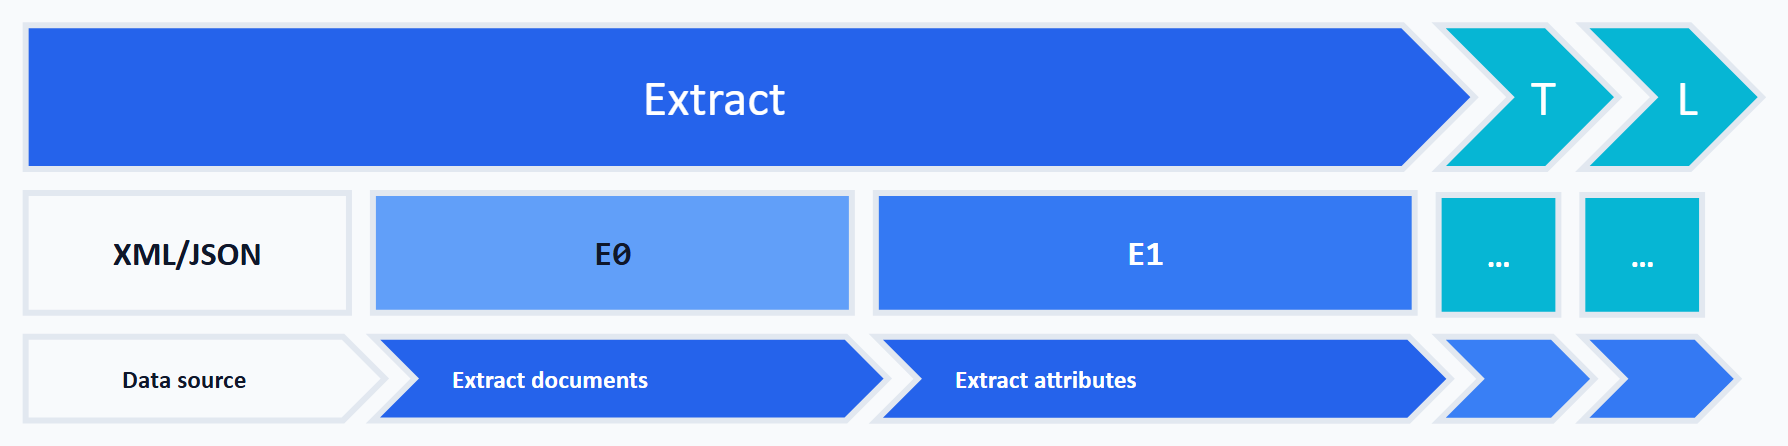
Sind XML-/JSON-Dokumente zu verarbeiten, werden diese zunächst selbst in Tabellen des Schemas E0 gespeichert. Die Attribute werden anschließend in Tabellen des Schemas E1 extrahiert. Hierbei werden die Dokumente verarbeitet, die im ersten Arbeitsschritt in den Tabellen des Schemas E0 gespeichert wurden.
Attribute aus Textdateien werden in den Tabellen des Schemas E1 als Werte vom Typ nvarchar gespeichert. Für die Speicherung in diesen Tabellen sind großzügige Textlängen zu verwenden, bei unbekannter Obergrenze nvarchar(max).
Technologie
Die Extraktion von Daten aus einer Datenbank oder tabellenähnlichen Strukturen kann mit SQL Server Integration Services (SSIS) von Microsoft oder auch jedem anderen ETL-Tool durchgeführt werden. Sind XML- oder JSON-Dokumente zu extrahieren, werden diese Dokumente ebenfalls mit SSIS zunächst in die Tabellen des Schemas E0 geladen. Die Attribute aus JSON-Dokumenten extrahiert OPENJSON. Für XML stehen die Methoden des xml-Datentyps (.nodes(), .value()) oder das ältere OPENXML zur Verfügung — OPENXML arbeitet mit einem eigenen Speicher- und Parsing-Modell (sp_xml_preparedocument) und ist vor allem in Bestands-Code verbreitet.
Zusammenfassung
Diese Vorgehensweise der Extraktion bietet mehrere Vorteile. Durch Verwendung eines ETL-Tools wie SSIS, das einen hohen Grad der Parallelisierung in der Datenverarbeitung unterstützt, können die Daten mit hohem Durchsatz in den Tabellen der Schemas E0 und E1 materialisiert werden. Vorsysteme werden minimal belastet und die Daten stehen für eine weitere Verarbeitung — wie zum Beispiel die Extraktion der Attribute aus XML- und JSON-Dokumenten über die T-SQL-Funktionen OPENXML oder OPENJSON — in der Schnittstellendatenbank zur Verfügung. Die materialisierten Daten ermöglichen zudem im Fehlerfall eine Analyse der Ursachen.
Technische Transformation
/imag
Im übergeordneten Schritt der Transformation läuft nach diesem Design Pattern die oben beschriebene technische Transformation. Diese umfasst die folgenden Arbeitsschritte:
- Typ-Konvertierung
- Prüfung der technischen Datenqualität
- Protokollierung von Datenfehlern
- Markierung fehlerhafter Datensätze
- Berechnung von Hashwerten
Typ-Konvertierung
Das Ergebnis der technischen Transformation sind typisierte Daten, wie sie im Zielsystem erwartet werden. Die Typisierung kann auf Basis von Metadaten über generische benutzerdefinierte gespeicherte Prozeduren (Stored Procedures) erfolgen und materialisiert die Daten in der Datenbank in Tabellen des Schemas T1.
Je Attribut aus den Tabellen des Schemas E1 werden zwei Spalten in den Tabellen des Schemas T1 bereitgestellt. Die erste Spalte nimmt die extrahierten Daten im Datentyp auf, in dem diese in den Tabellen des Schemas E1 gespeichert sind. Die zweite Spalte speichert den typisierten Wert im Zieldatentyp, sofern die Daten in den Zieldatentyp konvertiert werden können. Kann ein Wert nicht konvertiert werden, so wird in der jeweils zweiten Spalte ein NULL gespeichert — in T-SQL leisten das TRY_CONVERT beziehungsweise TRY_CAST, die bei fehlgeschlagener Konvertierung NULL liefern.
Prüfung der technischen Datenqualität
Nach der Typisierung wird das Ergebnis durch Vergleich der Spaltenpaare auf Probleme bei der Typ-Konvertierung hin geprüft. Ein Konvertierungsfehler liegt genau dann vor, wenn die Eingangs-Spalte einen Wert enthält, die typisierte Spalte aber NULL ist. Ein NULL im Eingang bleibt ein legitimes NULL im Ziel und ist kein Konvertierungsfehler — ob das Feld überhaupt leer sein darf, prüft die Pflichtfeld-Prüfung. Wie Leerstrings behandelt werden (als NULL oder als eigenständiger Wert), ist vorab festzulegen. Da die Typ-Konvertierung ausschließlich einen technischen Charakter hat, wird diese Prüfung hier auch als Prüfung der technischen Datenqualität bezeichnet. Die Fehlerprüfung kann bereits hier um einfache, datensatz-lokale Geschäftsregeln erweitert werden.
Protokollierung von Datenfehlern
Gefundene Datenfehler werden in einer les- und auswertbaren Form in einer Fehlertabelle protokolliert.
Markierung fehlerhafter Datensätze
Enthält ein Datensatz mindestens einen Fehler, wird dieser Datensatz als fehlerhaft markiert, damit er von der weiteren Verarbeitung ausgeschlossen werden kann. Die Markierung erfolgt in einer Spalte, in der die Anzahl der gefundenen Fehler gespeichert wird. Fehlerfreie Datensätze weisen in dieser Spalte ein NULL auf.
Berechnung von Hashwerten
Der letzte Arbeitsschritt der technischen Transformation ist die Berechnung und Speicherung von zwei Hashwerten je Datensatz. Der erste Hashwert repräsentiert die Felder des fachlichen Schlüssels eines Datensatzes, der zweite Hashwert alle übrigen Felder. Über diese beiden Hashwerte können im nachfolgenden Arbeitspaket Historisierung der technisch transformierten Daten Änderungsdatensätze identifiziert werden. Hashwerte werden nur für fehlerfreie Datensätze berechnet.
Zwei Dinge müssen dabei eindeutig festgelegt sein: die Serialisierung der Spalten (Spaltenreihenfolge, Trennzeichen, NULL-Behandlung, Encoding sowie Datums- und Dezimal-Darstellung: ohne eindeutiges Trennzeichen erzeugen ('AB','C') und ('A','BC') dieselbe Hash-Eingabe) und der Algorithmus — für SQL Server SHA2_256 oder SHA2_512 (alle älteren HASHBYTES-Algorithmen sind seit SQL Server 2016 deprecated). Streng genommen beweist ein gleicher Hash keine gleichen Daten, denn verschiedene Eingaben können denselben Hashwert erzeugen. Bei SHA2_256 ist dieses Restrisiko praktisch null. Bei kurzen Prüfsummen wie CHECKSUM (32 Bit) sind Kollisionen dagegen schon bei einigen zehntausend Zeilen wahrscheinlich (rund 50 % bei etwa 77.000 unterschiedlichen Eingaben). Als alleinige Grundlage der Änderungserkennung sind sie deshalb ungeeignet.
Technologie
Die Konvertierung der extrahierten Werte in die Zieldatentypen, die Prüfung auf Datenfehler, Markierung fehlerhafter Datensätze und Berechnung von Hashwerten kann über generische gespeicherte Prozeduren erledigt werden, die auf der Basis von Metadaten entsprechende dynamische SQL-Statements erstellen. Das erfordert einmalig Aufwand für die Implementierung solcher Prozeduren. Die genannten Aufgaben können dann durch einfache Prozedur-Aufrufe erledigt werden. Das reduziert langfristig den Entwicklungs-Aufwand und unterstützt den Entwickler durch maximale Wiederverwendbarkeit.
Tragweite der Dynamik. Dynamisches SQL fällt im engeren Sinn nur bei der Datenqualitäts-Prüfung an — eine Regel entspricht einer WHERE-Klausel, die zur Laufzeit auf die typisierte Tabelle angewendet wird. Daneben sind die genannten Prozeduren (Typ-Konvertierung, DQ-Prüfung, Markierung, Hashwert-Berechnung) metadaten-getrieben generierbar, weil sie strukturell pro Ziel-Tabelle nach demselben Muster funktionieren. Diese Generierung deckt den Korridor von Extraktion bis zur technischen Historisierung (Schema T2) ab. Ab Schema L1 — der strukturellen Transformation — sind die JOIN-Statements ziel-system-spezifisch und werden manuell entwickelt. Dasselbe gilt für die Historisierungs-Prozeduren für Schema L2 (siehe entsprechende Hinweise weiter unten).
Wie sich diese generischen Prüfungen konkret umsetzen lassen, zeigt Datenqualität mit SQL prüfen — ein konfigurierbares Framework, das die genannten Aufgaben über Metadaten-getriebene Prozeduren übernimmt.
Historisierung der technisch transformierten Daten
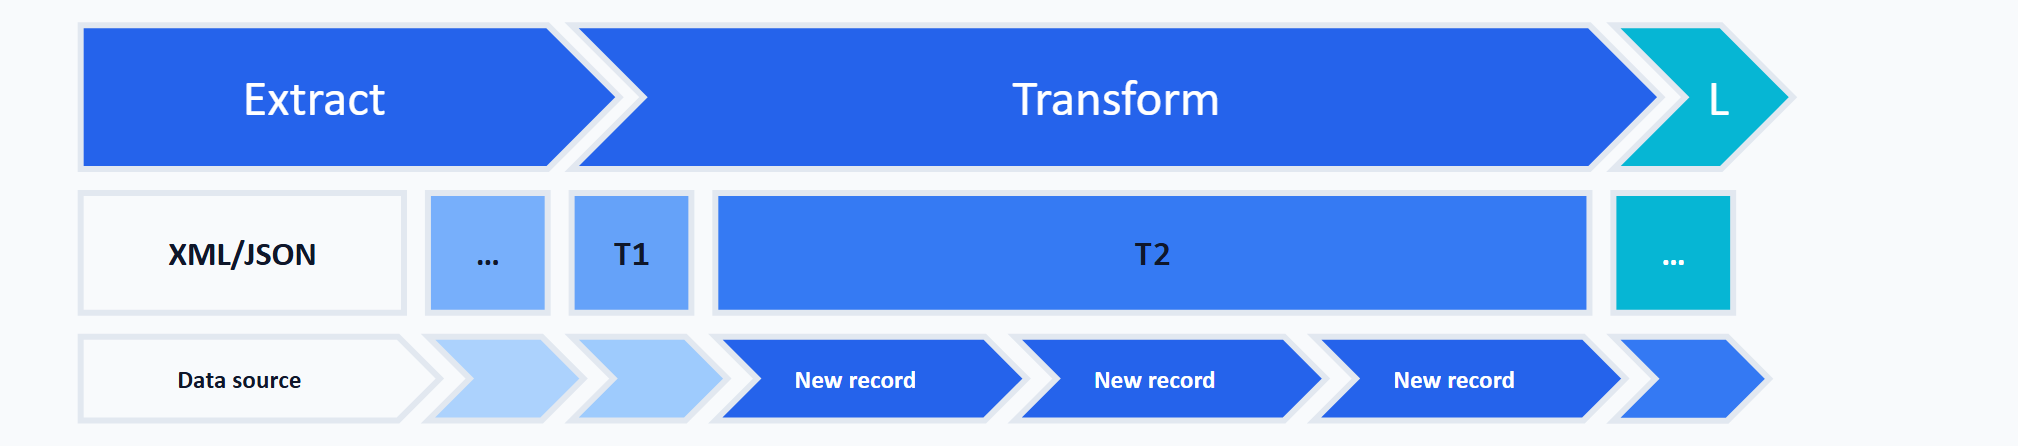
Die Historisierung umfasst die folgenden Arbeitsschritte:
- Historisierung
- Identifikation von Änderungsdaten
- Identifikation über Hashwerte
- Speicherung von Hashwerten
- Übernahme ausschließlich fehlerfreier Datensätze
Historisierung
Historisierung bedeutet, dass gelieferte Daten in einer Datenbank fortgeschrieben werden. Aus dem Bereich des Data-Warehousing sind unter dem Begriff Slowly Changing Dimensions verschiedene Typen der Historisierung bekannt, die festlegen, wie genau Daten fortgeschrieben werden können. Der Begriff Slowly Changing Dimensions ist auch unter der Kurzform SCD bekannt. Ralph Kimball beschreibt SCD-Techniken von Typ 0 bis Typ 7. Für dieses Pattern sind davon vor allem zwei relevant:
- SCD 1 — beschreibt dem Grunde nach keine echte Historisierung von Daten. Ein bereits zuvor geladener Datensatz wird mit einem geänderten Datensatz lediglich überschrieben. Es werden also immer nur die jeweils letzten Änderungen eines Datensatzes gespeichert.
- SCD 2 — bei einer relevanten Änderung wird eine neue Version des Datensatzes angelegt (Add New Row). Für die Umsetzung erhalten alle historisierten Tabellen hier zwei zusätzliche Spalten
valid_fromundvalid_till, in denen der Gültigkeitszeitraum des Datensatzes angegeben ist (sie entsprechen Kimballs row effective date und row expiration date). Die Intervalle sind halboffen —[valid_from, valid_till):valid_fromgehört zur Gültigkeit dazu,valid_tillmarkiert den Beginn der Folge-Version. Aktuell gültige Datensätze sind unbegrenzt gültig, was invalid_tilldurch einNULLangezeigt wird. Verbreitete Umsetzungsvarianten sind ein Hochdatum wie9999-12-31statt desNULLsowie ein zusätzliches Current-Flag. Werden zu einem aktuellen Datensatz Änderungsdaten geliefert, wird der zuletzt gültige Datensatz in der Spaltevalid_tillmit dem Datum, ab dem der Änderungsdatensatz gültig ist, aktualisiert und der Änderungsdatensatz wiederum mitvalid_till=NULLeingefügt.
Eine Historisierung ist optional. Hilfreich ist sie vor allem bei Delta-Loads, wenn Folgeobjekte auf unveränderte Stammdaten angewiesen sind — grundsätzlich erforderlich ist sie auch dort nicht. Angenommen, ein Kunde hat eine neue Bestellung getätigt. Bei einem Delta-Load wird die Bestellung geliefert, aber nicht der Kunde, da sich dieser nicht geändert hat. Eine Auflösung der Fremdschlüsselbeziehung zwischen Bestellung und Kunde kann mit den gelieferten Daten nicht erfolgen. Für eine Auflösung der Fremdschlüsselbeziehung zwischen Bestellung und Kunde sind entweder die Kundendaten aus dem Zielsystem zu extrahieren oder die Kunden sind in der Datenbank zu historisieren, damit bei folgenden Ausführungen des ETL-Prozesses der Kunde verfügbar ist.
Historisierung im Kontext des hier vorgestellten ETL-Prozesses bedeutet, dass nur fehlerfreie und geänderte Datensätze historisiert werden. Die Fortschreibung kann nach SCD 1 oder SCD 2 erfolgen — wobei SCD 1 keine historischen Versionen bewahrt, sondern nur den jeweils aktuellen Stand.
Identifikation von Änderungsdaten
Die Historisierung erfordert, dass sich Änderungsdatensätze im Quellsystem und in der Folge auch in den historisierten Tabellen erkennen lassen. Häufig stellt das Quellsystem keine oder nur unzureichende Informationen darüber bereit, wann ein Datensatz eingefügt, geändert oder gelöscht wurde. Wird zum Beispiel eine CSV-Datei aus einem manuell bearbeiteten Excel-Dokument erstellt, ist immer davon auszugehen, dass keine (belastbaren) Informationen über eine Änderung eines Datensatzes vorliegen. Vor diesem Hintergrund werden nach diesem Design Pattern Änderungsdaten immer über die Daten selbst ermittelt. Hierfür werden die bei der technischen Transformation berechneten Hashwerte verwendet.
Identifikation über Hashwerte
Im Abschnitt Technische Transformation wurden für fehlerfreie Datensätze zwei Hashwerte berechnet — einer über die Felder des fachlichen Schlüssels, einer über alle übrigen Felder. Der Grundgedanke: In T2 entsteht über die Läufe hinweg die vollständige Historie der gelieferten Daten, und jede neue Lieferung (Voll- wie Delta-Lieferung) wird gegen diese Historie analysiert. Vergleichsbestand ist dabei ausschließlich die jeweils aktuell gültige Version je fachlichem Schlüssel (bei SCD 2 die Zeilen mit valid_till = NULL), nicht die historischen Versionen. Neue, geänderte und auch gelöschte Datensätze werden durch den Vergleich der Hashwerte zwischen den technisch transformierten Daten (Schema T1) und der aktuell gültigen Version in den historisierten Daten (Schema T2) identifiziert:
| Hashwert (fachlicher Schlüssel) | Hashwert (Attribute) | Art der Änderung |
|---|---|---|
| in T1 und T2 vorhanden, gleich | gleich | Keine Änderung |
| in T1 und T2 vorhanden, gleich | ungleich | Datensatz wurde geändert |
| nur in T1 (extrahiert) | — | Neuer Datensatz |
| nur in T2 (historisiert) | — | Datensatz wurde gelöscht (setzt Voll-Lieferung voraus — siehe unten) |
Grenze der Lösch-Erkennung. Die vierte Zeile trägt nur bei einer Voll-Lieferung: Liefert jeder Lauf den kompletten Bestand, ist ein in T1 fehlender Datensatz tatsächlich gelöscht — die Löschungen ergeben sich als Differenz zwischen Lieferung und Historie. Bei einem Delta-Load bedeutet dasselbe Fehlen dagegen nur, dass der Datensatz nicht als Änderung geliefert wurde. Für Delta-Lieferungen sind deshalb zwei Fälle zu unterscheiden. Löscht das Quellsystem weich und liefert das Lösch-Flag mit, wird die Löschung wie jede andere Änderung verarbeitet und in T2 als gelöscht markiert. Löscht das Quellsystem dagegen physisch und liefert davon nichts mit, sind Löschungen aus den gelieferten Daten prinzipiell nicht erkennbar. Dieser Spezialfall braucht einen separaten Weg: einen periodischen Voll-Abgleich (der auch nur über die fachlichen Schlüssel laufen kann) oder, sofern das Quellsystem es anbietet, einen Änderungs-Feed wie CDC oder Change Tracking. Ein erkanntes Löschen wird bei SCD 2 umgesetzt, indem die aktuell gültige Version geschlossen (valid_till wird gesetzt) und als gelöscht markiert wird. Ob zusätzlich eine eigene Lösch-Version entsteht, ist eine separate Modellierungsentscheidung.
Speicherung von Hashwerten
Wird ein Datensatz in den historisierten Tabellen eingefügt, aktualisiert oder dort als gelöscht markiert, sind dort auch die Hashwerte des neuen, geänderten oder gelöschten Datensatzes zu speichern beziehungsweise zu aktualisieren. Hierdurch wird sichergestellt, dass die dort gespeicherten Hashwerte den Status quo in den Quellsystemen darstellen und jederzeit (in folgenden Ausführungen des ETL-Prozesses) eine Identifikation von Änderungsdatensätzen über die Hashwerte möglich ist.
Übernahme ausschließlich fehlerfreier Datensätze
Die Übernahme eines fehlerhaften Datensatzes und das spätere Laden dieses Datensatzes in das Zielsystem könnte einen Fehler verursachen und gegebenenfalls den gesamten ETL-Prozess zum Abbruch bringen. Es werden daher nur fehlerfreie Änderungsdatensätze aus den Tabellen des Schemas T1 in den Tabellen des Schemas T2 gespeichert.
Strukturelle Transformation
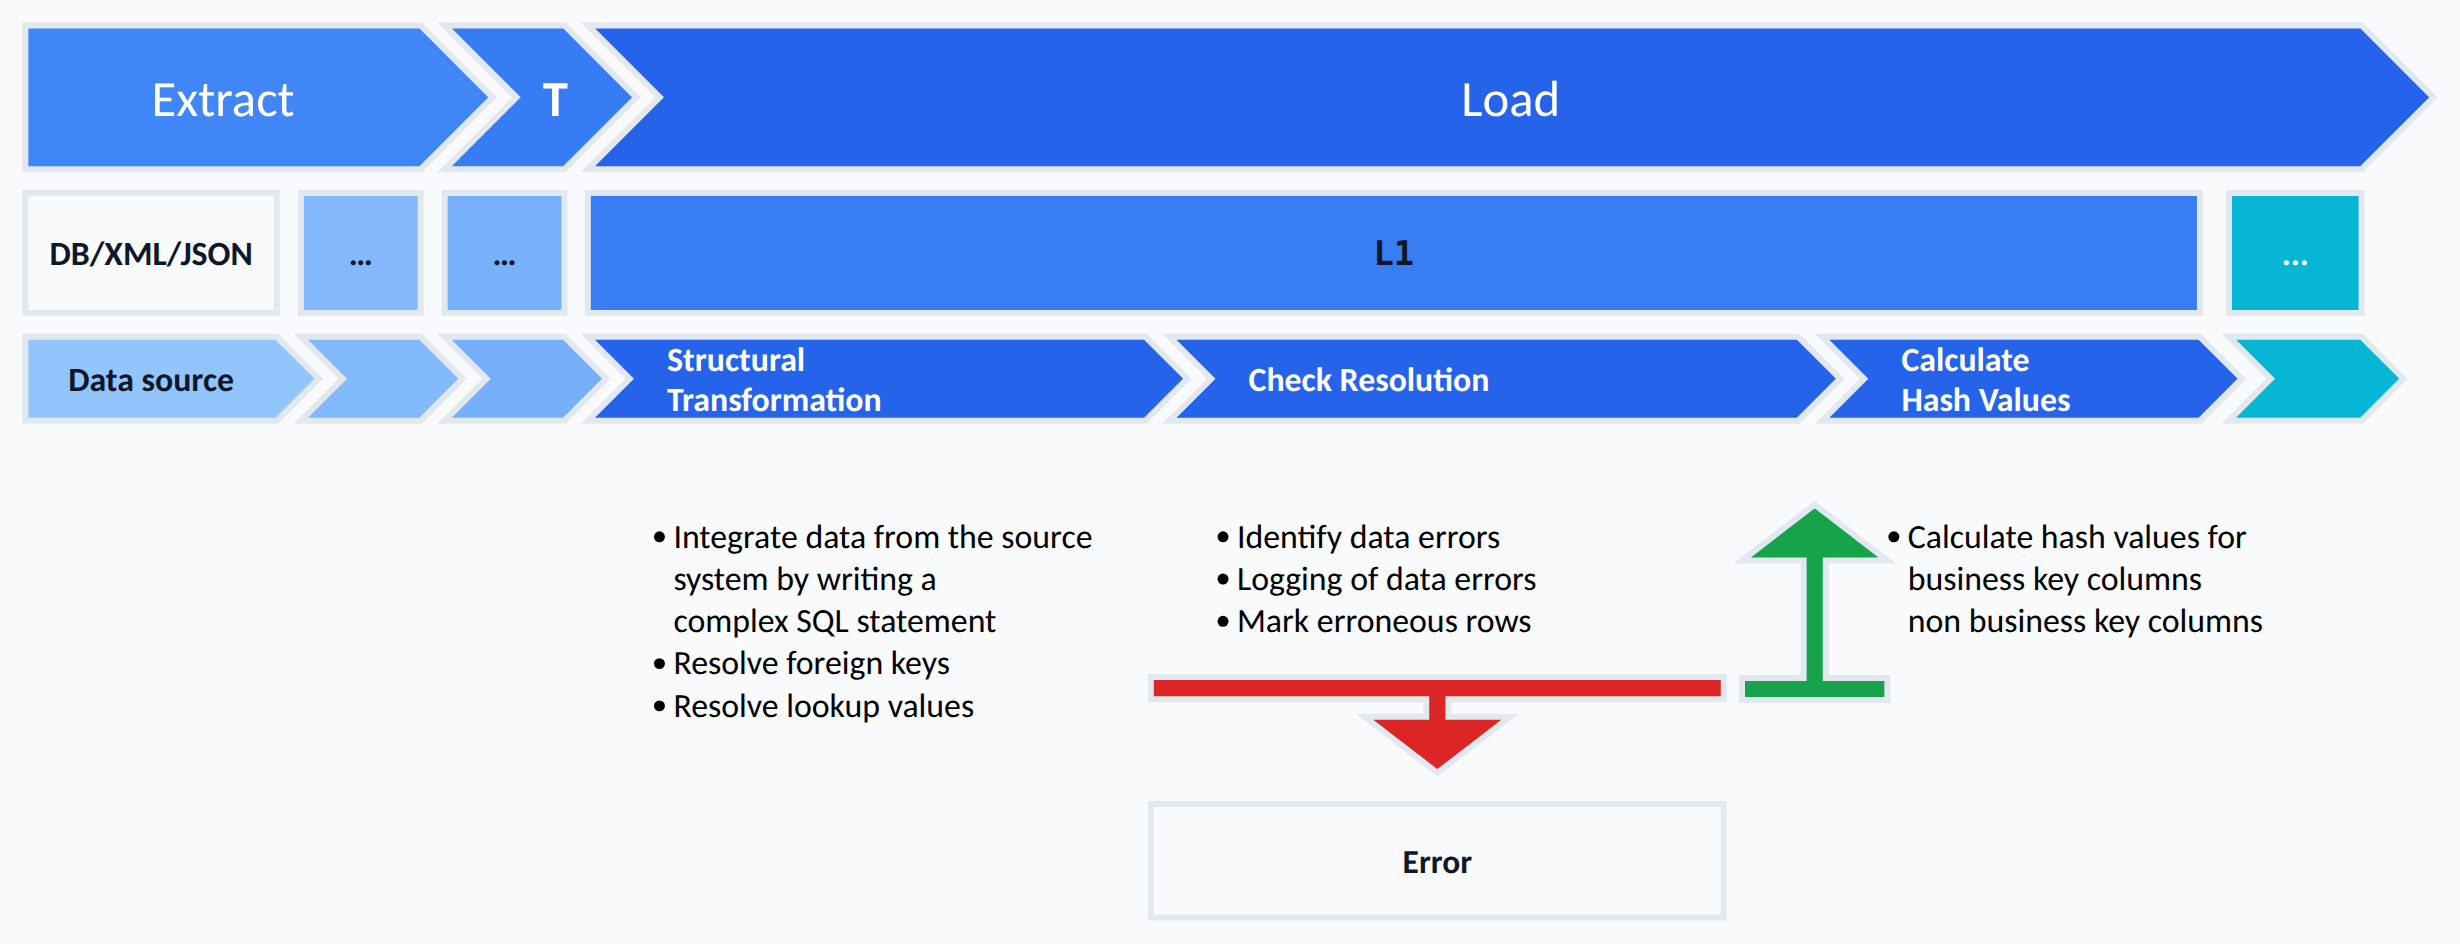
Die strukturelle Transformation umfasst die folgenden Arbeitsschritte:
- Strukturelle Transformation und Auflösung von Fremdschlüsselbeziehungen und Lookup-Werten
- Prüfung der strukturellen Datenqualität
- Protokollierung von Datenfehlern
- Markierung fehlerhafter Datensätze
- Berechnung von Hashwerten
Strukturelle Transformation und Auflösung von Fremdschlüsselbeziehungen und Lookup-Werten
Als Ergebnis der strukturellen Transformation liegen die Daten in Tabellenstrukturen vor, wie sie im Zielsystem erwartet werden. SQL-Statements mit den erforderlichen JOINs in der FROM-Klausel übernehmen die strukturelle Transformation. Die Entwicklung erfordert hinreichende Kenntnis über die Daten, die Zusammenhänge und vor allem Fremdschlüsselbeziehungen zwischen den Tabellen in einem Quellsystem beziehungsweise den zu integrierenden Quellsystemen.
Neben der eigentlichen strukturellen Transformation der Quelldaten löst die strukturelle Transformation Fremdschlüsselbeziehungen für das Zielsystem auf und ermittelt zu Lookup-Werten den zu speichernden Code. Das Ergebnis der strukturellen Transformation wird in Tabellen des Schemas L1 gespeichert, die bezüglich Tabellenstruktur, Spaltennamen und Datentypen ähnlich zu den Strukturen des Zielsystems sind.
Prüfung der strukturellen Datenqualität
Nach der strukturellen Transformation wird geprüft, ob Fremdschlüsselbeziehungen und Lookup-Werte erfolgreich aufgelöst werden konnten. Kann zu einem Datensatz kein Fremdschlüssel oder kein Lookup-Code ermittelt werden, gilt der Datensatz als fehlerhaft. Da diese Prüfung das Ergebnis der strukturellen Transformation betrifft, wird sie hier als Prüfung der strukturellen Datenqualität bezeichnet.
Protokollierung von Datenfehlern
Gefundene Datenfehler werden in einer les- und auswertbaren Form in einer Fehlertabelle protokolliert.
Markierung fehlerhafter Datensätze
Enthält ein Datensatz mindestens einen Fehler, wird dieser Datensatz als fehlerhaft markiert, damit er von der weiteren Verarbeitung ausgeschlossen werden kann. Die Markierung erfolgt in einer Spalte, in der die Anzahl der gefundenen Fehler gespeichert wird. Fehlerfreie Datensätze weisen in dieser Spalte ein NULL auf.
Berechnung von Hashwerten
Der letzte Arbeitsschritt der strukturellen Transformation ist die Berechnung von zwei Hashwerten je Datensatz. Der erste Hashwert repräsentiert die Felder des fachlichen Schlüssels eines strukturell transformierten Datensatzes, der zweite Hashwert alle übrigen Attribut-Felder. Über diese beiden Hashwerte können im nachfolgenden Arbeitspaket Historisierung der strukturell transformierten Daten Änderungsdatensätze leicht identifiziert werden.
Historisierung der strukturell transformierten Daten
Die Historisierung der strukturell transformierten Daten umfasst die gleichen Arbeitsschritte wie die Historisierung der technisch transformierten Daten. Die Historisierung der strukturell transformierten Daten ist ein optionaler Schritt, da diese — wenn die Daten der technischen Transformation historisiert wurden — jederzeit über die strukturelle Transformation wiederhergestellt werden können.
Die strukturell transformierten Daten aus den Tabellen des Schemas L1 werden in den Tabellen des Schemas L2 historisiert. Die Vorgehensweise ist identisch mit der Historisierung der Daten aus dem Schema T1 in den Tabellen des Schemas T2. Es werden nur fehlerfreie Änderungsdatensätze aus den Tabellen des Schemas L1 in den Tabellen des Schemas L2 historisiert. Neue, geänderte und gelöschte Datensätze werden zusätzlich mit einem Flag versehen, das anzeigt, dass diese noch in das Zielsystem zu übernehmen sind. Werden auch die Daten des Schemas L2 historisiert, sind diese nie zu löschen und sollten über einen Wartungsprozess gesichert werden. Damit lässt sich nachvollziehen, wann der ETL-Prozess welche Änderung verarbeitet hat. Der tatsächliche Änderungszeitpunkt im Quellsystem ist daraus nur ablesbar, wenn die Quelle entsprechende Metadaten mitliefert.
Die erforderlichen Prozeduren für die Historisierung von Daten in den Tabellen des Schemas L2 sind manuell zu entwickeln.
Laden
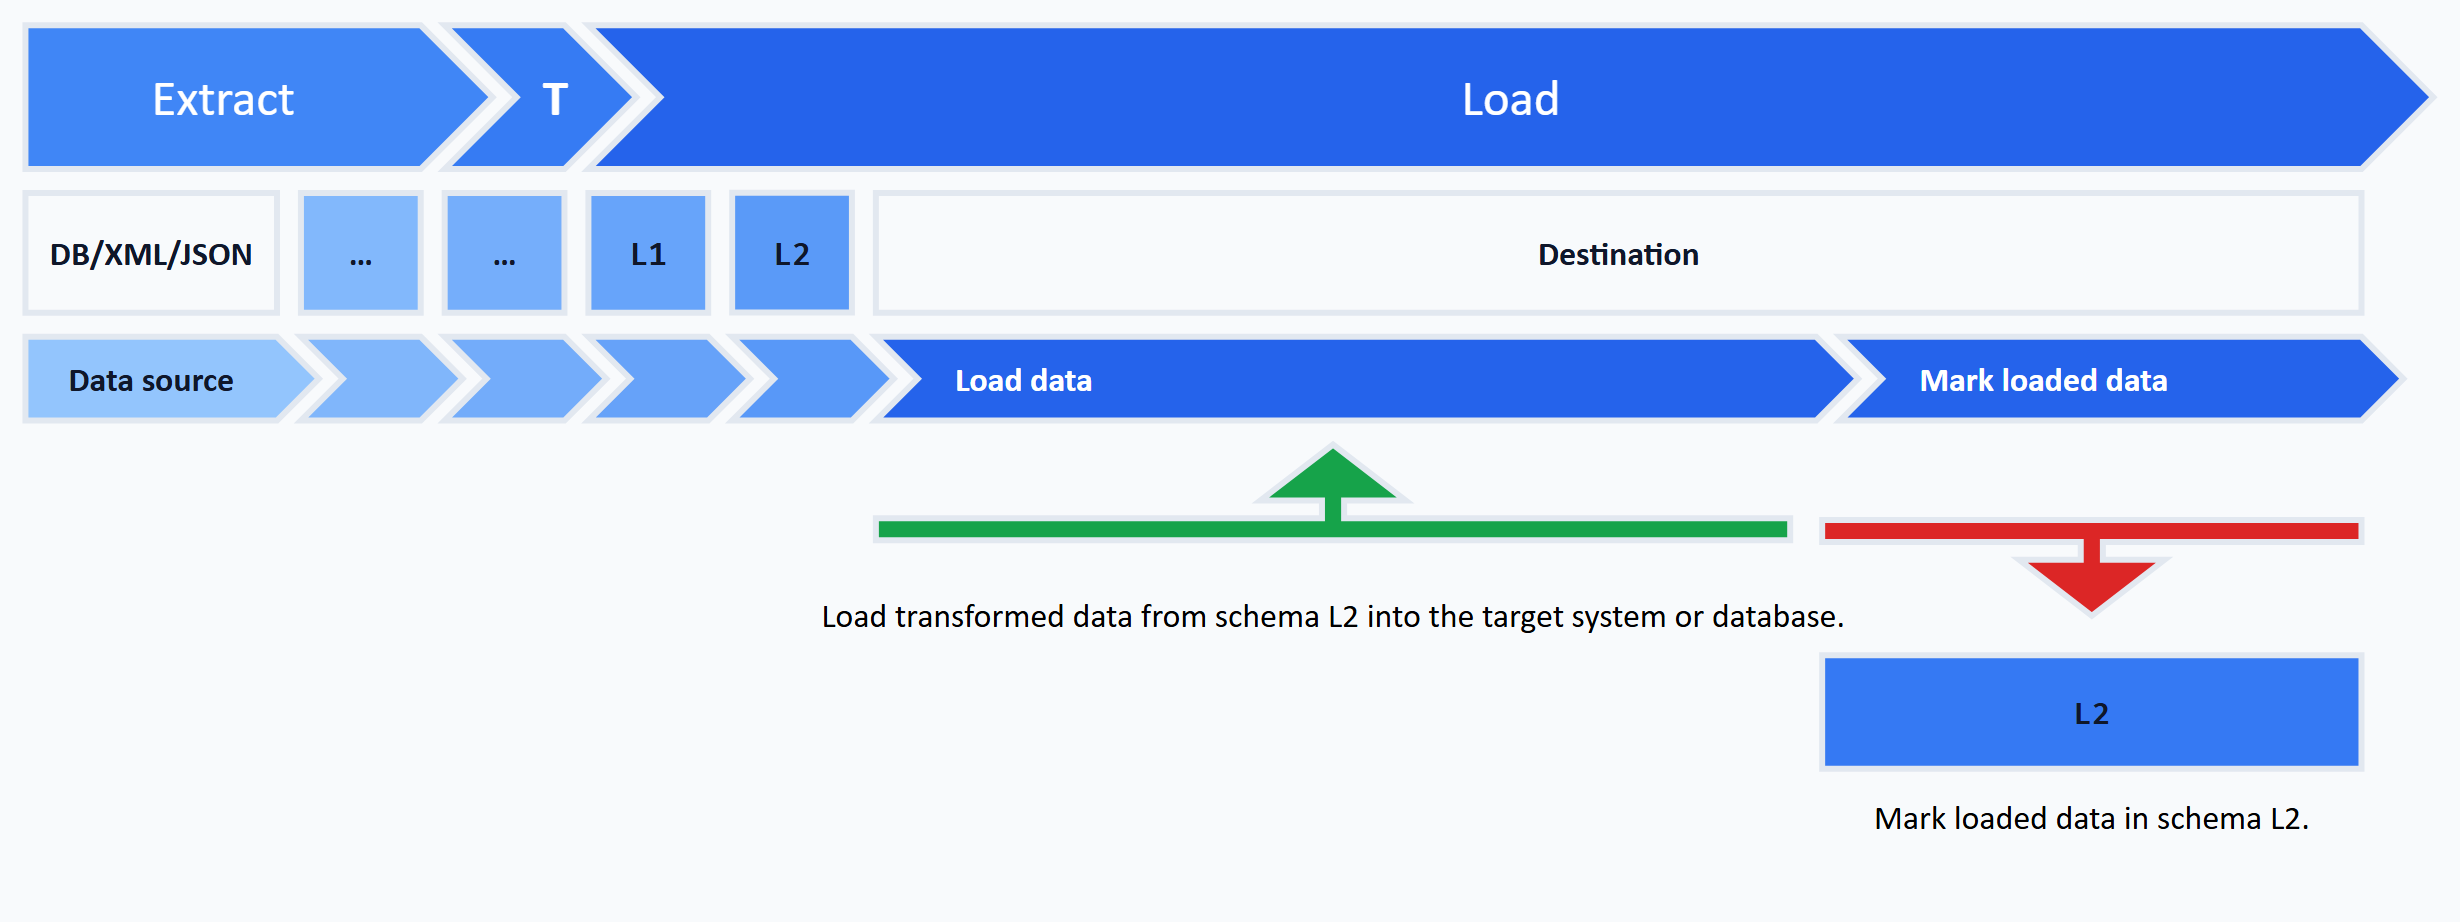
Die transformierten und geprüften Daten aus dem Schema L2 können nun mit einer Technologie der Wahl in das Zielsystem geladen werden. Ist die Historisierung in L2 nicht aktiviert, erfolgt das Laden direkt aus dem Schema L1. Beim Laden aus L2 können die zu ladenden Änderungsdaten über ein Flag, das angibt, ob der Datensatz bereits in das Zielsystem geladen wurde oder nicht, identifiziert werden. Datensätze, die erfolgreich in das Zielsystem geladen wurden, sind entsprechend zu markieren.
Fazit
Am Ende steht die Grundregel, die sich durch alle Arbeitspakete zieht: Jedes Arbeitspaket hat ein eigenes Schema, prüft die Datenqualität an seiner Grenze und reicht nur fehlerfreie Datensätze weiter. Schlechte Daten bleiben dort isoliert, wo sie erkannt wurden — samt Protokoll, das die Fehlersuche auf konkrete Datensätze eingrenzt. Ein einzelner nicht konvertierbarer Wert muss den ETL-Lauf damit nicht mehr zum Abbruch bringen.
Die Schichtung E0 bis L2 ist dabei ein Baukasten, kein Dogma. Wer keine Historisierung braucht, lässt T2 und L2 weg. Wer Speicher sparen muss, setzt einzelne Schichten als Views um (zu den Trade-offs siehe FAQ). Faktisch arbeitet das Muster als persistentes Staging: Die wesentlichen Transformationen laufen in der Datenbank. Die Implementierungs-Ebene unter dieser Architektur zeigt der Artikel Datenqualität mit SQL prüfen. Die Einordnung des Musters zwischen ETL und ELT übernimmt ETL vs. ELT — woran du erkennst, welches Muster du wirklich gebaut hast.
Seine Grenzen hat das Pattern dort, wo Persistenz pro Arbeitspaket nicht trägt: bei Streaming- und Low-Latency-Anforderungen, bei extremen Datenvolumina ohne entsprechenden Storage und bei einfachen Einweg-Pipelines ohne Reprocessing- und Audit-Bedarf.
FAQ
Die technische Transformation arbeitet pro Datensatz isoliert: Typ-Konvertierung von Eingangswerten in die Zieldatentypen (Text → date, decimal, …) plus eine erste Datenqualitäts-Prüfung auf Wert-Ebene, jeweils ohne Blick auf andere Tabellen. Die strukturelle Transformation braucht dagegen Kontext aus dem Zielsystem — Fremdschlüssel auflösen, Lookup-Werte aus Code-Mappings ableiten — und erfolgt deshalb in einem eigenen Arbeitspaket nach der technischen Transformation. Die Trennung erlaubt, beide Fehler-Klassen getrennt zu protokollieren und zu reparieren.
Materialisierung — das Wegspeichern des Arbeitspaket-Ergebnisses in einer Datenbank-Tabelle — entkoppelt drei Dinge: Das Quellsystem wird nur einmal gelesen und bleibt von den Folgepaketen unberührt. Jeder Schritt lässt sich nachträglich neu starten, ohne den kompletten ETL-Lauf zu wiederholen. Und es entsteht ein nachvollziehbarer Audit-Trail für die Fehlersuche an konkreten Datensätzen. Der zusätzliche Speicher- und I/O-Aufwand ist real und wächst mit dem Datenvolumen. Er ist der Preis für Wiederanlaufbarkeit, Auditierbarkeit und Fehlersuche — in den typischen Einsatz-Szenarien dieses Patterns (Migrations- und Integrationsprojekte) ein lohnender Tausch. Bei großen Volumina gehört er bewusst abgewogen (siehe die nächste Frage zu den Persistenz-Layern).
Nicht zwingend. Die volle E0/E1/T1/T2/L1/L2-Schichtung lohnt sich vor allem dort, wo Audit-Trail, Wiederanlaufbarkeit pro Arbeitspaket und nachträgliche Fehleranalyse harte Anforderungen sind — klassisch in Migrations- und CRM-Integrations-Projekten mit Datenvolumen im niedrigen bis mittleren Bereich. Bei großen Datenvolumen oder modernen Plattformen wie Snowflake, Databricks oder BigQuery werden einige Zwischen-Layer oft als Views statt als materialisierte Tabellen umgesetzt — die Architektur-Logik bleibt gleich, der Speicher- und I/O-Aufwand sinkt, dafür fallen die Transformationskosten bei jedem Zugriff erneut an. Erfahrungswert: L1 ist der erste Kandidat zum Virtualisieren, weil es sich aus den historisierten Daten des Schemas T2 jederzeit regenerieren lässt. L2 kommt nur infrage, wenn auf seine Lade-Flags und die eigene Historie verzichtet wird. T2 selbst bleibt materialisiert, denn eine Historie lässt sich aus einem aktuellen Snapshot nicht rekonstruieren.
Historisierung ist primär eine fachliche Anforderung: Sie wird gebraucht, wenn Zustandsverläufe, historische Auswertungen oder reproduzierbare Stände gefordert sind — unabhängig vom Load-Typ. Bei Delta-Loads kommt ein technischer Nutzen hinzu: Dort wird der Bestellungs-Datensatz geliefert, aber nicht der dazugehörige Kunde, falls er sich nicht geändert hat. Ohne historisierte Kundendaten lässt sich die Fremdschlüssel-Beziehung dann nicht auflösen. Bei vollständigen Snapshot-Loads ohne fachliche Historien-Anforderung ist SCD dagegen verzichtbar.
Die zentralen Konzepte des Patterns — Arbeitspakete, Schema-Schichtung E0–L2, Datenqualität an den Grenzen, Hash-basierte SCD — sind nicht an SQL Server gebunden und lassen sich in jeder relationalen Datenbank umsetzen. Der hier vorgestellte Technologie-Stack ist allerdings durchgängig SQL-Server-zentriert (SSIS, OPENXML, OPENJSON, HASHBYTES, metadaten-getriebene Prozedur-Generierung). Für Postgres sind die wichtigsten Pendants: xmltable() für XML, jsonb_to_recordset() bzw. JSON_TABLE (seit PostgreSQL 17) für JSON, digest(…, 'sha256') aus pgcrypto für Hashes. Für den Bulk-Import in die Staging-Tabellen bietet Postgres COPY (die Orchestrierung eines SSIS ersetzt es nicht), das Laden ins Ziel lässt sich mit MERGE abbilden. Die strukturelle Anpassung kann tiefer gehen als nur Funktionsnamen — etwa lässt sich das E0/E1-Splitting für XML/JSON in Postgres oft einsparen, weil xmltable() direkt aus dem Source-Read heraus extrahiert. Ob der Raw-Layer E0 entfällt, bleibt dabei eine Abwägung zwischen Speicherbedarf und Reproduzierbarkeit.
Es gibt konzeptionelle Parallelen — fachlicher Schlüssel, Hash-basierte Delta-Erkennung, persistente Schichten, Auditierbarkeit. Eine Data-Vault-Modellierung implementiert das Pattern aber nicht: Es gibt keine Hubs, Links oder Satellites mit ihren Modellierungsregeln, keine Pflicht zur Insert-Only-Historie und keine Raw-Vault-vs.-Business-Vault-Trennung. Für klassische Migrations- und CRM-Integrations-Projekte mit Audit-Anforderung ist das leichtere Pattern pragmatisch. Für reine DWH-Bewirtschaftung mit Multi-Source-Integration lohnt sich ein Blick auf Data Vault 2.0.
Verwandte Artikel
Vorgelagert:
- Datenqualität in einem ETL-Prozess — Serien-Wurzel.
- Datenqualität // Grundlagen der Typ-Konvertierung mit T-SQL — Grundlagen-Artikel zu
TRY_CONVERT.
Implementierungs-Ebene:
- Datenqualität mit SQL prüfen — ein konfigurierbares Framework — schlechte Daten generisch aufspüren und nach Schweregrad klassifizieren.
- Design Pattern // Sichere Typ-Konvertierung mit T-SQL —
fn_try_convert_*-UDFs für die technische Transformation. - Design Pattern // Protokollierung eines ETL-Prozesses mit SQL — Cluster-Schwester zur Protokollierungs-Schicht.
Einordnung:
- ETL vs. ELT — woran du erkennst, welches Muster du wirklich gebaut hast — ordnet die hier vorgestellte Architektur als persistent-staging-ELT ein.