Ein Klick auf „Schema aktualisieren“, und nach 60 Sekunden zeigt der Browser die Fehlermeldung 504 Gateway Timeout, weil der vorgeschaltete Webserver nicht länger auf eine Antwort wartet. Auf dem Server läuft die Arbeit ungestört weiter, nur sieht das niemand. Also folgt der zweite Klick, dann der dritte, und kurz darauf rechnen vier Läufe gleichzeitig. Ein einzelner Lauf über 1000 Tabellen dauerte gemessen 114 Sekunden. Verlangt waren weniger als drei Sekunden.
Die Ursache war keine langsame Abfrage, sondern eine Schleife, die für jede Tabelle einzeln die Quell-Datenbank befragte und das Ergebnis einzeln speicherte. Dieser Artikel beschreibt, wie diese Schleife vermessen und durch set-basierte Anweisungen ersetzt wurde, also durch Anweisungen, die alle 1000 Tabellen auf einmal lesen und schreiben, und welche Optionen dabei gegeneinander standen. Er beschreibt auch, was dabei schiefging. Die erste dieser Anweisungen war langsamer als 1000 Einzel-Abfragen zusammen, und das fertige Ergebnis hat seine Zielwerte trotz eines Gewinns um den Faktor 9 bis 19 verfehlt.
Das Wichtigste vorab:
- Eine Schleife im Anwendungs-Code kostet pro Durchlauf mehr als dieselbe Schleife in der Datenbank: Wer Tabellen einzeln abarbeitet statt mit einer Anweisung über alle, bezahlt für jeden Durchlauf einen festen Aufwand, ganz gleich, wie wenig Daten der Durchlauf bewegt. Liegt die Schleife im Anwendungs-Code und öffnet für jede Tabelle eine eigene Verbindung zur Datenbank, kommen Verbindungsaufbau, Anmeldung und Transaktion pro Durchlauf hinzu. Im beschriebenen Fall kostete ein Durchlauf rund 114 Millisekunden, für alle 1000 Tabellen zusammen also die eingangs genannten 114 Sekunden. Dieselbe Schleife, für diesen Artikel als Prozedur innerhalb von Postgres nachgebaut, kostete rund drei Millisekunden pro Tabelle und damit rund drei Sekunden für dieselben 1000 Tabellen.
- Die Schleife war keine Nachlässigkeit, und ihre Stärken mussten nachgebaut werden: Sie rief für jede Tabelle eine Funktion auf, die es für das Aktivieren einer einzelnen Tabelle schon gab und die dort korrekt arbeitete. Scheiterte eine Tabelle, liefen die übrigen weiter, und selbst vier gleichzeitige Läufe hinterließen keinen widersprüchlichen Datenbestand. Bei den 15 bis 70 Tabellen, die die realen Datenbanken dieser Anwendung haben, fiel die Laufzeit nie auf. Die Lösung, die alle Tabellen auf einmal verarbeitet, musste diese Fehler-Isolation ausdrücklich wiederherstellen.
- Eine Anweisung über alle Tabellen ist nicht automatisch schneller als tausend einzelne: Die erste Abfrage, die die Schlüssel aller 1000 Tabellen auf einmal aus
information_schemalas, den Sichten, in denen Postgres seine eigenen Metadaten bereitstellt, brauchte auf Postgres 17 rund fünf Sekunden. Wird dieselbe Abfrage für jede Tabelle einzeln abgesetzt, kommt die Summe hochgerechnet auf eine halbe Sekunde. Der Ausführungsplan zeigte den Grund: Postgres 17 hatte für diese Abfrage einen Plan gewählt, der eine der beiden beteiligten Sichten für jede Tabelle erneut auswertete, und damit die Schleife intern nachgebaut. Eine Abfrage direkt auf die Systemtabellen inpg_catalogdahinter dauerte Millisekunden, zeigte aber jedem Datenbank-Benutzer auch die Schlüssel von Tabellen, die er gar nicht lesen darf, und brauchte deshalb eine eigene Bedingung für die Zugriffsrechte. - Aus 114 Sekunden wurden 12, und die Zielwerte wurden trotzdem verfehlt: Diese zwölf Sekunden gelten für einen Lauf, der alle 1000 Tabellen neu schreibt. Der häufigere Fall ist der Lauf über einen unveränderten Bestand, und für ihn stand ein Zielwert von drei Sekunden, der drei Millisekunden pro Tabelle zulässt. Die neue Logik braucht rund 3,7 Millisekunden pro Tabelle und liegt damit ein knappes Viertel über dem Budget. Über 1000 Tabellen sind das 3,7 Sekunden. Der Lauf dauert trotzdem bis zu 6,4 Sekunden. Verfehlt wurde das Ziel an einer anderen Stelle, denn die fehlenden 2,7 Sekunden kostet jeder Aufruf auf dem geteilten Server, bevor er die erste Tabelle anfasst, unter anderem für Anmeldung, Berechtigungsprüfung und das Lesen der Tabellen-Auswahl. Neben 114 Sekunden Schleife war dieser Anteil nie aufgefallen, und in der Schätzung vor dem Umbau kam er nicht vor.
Voraussetzung: SQL-Grundkenntnisse und eine Vorstellung davon, was eine gespeicherte Prozedur ist. Die Beispiele sind PL/pgSQL und wurden auf Postgres 17 und 18 in Wegwerf-Containern ausgeführt. Der beschriebene Fall stammt aus einer Anwendung in TypeScript, deren Code hier nicht gezeigt wird, weil die Mechanik von der Programmiersprache unabhängig ist.
Inhalt
- Die Ausgangslage: ein Schema-Snapshot über 1000 Tabellen
- Laufzeit messen, wenn der Webserver-Timeout greift
- Wo die 114 Sekunden stecken
- Dieselbe Schleife in der Datenbank
- Was für die Schleife sprach
- Was gegen die Schleife sprach und was die Umstellung kostet
- Die Entscheidung: vier Optionen und eine Budget-Rechnung
- Set-basiert heißt nicht automatisch schnell: warum eine Mengen-Abfrage langsamer sein kann
- Die Rechte-Falle beim Wechsel auf pg_catalog
- Das Ergebnis: Faktor 9 bis 19, Zielwerte verfehlt
- Wenn eine Optimierung die Bedeutung einer Anzeige ändert
- Was davon bleibt
- FAQ
- Verwandte Artikel
Die Ausgangslage: ein Schema-Snapshot über 1000 Tabellen
Das private Projekt DI² erzeugt ETL-Strecken aus den Metadaten einer Quell-Datenbank. Damit es weiß, womit es arbeitet, liest es für jede aktivierte Tabelle die Spalten, die Primär- und Unique-Schlüssel sowie die Fremdschlüssel und legt sie als Snapshot in der eigenen Datenbank ab. Ein Klick auf „Schema aktualisieren“ wiederholt diese Lesung für alle Tabellen einer Verbindung.
Diese Aktualisierung, im Folgenden kurz Refresh, war als Schleife umgesetzt. Für jede Tabelle rief der Anwendungs-Code eine Funktion auf, die es bereits gab. Sie las die Metadaten einer einzelnen Tabelle aus der Quelle und ersetzte deren Snapshot in einer Transaktion, indem sie die alten Zeilen löschte und die neuen einfügte. Die Funktion war für einen anderen Anlass entstanden, das Aktivieren einer einzelnen Tabelle, und für diesen Anlass war sie korrekt. Die Schleife darüber war der naheliegende nächste Schritt.
In der Spezifikation stand seit Monaten ein Zielwert für den Refresh: weniger als drei Sekunden bei 1000 Tabellen. Gemessen hatte das niemand, weil die realen Datenbanken im Projekt zwischen 15 und 70 Tabellen hatten. Die Messung wurde mit einer synthetischen Quell-Datenbank aus 1000 Tabellen mit je 50 Spalten nachgeholt. Die Tabellen waren leer, denn der Refresh liest ausschließlich den Katalog, also die Sichten und Systemtabellen, in denen Postgres beschreibt, welche Tabellen, Spalten und Schlüssel es gibt. Gemessen wurde auf dem Entwicklungs-Server des Projekts, einer geteilten Maschine mit vier virtuellen Kernen und 7,6 Gigabyte Arbeitsspeicher.
Messung, Code-Analyse und Umbau sind mit einem Coding-Agenten entstanden, der auch den Anwendungs-Code geschrieben hat. Die Abwägungen und Entscheidungen, von denen dieser Artikel erzählt, hat der Maintainer getroffen. Wie diese Arbeitsteilung im Alltag aussieht, beschreibt der Artikel Agentic Coding aus Anwender-Sicht.
Das Ergebnis der Messung:
| Messgröße | Wert |
|---|---|
| Dauer der Schleife, einzelner Lauf ohne parallele Läufe | 114,4 s |
| Abweichung zwischen zwei Läufen | 6 ms |
| Dauer pro Tabelle | rund 114 ms |
| Tabellen-Liste lesen, der einzige set-basierte Schritt | 22 bis 43 ms |
| Zielwert | unter 3 s, verfehlt um den Faktor 38 |
Im Browser kam von diesem Ergebnis nichts an. Der vorgeschaltete Webserver beendete die Anfrage nach 60 Sekunden mit einem Gateway-Timeout, während die Schleife auf dem Server weiterlief. Wer daraufhin erneut klickte, startete einen zweiten Lauf neben dem ersten. In der Messsitzung liefen so bis zu vier Schleifen gleichzeitig, und eine davon lieferte ihre Antwort erst nach etwa sieben Minuten.
Laufzeit messen, wenn der Webserver-Timeout greift
Weil der Timeout jede Messung im Browser abbrach, musste die Dauer aus den Daten selbst kommen. Der Refresh ersetzt den Snapshot jeder Tabelle, und jede neu geschriebene Zeile erhält einen Zeitstempel in created_on. Nach einem Lauf ohne parallele Läufe liefert die Spanne zwischen der ersten und der letzten geschriebenen Zeile deshalb die Dauer der Schleife bis auf etwa einen Durchlauf, denn der Zeitstempel hält den Beginn eines Durchlaufs fest und nicht sein Ende. Die Abfrage dafür kommt ohne jede Instrumentierung aus:
  1: SELECT
  2:     count(DISTINCT table_name)        AS table_count
  3:    ,min(created_on)                   AS first_row
  4:    ,max(created_on)                   AS last_row
  5:    ,max(created_on) - min(created_on) AS duration
  6: FROM
  7:    meta.column_snapshot
  8: WHERE
  9:    schema_name = 'perf';
Diese Rechnung hat eine Voraussetzung, die leicht übersehen wird. Ein Default wie now() liefert in Postgres den Zeitpunkt, an dem die laufende Transaktion begonnen hat, und nicht den Zeitpunkt des Einfügens. In der Fallstudie lief jede Tabelle in einer eigenen Transaktion, also bekam jede Tabelle ihren eigenen Zeitstempel. Schreibt eine Prozedur dagegen alle Tabellen in einer einzigen Transaktion, steht in jeder Zeile derselbe Wert, und die Spanne ist null. Ein Nachbau der Schleife als Postgres-Prozedur, den der Abschnitt „Dieselbe Schleife in der Datenbank“ zeigt, hat genau das bestätigt. Mit einem COMMIT pro Tabelle ergab die Abfrage die Dauer der Schleife, 5 Millisekunden weniger als die Stoppuhr des Aufrufs, das ist der letzte Durchlauf, dessen Ende kein Zeitstempel mehr erfasst, ohne COMMIT ergab sie 00:00:00. Wer den Zeitpunkt jeder einzelnen Zeile braucht, setzt clock_timestamp() als Default. statement_timestamp() hilft dabei nicht, denn es liefert den Beginn der Anweisung, die der Client geschickt hat, und das ist für die ganze Prozedur der CALL.
Zwei unabhängige Läufe ergaben 114,439 und 114,445 Sekunden und lagen damit praktisch gleich. Für eine Aussage über die Verteilung wären mehr Läufe nötig gewesen, für die Suche nach der Ursache genügte die Größenordnung. Nach dem Umbau misst die Anwendung ihre Dauer selbst und schreibt sie in das Audit-Protokoll, sodass der Umweg über die Zeitstempel nicht mehr nötig ist. Diese Instrumentierung war selbst eine der Konsequenzen der Analyse. Warum eine Abfrage auf den Datenbestand oft schneller zu einem Befund führt als das Klicken in der Oberfläche, zeigt der Artikel Der Agent misst, wo der Mensch klickt.
Wo die 114 Sekunden stecken
Pro Tabelle fielen nacheinander an:
- Drei Verbindungen zur Quell-Datenbank: Der Code öffnete je eine Verbindung für Spalten, Schlüssel und Fremdschlüssel. Vor jeder dieser Verbindungen lud er das Verbindungsprofil aus der eigenen Datenbank und entschlüsselte das Passwort. Danach baute er eine frische TCP-Verbindung auf, meldete sich an, setzte eine einzige Katalog-Abfrage für genau diese Tabelle ab und schloss die Verbindung wieder. Bei 1000 Tabellen sind das 3000 Verbindungsaufbauten pro Refresh.
- Bis zu vier Prozedur-Aufrufe in der eigenen Datenbank: Nacheinander wurden der Spalten-Snapshot ersetzt, die abgeleiteten Prüfregeln abgeglichen, der Schlüssel-Snapshot ersetzt und der Fremdschlüssel-Snapshot ersetzt.
Die Quell-Datenbank lief auf derselben Maschine, und das Netzwerk zwischen den Containern kostet weniger als eine Millisekunde. Die 114 Millisekunden pro Tabelle bestanden damit fast vollständig aus Kosten, die jede Iteration unabhängig von der Datenmenge bezahlt. Wie sie sich genau auf Verbindung, Profil und Prozedur-Aufrufe verteilen, hat die Messung nicht erhoben. Eine Größenordnung liefert eine separate Messung mit pgbench zwischen zwei Containern. Dort kostete ein Verbindungsaufbau mit Passwort-Anmeldung im Schnitt 17 Millisekunden, eine einfache Abfrage über eine bestehende Verbindung dagegen 0,36 Millisekunden. Postgres startet für jede neue Verbindung einen eigenen Serverprozess, und genau dieser Aufwand fiel in der Schleife dreimal pro Tabelle an. Drei Verbindungsaufbauten erklären damit rund 50 der 114 Millisekunden, der Rest verteilt sich auf das Laden und Entschlüsseln des Profils und die vier Prozedur-Aufrufe.
Den Gegenbeleg liefert der einzige Schritt des Refreshs, der schon set-basiert war, der seine Frage also in einer einzigen Anweisung für alle Tabellen stellte statt einmal pro Tabelle. Die Liste aller 1000 Tabellen kam in 22 bis 43 Millisekunden zurück, das sind weniger als 0,04 Prozent der Gesamtzeit.
Aus dem Zielwert lässt sich außerdem ein Budget rechnen, und diese Rechnung entscheidet die Frage früher als jeder Optimierungsversuch. Drei Sekunden für 1000 Tabellen ergeben drei Millisekunden pro Tabelle. Schon ein einziger Verbindungsaufbau kostet ein Vielfaches davon. Solange jede Iteration eine Verbindung öffnet, ist der Zielwert also nicht erreichbar, egal wie schnell die Abfragen darin sind.
Dieselbe Schleife in der Datenbank
Die Fallstudie spielt im Anwendungs-Code, das Muster ist aber dasselbe wie bei einem Cursor in einer Prozedur, der eine Ergebnismenge Zeile für Zeile abarbeitet. Unter SQL-Entwicklern trägt es den spöttischen Namen RBAR, kurz für „Row By Agonizing Row“. In der Welt der ORMs ist es als N+1-Problem bekannt: erst eine Abfrage für die Liste, danach eine weitere für jedes Element. Um zu sehen, welcher Teil der Kosten an der Schleife selbst hängt und welcher an den Verbindungen, wurde der Snapshot für diesen Artikel innerhalb von Postgres nachgebaut. Gelesen wird aus information_schema, dem standardisierten Satz von Sichten, über den die meisten SQL-Datenbanken ihre Tabellen und Spalten beschreiben. Die Zieltabelle nimmt pro Spalte eine Zeile auf:
  1: CREATE SCHEMA IF NOT EXISTS meta;
  2:
  3: CREATE TABLE meta.column_snapshot
  4: (
  5:     schema_name               text          NOT NULL
  6:    ,table_name                text          NOT NULL
  7:    ,column_name               text          NOT NULL
  8:    ,data_type                 text          NOT NULL
  9:    ,ordinal_position          int           NOT NULL
 10:    ,created_on                timestamptz   NOT NULL DEFAULT now()
 11:    ,created_by                text          NOT NULL DEFAULT current_user
 12:    ,PRIMARY KEY (schema_name, table_name, column_name)
 13: );
Die sequenzielle Fassung liest die Tabellen eines Schemas und schreibt den Snapshot jeder Tabelle in einer eigenen Transaktion, so wie die Fallstudie es tat. Das COMMIT in der Schleife setzt voraus, dass der CALL nicht in einem offenen Transaktionsblock steht:
  1: -- --------------------------------------------------------------------------------
  2: -- Parameter
  3: -- --------------------------------------------------------------------------------
  4: --    p_schema_name        text
  5: --       Schema, dessen Tabellen in den Snapshot übernommen werden
  6: -- --------------------------------------------------------------------------------
  7: CREATE OR REPLACE PROCEDURE meta.sp_load_column_snapshot_loop
  8: (
  9:     IN    p_schema_name        text
 10: )
 11: LANGUAGE plpgsql
 12: AS $procedure$
 13: DECLARE
 14:    l_table_name              text;
 15: BEGIN
 16:
 17:    FOR l_table_name IN
 18:       SELECT
 19:          table_name
 20:       FROM
 21:          information_schema.tables
 22:       WHERE
 23:          table_schema = p_schema_name
 24:       ORDER BY
 25:          table_name
 26:    LOOP
 27:       -- --------------------------------------------------------------------------------
 28:       -- Eine Tabelle: alten Snapshot löschen, neuen schreiben
 29:       -- --------------------------------------------------------------------------------
 30:       DELETE FROM
 31:          meta.column_snapshot
 32:       WHERE
 33:              schema_name = p_schema_name
 34:          AND table_name  = l_table_name;
 35:
 36:       INSERT INTO meta.column_snapshot
 37:       (
 38:           schema_name
 39:          ,table_name
 40:          ,column_name
 41:          ,data_type
 42:          ,ordinal_position
 43:       )
 44:       SELECT
 45:           table_schema
 46:          ,table_name
 47:          ,column_name
 48:          ,data_type
 49:          ,ordinal_position
 50:       FROM
 51:          information_schema.columns
 52:       WHERE
 53:              table_schema = p_schema_name
 54:          AND table_name   = l_table_name;
 55:
 56:       -- Jede Tabelle wird in einer eigenen Transaktion geschrieben
 57:       COMMIT;
 58:    END LOOP;
 59: END;
 60: $procedure$;
Die Zeilen zeigen im Einzelnen:
- Zeilen 17 bis 54: Die Schleife läuft über die Tabellen-Liste aus
information_schema.tables, und für jede Tabelle folgen einDELETEund einINSERT. Das ist das N+1-Muster: eine Abfrage für die Liste, N weitere für die Arbeit. - Zeile 57: Das
COMMITbeendet die Transaktion nach jeder Tabelle und baut damit die Atomarität pro Tabelle nach. Ohne diese Zeile liefe die ganze Schleife in einer einzigen Transaktion, und ein Fehler bei Tabelle 500 nähme auch die 499 fertigen Tabellen zurück. Die Zeitstempel-Messung aus dem vorigen Abschnitt ergäbe dann null, weilnow()den Beginn der Transaktion liefert und innerhalb einer Transaktion konstant bleibt. Prozeduren dürfenCOMMITseit Postgres 11, Funktionen dürfen es nicht, und auch eine Prozedur darf es nur, solange der Aufrufer keine Transaktion offen hält. Öffnet er eine, etwa über eine Bibliothek, die jeden Aufruf inBEGINundCOMMITeinschließt, scheitert die Prozedur beim erstenCOMMITaninvalid transaction termination. Die Fehler-Isolation der Fallstudie leistet dasCOMMITallerdings nicht. Diese Prozedur hat keine Fehlerbehandlung, und ein Fehler bei Tabelle 500 beendet den Aufruf. Die 499 fertigen Tabellen bleiben geschrieben, die übrigen 500 bleiben unbearbeitet.
Die set-basierte Fassung erledigt die Aufgabe mit zwei Anweisungen über das ganze Schema und kommt damit ohne Schleife aus. Der Unterschied steckt in der WHERE-Klausel: Dort steht nur noch das Schema, nicht mehr die einzelne Tabelle.
  1: -- --------------------------------------------------------------------------------
  2: -- Parameter
  3: -- --------------------------------------------------------------------------------
  4: --    p_schema_name        text
  5: --       Schema, dessen Tabellen in den Snapshot übernommen werden
  6: -- --------------------------------------------------------------------------------
  7: CREATE OR REPLACE PROCEDURE meta.sp_load_column_snapshot
  8: (
  9:     IN    p_schema_name        text
 10: )
 11: LANGUAGE plpgsql
 12: AS $procedure$
 13: BEGIN
 14:
 15:    DELETE FROM
 16:       meta.column_snapshot
 17:    WHERE
 18:       schema_name = p_schema_name;
 19:
 20:    INSERT INTO meta.column_snapshot
 21:    (
 22:        schema_name
 23:       ,table_name
 24:       ,column_name
 25:       ,data_type
 26:       ,ordinal_position
 27:    )
 28:    SELECT
 29:        table_schema
 30:       ,table_name
 31:       ,column_name
 32:       ,data_type
 33:       ,ordinal_position
 34:    FROM
 35:       information_schema.columns
 36:    WHERE
 37:       table_schema = p_schema_name;
 38: END;
 39: $procedure$;
Damit entfällt auch das COMMIT pro Tabelle, denn beide Anweisungen laufen in derselben Transaktion. Die Atomarität pro Tabelle gibt sie dafür auf: Ein Fehler nimmt den ganzen Lauf zurück und nicht nur die gerade bearbeitete Tabelle. Einen zweiten Unterschied haben die beiden Fassungen: Die set-basierte löscht auch Zeilen zu Tabellen, die es inzwischen nicht mehr gibt, die Schleife lässt sie stehen, weil sie nur über die vorhandenen Tabellen läuft.
Auf Postgres 18.6 in einem Docker-Container auf einem Laptop brauchte die set-basierte Fassung in drei Läufen auf frisch angelegter Tabelle jeweils rund 0,6 Sekunden, die Schleife rund 3 Sekunden. Beide Fassungen schrieben exakt dieselben 50.000 Zeilen, ein Abgleich per EXCEPT ALL über die fünf fachlichen Spalten, also ohne die Zeitstempel, ergab in beide Richtungen keinen Unterschied. Auf Postgres 17 streuten die Zeiten stärker, das Verhältnis war ähnlich. Die Laptop-Zahlen taugen als Größenordnung, nicht als Benchmark, denn bei wiederholtem Überschreiben ohne VACUUM wurden beide Fassungen spürbar langsamer.
Ein Faktor von fünf (3 Sekunden ÷ 0,6 Sekunden) ist deutlich. Von dem, was die Fallstudie erlebte, ist er trotzdem weit entfernt, denn dort kostete eine Iteration 114 Millisekunden statt drei. Den Unterschied machen die Aufwände, die jede Iteration dort zusätzlich zur eigentlichen Arbeit bezahlt hat: drei Verbindungsaufbauten, drei Anmeldungen, das Laden und Entschlüsseln des Profils und vier getrennte Prozedur-Aufrufe. Eine Schleife ist also nicht schon deshalb teuer, weil sie eine Schleife ist. Teuer wird sie im Verhältnis zu dem, was eine Iteration über die Arbeit hinaus kostet, und dieser Anteil wächst mit jeder Verbindung, jedem Prozess und jeder Transaktion, die zwischen der Schleife und den Daten liegt.
Was für die Schleife sprach
Vor dem Umbau verdient die Schleife eine faire Bewertung, denn sie war keine Nachlässigkeit. Ihre Vorteile waren real, und einige davon musste die neue Lösung ausdrücklich nachbauen.
- Wiederverwendung: Die Funktion für eine einzelne Tabelle existierte bereits und war getestet. Eine Schleife darüber brachte weder einen neuen Code-Pfad noch eine neue Fehlerklasse.
- Fehler-Isolation pro Tabelle: Scheitert Tabelle 738 an einer fehlenden Berechtigung oder an einem gleichzeitigen
DROP TABLE, fängt der Anwendungs-Code den Fehler ab, zählt einen Fehlerzähler hoch, und die übrigen 999 Tabellen laufen weiter. Diese Eigenschaft kommt aus der Fehlerbehandlung der Schleife und nicht aus der Transaktion pro Tabelle, die der nächste Punkt beschreibt. - Atomarität pro Tabelle: Löschen und Neu-Einfügen liefen für jede Tabelle in einer eigenen Transaktion, sodass auch unter Konkurrenz nie ein halber Snapshot einer einzelnen Tabelle entstand. Einen gemeinsamen Stand aller 1000 Tabellen aus ein und demselben Lauf garantiert das nicht, den braucht der Snapshot aber auch nicht, weil jede Tabelle für sich gelesen und für sich verwendet wird. In der Messsitzung hat sich das bewährt: Von sieben Läufen überlappten fünf, kein einziger meldete einen Fehler, und am Ende lagen exakt 50.000 Zeilen für 1000 Tabellen vor.
- Konstanter Speicherbedarf: Im Arbeitsspeicher der Anwendung lag nie mehr als eine Tabelle.
- Lesbarkeit: Der Kontrollfluss war eine gewöhnliche Schleife, die jeder beim ersten Lesen versteht.
- Unauffälligkeit bei kleinen Mengen: Eine Datenbank mit 48 Tabellen hätte hochgerechnet fünf bis sechs Sekunden gebraucht. Das ist ein spürbares, aber kein alarmierendes Warten.
Das Problem kam mit der Skalierung und nicht mit der ursprünglichen Entscheidung.
Was gegen die Schleife sprach und was die Umstellung kostet
Gegen die Schleife sprachen vier Punkte:
- Fixkosten mal Anzahl: Verbindung, Anmeldung, Profil und Prozedur-Aufruf fallen in jeder Iteration an, während die eigentliche Datenmenge pro Tabelle winzig ist. Über 99,9 Prozent der Laufzeit steckten in der Schleife über die Tabellen.
- Der Katalog beantwortet Mengen-Fragen fast zum Preis einer Einzel-Frage: Im Nachbau lieferte
information_schema.columnsalle 50.000 Spalten in rund 0,3 Sekunden. Die Spalten einer einzelnen Tabelle brauchten als eigene Abfrage 6 bis 15 Millisekunden, tausendmal wiederholt also 6 bis 15 Sekunden. Der größte Teil davon ist die Planung der Sicht-Abfrage, auf Postgres 18.6 rund 5 Millisekunden gegen rund eine Millisekunde Ausführung. In einer PL/pgSQL-Prozedur fällt diese Planung nicht in jedem Durchlauf an: Die Prozedur legt beim ersten Durchlauf eine vorbereitete Anweisung an und wechselt nach wenigen Durchläufen auf einen gespeicherten, von den konkreten Werten unabhängigen Plan, sofern der nicht deutlich schlechter ist. Deshalb kommt die Schleife im Nachbau mit rund drei Millisekunden je Tabelle aus. Mit der Einstellungplan_cache_mode = force_custom_plan, die in jedem Durchlauf neu plant, brauchte dieselbe Schleife rund zweieinhalb bis drei Sekunden länger. - Set-basiertes Schreiben verteilt die Kosten auf viele Zeilen: Im selben Projekt schrieb ein einzelnes
INSERTin eine andere Tabelle rund 91.000 Zeilen in etwa einer Sekunde, als Größenordnung und nicht als Vergleich unter gleichen Bedingungen. Die Schleife bewegte mit 50.000 Zeilen weniger Daten und brauchte dafür 114 Sekunden. - Kollision mit Timeouts: Ein synchroner Vorgang, der länger dauert als der Timeout des vorgeschalteten Webservers, erzeugt eine Fehlermeldung, hinter der die Arbeit weiterläuft. Nutzer klicken erneut, und die Läufe stapeln sich.
Die Umstellung auf set-basierte Verarbeitung hat allerdings ihren eigenen Preis:
- Die Batch-Größe wird zu einer eigenen Entscheidung: Ein Batch ist ein einzelner Aufruf einer Prozedur, die die Daten vieler Tabellen auf einmal entgegennimmt, im beschriebenen Fall als JSON-Dokument mit allen Spalten, Schlüsseln und Fremdschlüsseln dieser Tabellen. Wie viele Tabellen hineingehören, muss jemand festlegen, und vor der Umstellung stellte sich die Frage gar nicht. Die Datenmenge pro Aufruf muss zu den Speichergrenzen der Anwendung und zu den Parameter-Limits der Datenbank-Treiber passen.
- Fehler treffen größere Einheiten: Scheitert ein Batch, betrifft das alle Tabellen darin. Die Zählung pro Tabelle muss aktiv wiederhergestellt werden.
- Transaktionen dauern länger: Ein Batch hält seine Sperren länger als viele kleine Transaktionen.
- Mehr Code muss auf einmal stimmen: Jede der drei unterstützten Engines, PostgreSQL, SQL Server und MySQL, braucht eigene Mengen-Abfragen gegen ihren Katalog. Die neuen Batch-Prozeduren sind neue Objekte mit eigenen Tests.
- Die Äquivalenz muss bewiesen werden: Der Umbau darf das gespeicherte Ergebnis nicht verändern, deshalb wird ein Vorher-nachher-Vergleich des gespeicherten Bestands zur Pflicht. Jede Abweichung muss erklärbar sein: Unerklärte Abweichungen sind Fehler des Umbaus, erklärte können Fehler des alten Codes sein.
Die Entscheidung: vier Optionen und eine Budget-Rechnung
Mit der Budget-Rechnung von drei Millisekunden pro Tabelle ließen sich die Optionen schnell sortieren:
| Option | Eingriff | Erwartung |
|---|---|---|
| A: Mengen-Abfragen und Batch-Schreiben | drei bis vier Katalog-Abfragen für alle Tabellen über eine Verbindung, Batch-Prozeduren statt Einzelaufrufen | 2,5 bis 5 Sekunden, einziger Weg in Richtung Zielwert |
| B: Verbindung wiederverwenden | eine Verbindung und ein Profil pro Lauf oder ein Verbindungs-Pool, die Schleife bleibt | Faktor 2 bis 4, also 30 bis 60 Sekunden, drei Abfragen und vier Prozedur-Aufrufe je Tabelle bleiben |
| C: Parallelisieren | mehrere Worker arbeiten die Schleife ab | linearer Gewinn bei höherer Last auf der Quelle, ohne A kein Zielwert |
| D: Zielwert aufgeben | der Refresh ist selten und wird von Hand ausgelöst | löst die fünf bis sechs Sekunden bei realen Datenbanken nicht |
Entschieden wurde Option A, ergänzt um eine Erkennung unveränderter Tabellen. Eine Tabelle, deren Spalten, Schlüssel und Fremdschlüssel sich seit dem letzten Refresh nicht geändert haben, wird gar nicht erst neu geschrieben.
Zwei Festlegungen gehörten zur Entscheidung. Erstens wurde die Schleife ersetzt und nicht als zweiter Pfad neben der neuen Lösung stehen gelassen. Auch das Aktivieren einer einzelnen Tabelle läuft seitdem über den set-basierten Pfad, mit einer Menge aus genau einem Element. Die Funktion, aus deren Wiederverwendung die Schleife einst entstanden war, gibt es nicht mehr. Zweitens wurde der pauschale Zielwert durch drei getrennte Zielwerte ersetzt, nachdem die Hardware des Servers geprüft war: unter drei Sekunden, wenn sich nichts geändert hat, unter zehn Sekunden, wenn alle 1000 Tabellen neu geschrieben werden, und unter zwei Sekunden bei realistischen 50 Tabellen.
So läuft ein Refresh heute ab
So sieht der ganze Ablauf heute am Stück aus, beschrieben für einen Klick auf „Schema aktualisieren“ über alle 1000 Tabellen. Für eine einzelne Tabelle läuft exakt derselbe Weg, dann mit einer Menge aus einem Element.
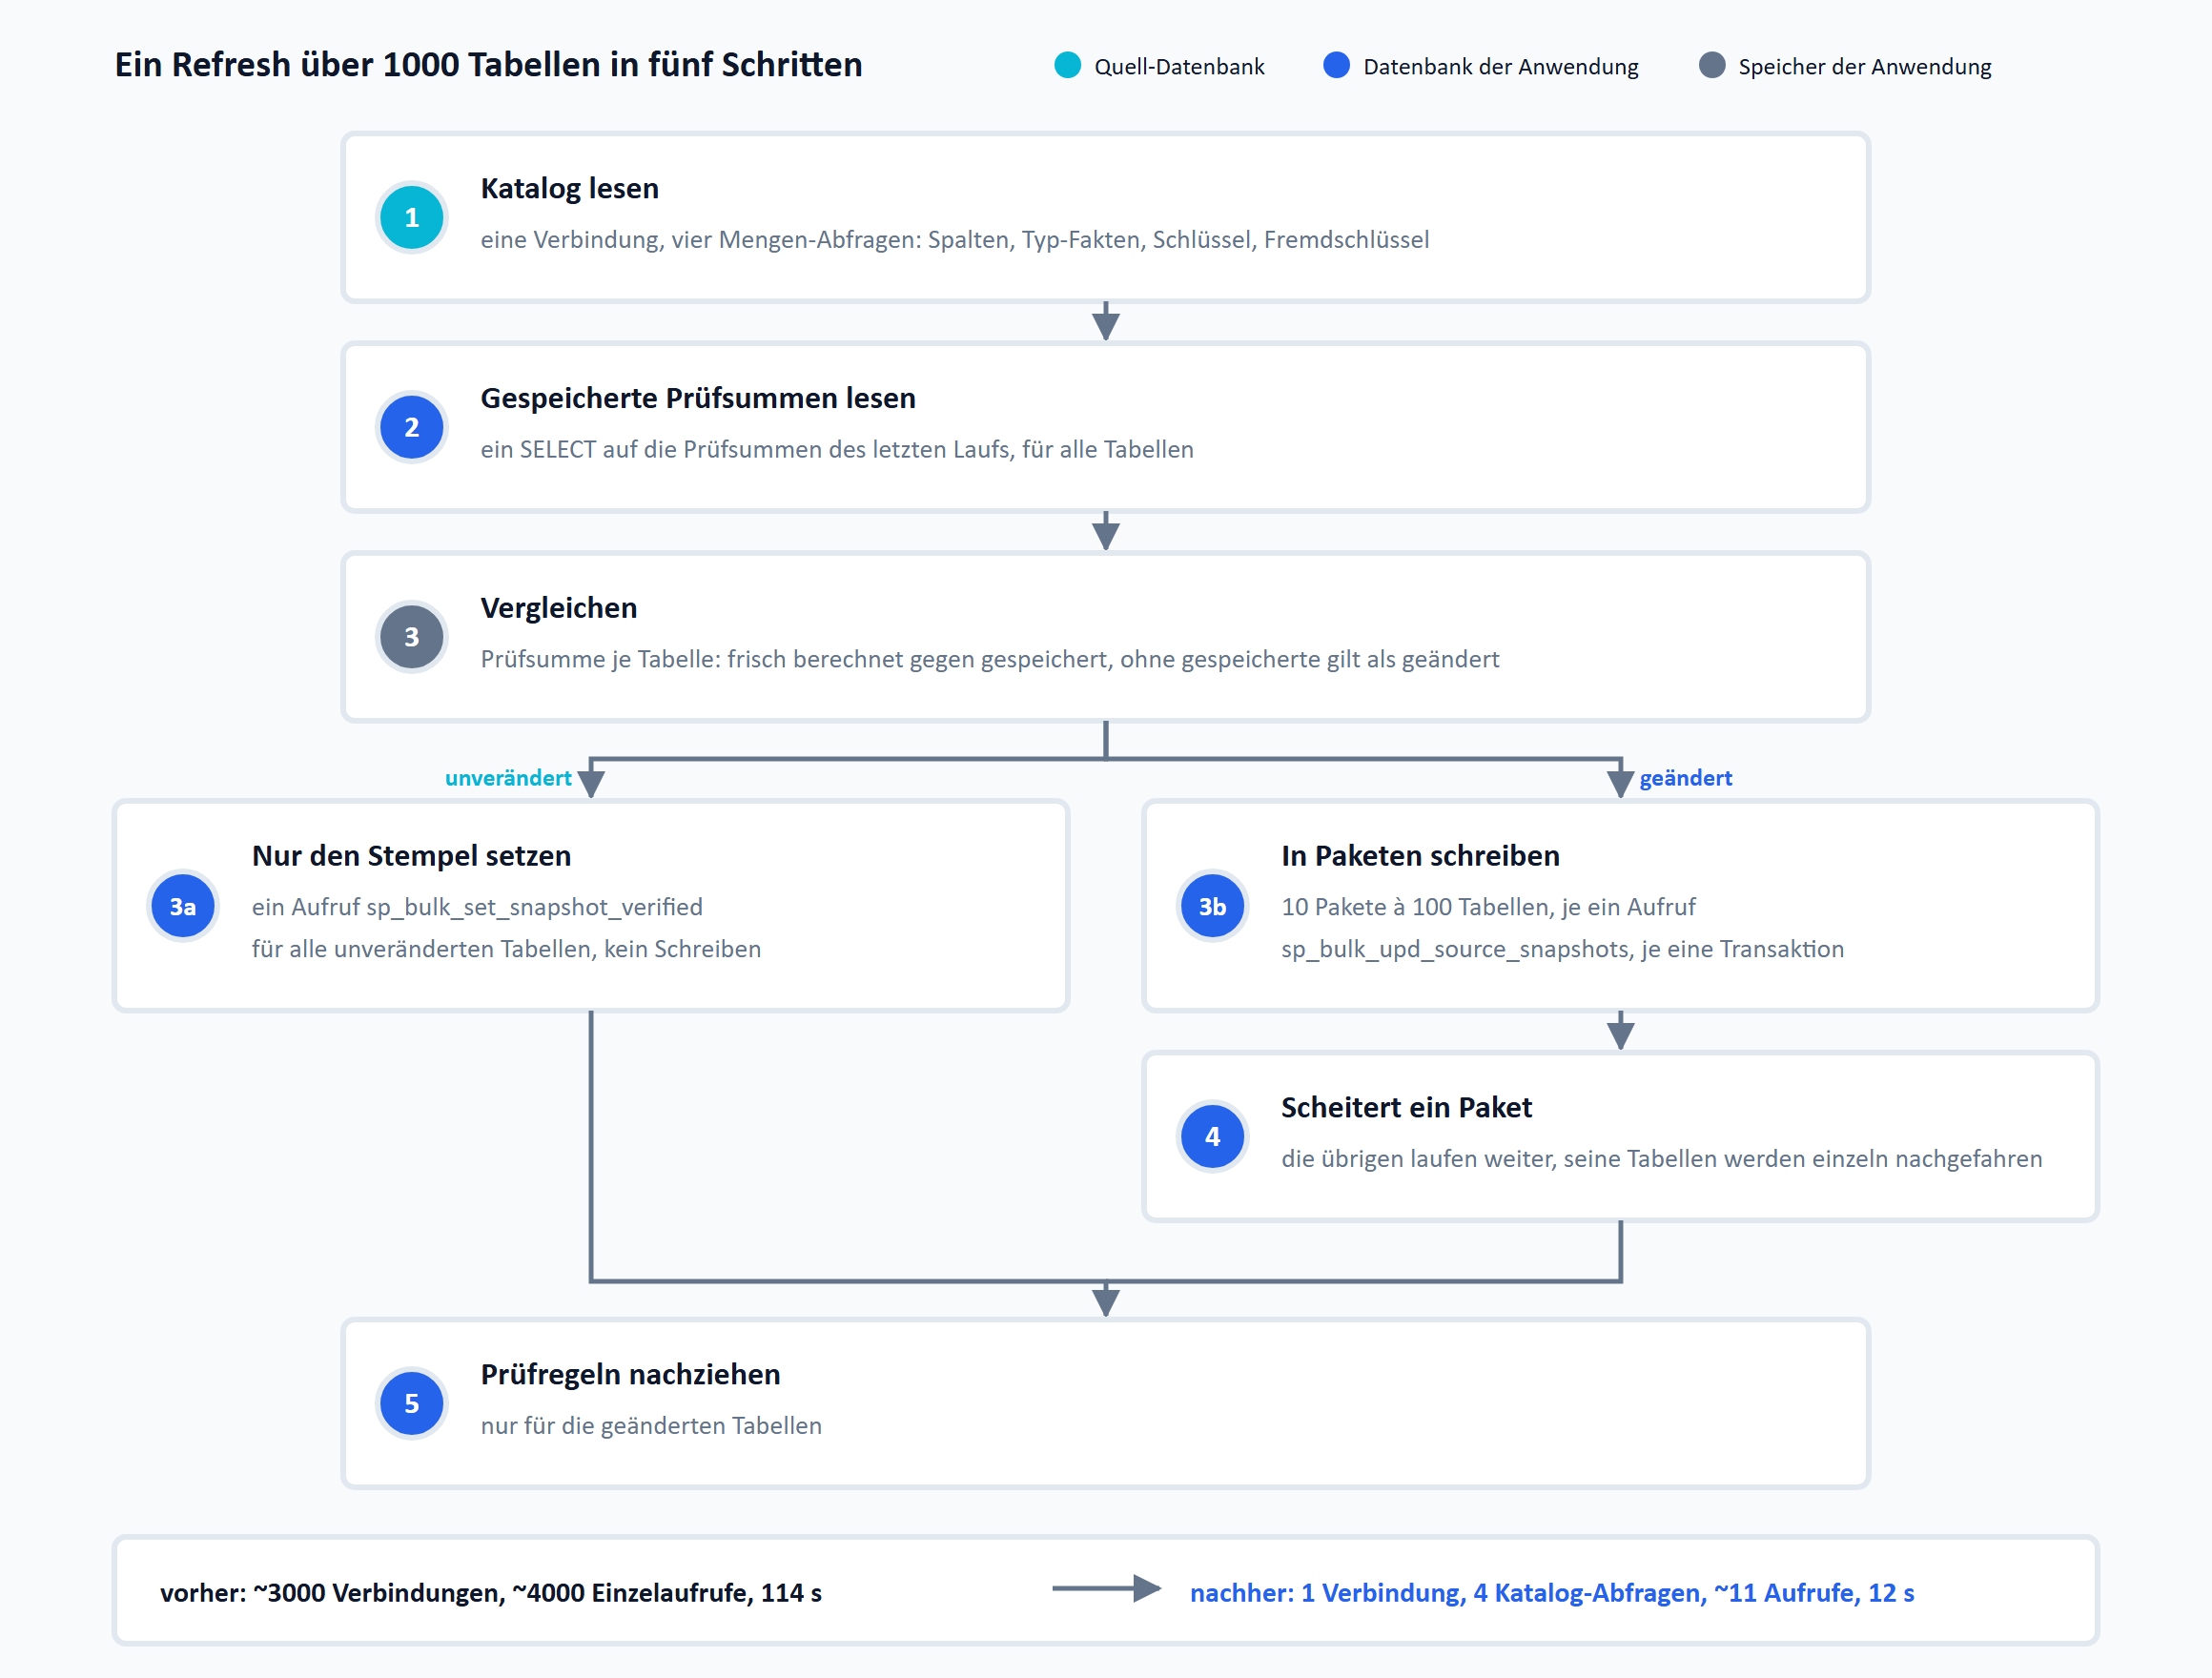
- Katalog lesen: Die Anwendung öffnet eine einzige Verbindung zur Quell-Datenbank und stellt vier Fragen, jede über alle 1000 Tabellen zugleich: die Spalten, die Typ-Fakten, die sie braucht, um unbekannte Datentypen einzuordnen, die Unique- und Primärschlüssel und die Fremdschlüssel. Danach liegt der komplette Katalog im Speicher der Anwendung. Tabellen, für die der Katalog keine einzige Spalte liefert, werden hier aussortiert und als fehlgeschlagen gemeldet, statt einen leeren Snapshot zu erzeugen.
- Gespeicherte Prüfsummen lesen: Ein einziger
SELECTauf die eigene Datenbank der Anwendung holt für alle diese Tabellen die zuletzt gespeicherte Prüfsumme. Das ist ein anderer Server als in Schritt 1. Dort wurde die fremde Quelle befragt, hier der eigene Bestand. - Vergleichen: Für jede Tabelle bildet die Anwendung eine SHA-256-Prüfsumme über genau die Daten, die sie speichern würde, und vergleicht sie mit der gespeicherten. Fehlt eine gespeicherte Prüfsumme, gilt die Tabelle als geändert. Das Ergebnis sind zwei Gruppen.
- Unverändert: Für diese Tabellen wird nichts geschrieben. Sie bekommen nur den Stempel „zuletzt gegen die Quelle geprüft“, über einen einzigen Prozedur-Aufruf für die ganze Gruppe.
- Geändert: Diese Tabellen werden in Pakete zu je 100 geschnitten. Die Zahl ist eine Konstante im Anwendungs-Code und keine Einstellung, und geht sie nicht auf, ist das letzte Paket kleiner. Für jedes Paket geht ein Aufruf an die Datenbank, mit den vollständigen Daten der 100 Tabellen als JSON-Dokument im Parameter. Die Prozedur dahinter enthält selbst keine Schleife, sie packt das Dokument aus und schreibt Spalten, Schlüssel und Fremdschlüssel aller Tabellen des Pakets mit je einem
DELETEund einemINSERT. Jedes Paket ist eine eigene Transaktion. Bei 1000 geänderten Tabellen sind das zehn Aufrufe.
- Fehler auffangen: Scheitert ein Paket, laufen die übrigen weiter. Die Tabellen des gescheiterten Pakets werden anschließend einzeln nachgefahren, über denselben Pfad mit einer Menge aus einem Element. Nur wenn der Fehler ohnehin jeden weiteren Aufruf treffen würde, etwa weil das Datenmodell inzwischen eingefroren oder die Verbindung gelöscht wurde, bricht der Lauf ab, statt es für jede Tabelle einzeln noch einmal zu versuchen.
- Prüfregeln nachziehen: Zum Schluss werden die aus Schlüsseln abgeleiteten Prüfregeln aktualisiert, und zwar nur für die Tabellen aus der Gruppe „geändert“.
Aus 3000 Verbindungsaufbauten und 4000 Einzelaufrufen werden so eine Verbindung, vier Katalog-Abfragen und ungefähr zehn bis elf Prozedur-Aufrufe.
Wie die neue Lösung die Stärken der Schleife zurückholt
Von den sechs Stärken aus dem Abschnitt „Was für die Schleife sprach“ musste die neue Lösung zwei ausdrücklich nachbauen. Bei den übrigen fällt die Bilanz gemischt aus.
Atomarität pro Tabelle kommt über die Pakete zurück. Jedes Paket läuft in einer eigenen Transaktion, und weil die Grenze zwischen zwei Paketen immer zwischen zwei Tabellen liegt und nie mitten in einer, entsteht auch unter Konkurrenz kein halber Snapshot einer Tabelle. Ein Paket hält seine Sperren allerdings länger als die vielen kleinen Transaktionen der Schleife. Damit zwei überlappende Läufe dabei nicht in einen Deadlock geraten, weil jeder auf Zeilen wartet, die der andere hält, sperrt die Prozedur die Tabellen-Einträge eines Pakets zu Beginn in fester Reihenfolge, mit SELECT … ORDER BY id FOR UPDATE. Warten muss der zweite Lauf trotzdem, bis das Paket des ersten abgeschlossen ist, und er arbeitet danach auf dessen Stand.
Fehler-Isolation pro Tabelle kommt als Rückfallebene zurück, wie Schritt 4 des Ablaufs zeigt: Scheitert ein Paket, laufen die übrigen weiter, und seine Tabellen werden einzeln nachgefahren, sodass am Ende wieder pro Tabelle gezählt wird. Die erste Fassung unterschied dabei zwei Fälle nicht. Eine einzelne fehlerhafte Tabelle behandelte sie genauso wie eine Ursache, die alle Tabellen trifft, etwa eine inzwischen gesperrte Verbindung. In diesem Fall scheiterten alle zehn Pakete, und die Nachläufe erzeugten weitere 1000 Aufrufe, die ebenso scheiterten. Die fertige Fassung erkennt solche Fehler an ihrer Meldung und bricht den Nachlauf ab.
Der konstante Speicherbedarf ist verändert, nicht erhalten. Nach Schritt 1 liegt der Katalog aller Tabellen vollständig im Speicher der Anwendung, bei der Schleife war es nie mehr als eine Tabelle. Begrenzt ist stattdessen die Größe eines einzelnen Schreibaufrufs: Die 100 Tabellen je Paket sind das Ergebnis einer Abwägung zwischen der Größe des übergebenen Dokuments, der Dauer der Transaktion und der Zeit, die ein Paket Sperren hält. Eine besonders breite Tabelle macht ihr Paket lediglich größer.
Wiederverwendung und Lesbarkeit hat die neue Lösung aufgegeben. Die Funktion für eine einzelne Tabelle gibt es nicht mehr, und der set-basierte Pfad ist mehr Code, verteilt auf drei Engines. Die Unauffälligkeit bei kleinen Mengen bleibt erhalten, fällt aber schwächer aus als erhofft: 48 Tabellen brauchen jetzt 2,9 bis 4,4 Sekunden statt hochgerechneter fünf bis sechs. Der größte Teil davon ist ein fester Sockel, den der Ergebnis-Abschnitt aufschlüsselt.
Unveränderte Tabellen überspringen
Für jede Tabelle berechnet die Anwendung eine Prüfsumme über genau die Daten, die sie speichern würde, und vergleicht sie mit der Prüfsumme des letzten Laufs. Stimmen beide überein, wird die Tabelle nicht neu geschrieben. Sie bekommt nur einen Stempel mit dem Zeitpunkt der Prüfung, damit sichtbar bleibt, dass sie gegen die Quelle geprüft wurde.
Set-basiert heißt nicht automatisch schnell: warum eine Mengen-Abfrage langsamer sein kann
Die erste set-basierte Fassung las die Schlüssel aller Tabellen über die beiden Standard-Sichten information_schema.table_constraints und information_schema.key_column_usage. Das ist die portable Fassung über die Standard-Sichten, und auf eine einzelne Tabelle gefiltert war sie im Projekt jahrelang unauffällig gelaufen:
  1: SELECT
  2:     T01.table_name
  3:    ,T01.constraint_name
  4:    ,T01.constraint_type
  5:    ,T02.column_name
  6:    ,T02.ordinal_position
  7: FROM
  8:    information_schema.table_constraints T01
  9:    INNER JOIN information_schema.key_column_usage T02
 10:    ON
 11:          T02.constraint_schema = T01.constraint_schema
 12:      AND T02.constraint_name   = T01.constraint_name
 13:      AND T02.table_name        = T01.table_name
 14: WHERE
 15:        T01.table_schema    = 'perf'
 16:    AND T01.constraint_type IN ('PRIMARY KEY', 'UNIQUE')
 17: ORDER BY
 18:     T01.table_name
 19:    ,T01.constraint_name
 20:    ,T02.ordinal_position;
Der Join läuft über Schema und Constraint-Name und zusätzlich über den Tabellen-Namen in Zeile 13. Diese Bedingung ist nötig, weil ein Fremdschlüssel in Postgres denselben Namen tragen darf wie der Unique-Constraint einer anderen Tabelle im selben Schema. Ohne sie würde key_column_usage die Spalten dieses Fremdschlüssels dem Schlüssel zuschlagen. Zwischen Primär- und Unique-Schlüsseln kann der Fall nicht auftreten, weil der Index dahinter den Namen im Schema belegt.
Vor dem Deployment wurde die Abfrage auf Postgres 17 gemessen. Für 1000 Tabellen brauchte die Abfrage 4,7 bis 5,1 Sekunden. Dieselbe Abfrage, für jede Tabelle einzeln abgesetzt, kam hochgerechnet aus einer Stichprobe von 25 Tabellen auf 0,35 bis 0,51 Sekunden. Die Mengen-Abfrage war damit rund zehnmal langsamer als die Einzel-Abfragen, die sie ersetzen sollte, und hätte den Gewinn der gesamten Katalog-Lesung aufgebraucht.
EXPLAIN ANALYZE zeigte den Grund. Beide Sichten sind selbst Abfragen über mehrere Systemtabellen, mit Rechte-Prüfungen und Typ-Umwandlungen. Der Planer, also der Teil von Postgres, der für jede Abfrage den Ausführungsweg wählt, hatte für diese Abfrage einen Nested Loop gewählt, also einen Join, der für jede Zeile der einen Seite die andere Seite erneut durchläuft. Die Join-Bedingung stand in diesem Plan am Nested Loop selbst und nicht innerhalb des Teilplans der Sicht key_column_usage, und so führte er diesen Teilplan 1000-mal aus, einmal je Constraint, bei 1000 Tabellen mit je einem Primärschlüssel also einmal je Tabelle, und las dabei jedes Mal die ganze Systemtabelle pg_constraint. Im Plan steht das als loops=1000 an genau diesem Teilplan. Die Zeitangaben an einem solchen Knoten sind Mittelwerte je Durchlauf und müssen mit dem loops=-Wert multipliziert werden, sonst sieht der teuerste Knoten im Plan harmlos aus. Die Schleife war in diesem Plan also nicht verschwunden, sie war aus dem Anwendungs-Code in den Ausführungsplan gewandert. Als Gegenprobe senkte SET enable_nestloop = off dieselbe Abfrage von 4,7 Sekunden auf 48 Millisekunden. Das ist eine Diagnose und keine Lösung für den Betrieb. Sie beweist nicht, dass ein Nested Loop grundsätzlich falsch wäre, sondern nur, dass der gewählte Plan für diese Datenmengen teuer war.
Der Nachbau für diesen Artikel bestätigt das Verhalten und zeigt zugleich, dass es von der Version abhängt. Auf Postgres 17.10 brauchte die Abfrage 3,9 bis 4,8 Sekunden, auf Postgres 18.6 dagegen 29 bis 34 Millisekunden, weil der Planer dort einen Hash Join wählt. Ein Freibrief für information_schema ist das nicht, denn ein Join der Spalten-Sicht mit information_schema.tables lief auch auf 18.6 in dasselbe Muster und brauchte über 99 Sekunden. Die Prozedur im vorigen Abschnitt verzichtet deshalb auf diesen Join.
Die Lösung im Projekt war eine Abfrage direkt auf pg_catalog, die Postgres-eigenen Systemtabellen, aus denen die Sichten von information_schema ihrerseits lesen. Sie verbindet pg_constraint über das Spalten-Array conkey mit pg_attribute und beschränkt sich wie die Sicht-Fassung auf Primär- und Unique-Schlüssel:
  1: SELECT
  2:     T02.relname                       AS table_name
  3:    ,T01.conname                       AS constraint_name
  4:    ,T01.contype = 'p'                 AS is_primary_key
  5:    ,T04.attname                       AS column_name
  6:    ,T03.ordinal_position::int         AS ordinal_position
  7: FROM
  8:    pg_catalog.pg_constraint T01
  9:    INNER JOIN pg_catalog.pg_class T02
 10:    ON
 11:      T02.oid = T01.conrelid
 12:    CROSS JOIN LATERAL unnest(T01.conkey) WITH ORDINALITY AS T03 (attnum, ordinal_position)
 13:    INNER JOIN pg_catalog.pg_attribute T04
 14:    ON
 15:          T04.attrelid = T01.conrelid
 16:      AND T04.attnum   = T03.attnum
 17: WHERE
 18:        T02.relnamespace = 'perf'::regnamespace
 19:    AND T01.contype      IN ('p', 'u')
 20:    -- Sichtbarkeit wie in information_schema.columns
 21:    AND (
 22:           pg_has_role(T02.relowner, 'USAGE')
 23:        OR has_column_privilege(T02.oid, T04.attnum, 'SELECT, INSERT, UPDATE, REFERENCES')
 24:        )
 25: ORDER BY
 26:     T02.relname
 27:    ,T01.conname
 28:    ,T03.ordinal_position;
Die Bedingung in den Zeilen 20 bis 24 gehört zum nächsten Abschnitt. Die Abfrage lieferte dieselben Zeilen, der Abgleich per EXCEPT ALL ergab keinen Unterschied, und die Laufzeit fiel in einem direkten Vergleichslauf von 4,0 Sekunden auf 13,6 Millisekunden. Im Nachbau brauchte sie auf beiden Postgres-Versionen rund 30 bis 60 Millisekunden. Wer Katalog-Sichten miteinander verbindet, sollte sich deshalb den Ausführungsplan ansehen, bevor er die set-basierte Fassung für die schnellere hält. Das Erkennungszeichen ist ein Teilplan, der eine ganze Systemtabelle liest und dabei einen loops=-Wert in Höhe der Zeilen der äußeren Seite trägt, hier also der Tabellen-Anzahl. Der hohe loops=-Wert allein ist noch kein Befund, denn ein Nested Loop, der auf der inneren Seite einen Index trifft, ist häufig der schnellste Plan. Die Abfrage auf pg_catalog gilt nur für Postgres. Für SQL Server und MySQL hat das Projekt ohnehin eigene Katalog-Abfragen, dort über die sys-Sichten beziehungsweise über information_schema, und dort trat das Problem nicht auf: Die set-basierte Fassung war auf beiden Engines von Anfang an schneller als die Einzel-Abfragen.
Die Rechte-Falle beim Wechsel auf pg_catalog
Der Wechsel auf pg_catalog hat eine Nebenwirkung, die man kennen sollte. information_schema.table_constraints zeigt nur Tabellen, die der aktuellen Rolle gehören oder auf denen sie ein anderes Recht als SELECT besitzt. Eine reine Leserolle sieht dort keinen einzigen Schlüssel, während ihr information_schema.columns alle Spalten zeigt. Genau mit solchen Leserollen arbeiten die Quell-Verbindungen im Projekt, und deshalb waren die Schlüssel-Snapshots aller Postgres-Beispielverbindungen von Anfang an leer. Niemandem war es aufgefallen, denn eine leere Liste sieht nicht wie ein Fehler aus. Der Umbau hat diesen Defekt nebenbei behoben.
pg_catalog hat das umgekehrte Problem: Die Systemtabellen pg_constraint und pg_attribute filtern nicht nach den Rechten der Rolle. Eine Rolle sieht dort deshalb die Constraint-Definitionen auch von Tabellen, deren Daten sie nicht lesen darf. Die neue Abfrage trägt deshalb in den Zeilen 20 bis 24 eine eigene Bedingung, die die Sichtbarkeitsregel von information_schema.columns nachbildet, und sie wurde dadurch nicht messbar langsamer. Sie übernimmt aus dieser Sicht allein die Rechte-Prüfung. Die übrigen Filter der Sicht, etwa gegen gelöschte Spalten oder temporäre Schemas anderer Sitzungen, braucht die Schlüssel-Abfrage nicht, weil ein Schlüssel keine gelöschte Spalte enthalten kann und das Schema fest vorgegeben ist. Ein allgemeiner Ersatz für die Sichtbarkeitslogik von information_schema ist die Bedingung damit nicht, und wer eine andere Katalog-Sicht auf pg_catalog nachbaut, muss deren Bedingungen einzeln übertragen. Wer Prüfregeln aus Schlüsseln ableitet, wie es der Artikel Prüfregeln aus dem Schema ableiten beschreibt, sollte wissen, unter welcher Rolle die Abfrage läuft.
Ein zweiter Befund gehört zur set-basierten Lesung selbst. Der Katalog-Leser legt für jede angefragte Tabelle einen Eintrag an. Liefert die Abfrage für eine Tabelle keine Zeile, weil es sie nicht mehr gibt oder die Rolle ihre Spalten nicht sehen darf, bleibt dieser Eintrag leer, ohne dass es eine Fehlermeldung gäbe. Der Code hätte daraus einen Snapshot ohne Spalten gemacht und beim Abgleich die abgeleiteten Prüfregeln dieser Tabelle gelöscht. Die Code-Analyse vor dem Deployment hat das gefunden. In einer Menge fällt ein fehlendes Element nicht auf, und wer eine Menge liest, muss deshalb selbst prüfen, ob etwas fehlt.
Das Ergebnis: Faktor 9 bis 19, Zielwerte verfehlt
Gemessen wurde nach dem Deployment auf demselben Server und gegen dieselbe Quell-Datenbank mit 1000 Tabellen:
| Szenario | Vorher | Nachher | Zielwert |
|---|---|---|---|
| 1000 Tabellen, alle neu geschrieben | 114,4 s, Timeout nach 60 s | 12,1 s | unter 10 s |
| 1000 Tabellen, unverändert | – | 5,8 bis 6,4 s | unter 3 s |
| 48 Tabellen, alle neu geschrieben | hochgerechnet 5 bis 6 s | 4,4 s | unter 2 s |
| 48 Tabellen, unverändert | – | 2,9 bis 3,1 s | unter 2 s |
| Leerlauf, keine gespeicherten Tabellen | – | 2,7 s | – |
Statt 3000 Verbindungen und 4000 Einzelaufrufen macht der Refresh jetzt drei bis vier Katalog-Abfragen über eine einzige Verbindung und etwa zehn Batch-Aufrufe. Der Lauf mit vollständigem Neuschreiben ist rund neunmal schneller als vorher, der Lauf über einen unveränderten Bestand rund 19-mal, wobei dieser Faktor beide Änderungen zusammen misst, die set-basierte Verarbeitung und das Überspringen unveränderter Tabellen. Kein Lauf erreicht mehr den Timeout, und in allen neun Messläufen ist kein einziger Snapshot fehlgeschlagen.
Alle drei Zielwerte wurden trotzdem verfehlt. Die Budget-Schätzung vor dem Umbau hatte für den unveränderten Lauf 0,5 bis 1,5 Sekunden und für das vollständige Neuschreiben 2,5 bis 5 Sekunden vorhergesagt. Die Erklärung liefert die letzte Zeile der Tabelle. Ein Refresh über eine Verbindung ohne gespeicherte Tabellen liest nur die Tabellen-Liste und schreibt nichts, und er dauert trotzdem 2,7 Sekunden. Das ist der feste Sockel jedes Aufrufs an den Anwendungs-Server. Er umfasst unter anderem Anmelde- und Berechtigungsprüfungen, das zweimalige Lesen der Tabellen-Auswahl vor und nach dem Schreiben und die Aufbereitung der Antwort, auf einer Maschine, die sich den Arbeitsspeicher mit weiteren Diensten teilt. Gemessen ist nur die Summe, die Anteile wurden nicht einzeln erhoben. Über diesem Sockel wächst die neue Logik beim unveränderten Lauf um rund 3,7 Millisekunden pro Tabelle, über 1000 Tabellen also um 3,7 Sekunden. Beide Anteile zusammen ergeben das obere Ende der gemessenen 5,8 bis 6,4 Sekunden (2,7 + 3,7). Der Sockel ist dabei eine Untergrenze aus dem Leerlauf, denn das Lesen der Tabellen-Auswahl wächst mit der Tabellen-Anzahl. Ein Lauf, der alle 1000 Tabellen neu schreibt, braucht pro Tabelle mehr als diese 3,7 Millisekunden, weil er zusätzlich 50.000 Zeilen löscht und neu einfügt.
Bevor diese Erklärung gelten durfte, wurde eine naheliegende Alternative ausgeschlossen. Auf der Maschine lagen zwei Gigabyte im Auslagerungsspeicher. Er wurde geleert und die Messung wiederholt, mit praktisch gleichem Ergebnis. Damit war Swap als Ursache weitgehend ausgeschlossen, andere Einflüsse der geteilten Maschine blieben offen. Dass Swap auf demselben Server schon einmal die Ursache einer trägen Anwendung war, beschreibt der Artikel Der Agent misst, wo der Mensch klickt. Den geteilten Server selbst stellt der Artikel Ein Server, vier Umgebungen, kein Cookie-Banner vor.
Solange die Schleife 114 Sekunden brauchte, machten 2,7 Sekunden Sockel gut zwei Prozent der Laufzeit aus und fielen niemandem auf. Nach dem Umbau sind es beim unveränderten Lauf gut 40 Prozent. Wer die Kosten pro Element beseitigt, legt die festen Kosten frei, und eine Budget-Rechnung sollte sie deshalb von Anfang an enthalten. Den Sockel weiter zu senken, hätte Arbeit außerhalb des Snapshot-Codes bedeutet. Die Entscheidung fiel, die Abweichung zu dokumentieren und nicht weiter zu optimieren, weil das eigentliche Problem beseitigt war: Es gibt keine minutenlangen Läufe mehr, keinen Timeout und keine gestapelten Klicks.
Wenn eine Optimierung die Bedeutung einer Anzeige ändert
Das Überspringen unveränderter Tabellen hat zwei Folgen, die mit Geschwindigkeit nichts zu tun haben.
Die erste betrifft den Zeitstempel. Jede Snapshot-Zeile trägt den Zeitpunkt, zu dem sie geschrieben wurde, und das Tabellen-Register zeigt daraus den „Stand“ einer Tabelle. Solange jeder Refresh jede Tabelle neu schrieb, war dieser Zeitpunkt zugleich der Zeitpunkt der letzten Prüfung gegen die Quelle, denn beides geschah im selben Moment. Mit dem Überspringen fällt das auseinander. Ein Beispiel: Eine Tabelle wurde vor drei Wochen zuletzt neu geschrieben und hat sich seitdem in der Quelle nicht geändert. Der Refresh von heute prüft sie, findet sie unverändert und überspringt sie. Ihre Snapshot-Zeilen behalten damit den Zeitstempel von vor drei Wochen. Würde das Register weiter diesen Zeitstempel als „Stand“ zeigen, stünde bei einer Tabelle, die vor einer Minute geprüft wurde, ein drei Wochen altes Datum, und der Benutzer müsste annehmen, der Refresh habe sie übergangen. Deshalb gibt es seit dem Umbau zwei Zeitpunkte. Der Snapshot-Zeitstempel bewegt sich nur noch, wenn sich an der Quelle tatsächlich etwas geändert hat, und wird damit zum Änderungsdatum. Den Zeitpunkt der letzten Prüfung schreibt der Refresh als eigenen Stempel, auch für jede übersprungene Tabelle.
Die zweite betrifft die Erfolgsmeldung. Vorher meldete sie, wie viele Snapshots aktualisiert wurden, und bei 1000 Tabellen stand dort immer 1000. Nach dem Umbau ist „nichts geändert“ der Normalfall, die Zahl der neu geschriebenen Tabellen steht dann auf null, und die bestehende Meldung hätte „keine Änderungen“ angezeigt. Der aufwendigste Kontrollgriff, bei dem 1000 Tabellen live gegen die Quelle geprüft werden, hätte damit exakt dieselbe Meldung erzeugt wie ein Lauf über eine leere Verbindung. Die Meldung nennt deshalb beide Zahlen, also wie viele Tabellen unverändert blieben und wie viele neu geschrieben wurden.
Wer eine Schleife durch set-basierte Anweisungen ersetzt und dabei Arbeit überspringt, sollte die Anzeigen und Meldungen mitprüfen, die auf dem alten Verhalten beruhen. Andernfalls wird aus „es wurde viel geprüft“ stillschweigend „es wurde nichts gefunden“, und der Nutzer verliert genau die Bestätigung, für die er geklickt hat.
Was davon bleibt
- Eine Iteration kostet Arbeit und alles, was sie zusätzlich überquert. Innerhalb der Datenbank kostete eine Iteration rund drei Millisekunden, über Verbindung und Anwendung hinweg 114. Die sinnvolle Frage lautet deshalb nicht, ob eine Schleife erlaubt ist, sondern was jede Iteration über die eigentliche Arbeit hinaus bezahlt und wie oft sie läuft.
- Das Budget pro Element steht vor jeder Optimierung. Drei Millisekunden pro Tabelle haben die Wiederverwendung der Verbindung als alleinige Lösung erledigt, bevor jemand sie gebaut hat. Das Budget muss die festen Kosten enthalten, sonst verfehlt es den Zielwert an einer Stelle, an der niemand sucht.
- Nach dem Umbau gehört der Ausführungsplan auf den Tisch. Die erste Mengen-Abfrage war langsamer als die Einzel-Abfragen, weil der Planer sie als Nested Loop über eine ganze Systemtabelle ausführte. Ein
loops=-Wert in Höhe der äußeren Zeilen ist der Anlass, sich den betroffenen Teilplan anzusehen, und teuer wird es, wenn er pro Durchlauf eine ganze Systemtabelle liest. - Ein Äquivalenz-Beweis findet auch Fehler im alten Code. Der Vergleich vor und nach dem Umbau hat eine Rechte-Lücke aufgedeckt, durch die jahrelang leere Schlüssel-Snapshots gespeichert wurden.
- Übersprungene Arbeit verändert die Bedeutung von Anzeigen. Zeitstempel und Erfolgsmeldung mussten neu definiert werden, obwohl sich an ihrem Code nichts geändert hatte.
FAQ
Nein. Set-basiert heißt dasselbe wie mengenbasiert oder mengenorientiert: eine Anweisung über alle Zeilen statt einer je Zeile. Sie ist häufig schneller, weil die Datenbank die Arbeit über die Menge gemeinsam planen kann und pro Element weniger Fixkosten anfallen, eine Garantie ist das aber nicht. Wie groß der Abstand ist, hängt davon ab, was eine Iteration kostet. Innerhalb der Datenbank war die Schleife im Nachbau rund fünfmal langsamer, bei wenigen Dutzend Elementen fällt das kaum ins Gewicht. Deutlich teurer wird sie, wenn jede Iteration eine eigene Verbindung, Transaktion oder einen Netzwerk-Aufruf mitbringt. Wählt der Planer für die set-basierte Anweisung einen Plan, der sie intern wieder Element für Element ausführt, ist sie sogar langsamer als die Schleife, wie die Fallstudie zeigt.
Beide bearbeiten eine Menge Element für Element und unterscheiden sich darin, wie viele Systemgrenzen jedes Element dabei überquert. Beim N+1-Problem lädt ein ORM zuerst eine Liste und setzt danach für jedes Element eine eigene Abfrage ab, jede davon ein eigener Weg zur Datenbank. Eine Cursor-Schleife in einer Prozedur wiederholt die Arbeit dagegen innerhalb der Datenbank, ohne zusätzliche Abfragen von außen. Die Fallstudie zeigt eine dritte Variante, bei der Anwendungs-Code pro Element sogar eine neue Verbindung öffnet. Jede Grenze zwischen Schleife und Daten, also eine Verbindung, ein Prozess oder eine Transaktion, erhöht die festen Kosten einer Iteration.
information_schema manchmal so langsam? Die Sichten in information_schema sind selbst Abfragen über mehrere Systemtabellen. Verbindet man zwei davon, kann es passieren, dass der Abfrage-Planer von Postgres die Join-Bedingung nicht in die Sichten hineinschieben kann und eine Sicht für jede Zeile der anderen vollständig auswertet. Im Ausführungsplan erkennt man das an einem Nested Loop, dessen innerer Teilplan eine ganze Systemtabelle liest und einen loops=-Wert in Höhe der äußeren Zeilen trägt, hier der Tabellen-Anzahl. Ob es passiert, hängt von Abfrage und Version ab: Die Schlüssel-Abfrage war auf Postgres 17 betroffen und auf Postgres 18 nicht, der Join von Spalten und Tabellen war es auf beiden. Abhilfe schafft eine Abfrage direkt auf pg_catalog oder eine einzelne Sicht ohne Join.
information_schema.table_constraints keine Schlüssel? Diese Sicht zeigt nur Tabellen, die der Rolle gehören oder auf denen sie ein anderes Recht als SELECT besitzt. information_schema.columns zeigt die Spalten dagegen schon bei SELECT. Eine Rolle, die auf einer Tabelle nur SELECT darf, sieht dadurch alle ihre Spalten, aber keinen ihrer Primär- oder Unique-Schlüssel. Wer die Schlüssel für eine solche Rolle braucht, liest sie aus pg_constraint und prüft die Sichtbarkeit selbst. Die Abfrage der Fallstudie bildet dabei die Regel von information_schema.columns nach und nicht die von table_constraints: Sie zeigt einer Rolle die Schlüssel, wenn sie Eigentümerin der Tabelle ist, geprüft mit pg_has_role, oder ein Recht auf der Spalte hat, geprüft mit has_column_privilege.
Das COMMIT allein genügt dafür nicht. Es sichert, was schon geschrieben ist, beendet den Aufruf beim ersten unbehandelten Fehler aber trotzdem. Weiterlaufen kann die Schleife nur, wenn jeder Durchlauf seinen eigenen BEGIN … EXCEPTION-Block bekommt, der den Fehler fängt und einen Zähler hochsetzt. Fängt der Block einen Fehler, hat Postgres die Änderungen dieses Durchlaufs schon zurückgenommen, denn ein Block mit Fehlerbehandlung läuft als Untertransaktion. Das COMMIT dahinter hat für diese Tabelle dann nichts mehr festzuschreiben, und ein halber Snapshot kann nicht entstehen. Dabei gibt es eine Falle: Das COMMIT muss hinter diesen Block, nicht hinein. Innerhalb eines Blocks mit Fehlerbehandlung scheitert es an cannot commit while a subtransaction is active, und ein WHEN OTHERS-Handler verschluckt genau diesen Fehler still. Die Prozedur läuft dann fehlerfrei durch und schreibt nichts.
Die Dauer lässt sich aus den geschriebenen Daten ablesen. Schreibt jede Iteration ihre Zeilen in einer eigenen Transaktion und stempelt sie mit now(), liefert die Spanne zwischen kleinstem und größtem Zeitstempel nach einem ungestörten Lauf die Dauer der Schleife bis auf den letzten Durchlauf. Läuft alles in einer einzigen Transaktion, liefert now() überall denselben Wert, und die Spalte braucht dann clock_timestamp() als Default. Auf Dauer ersetzt das keine Instrumentierung, aber es funktioniert nachträglich und ohne jede Code-Änderung.
Verwandte Artikel
Weiterführend:
- Design Pattern // Architektur eines ETL-Prozesses — in welcher Stufe einer ETL-Strecke Katalog-Lesungen wie diese ihren Platz haben.
- Prüfregeln aus dem Schema ableiten — wie Pflichtfelder, Schlüssel und Typ-Grenzen aus
information_schemazu Prüfregeln werden.
Aus demselben Projekt:
- Der Agent misst, wo der Mensch klickt — vier Fehlersuchen, in denen eine Messung die Vermutung ersetzt hat.
- Ein Server, vier Umgebungen, kein Cookie-Banner — die geteilte Maschine, auf der auch diese Messungen liefen.
- Agentic Coding aus Anwender-Sicht — wie die Arbeit mit einem Coding-Agenten den Alltag verändert.