In der DI²-Anwendung ließ sich eine Prüfregel nicht speichern. Der Dialog bot dem Nutzer eine Spalte an, die im Projekt noch nicht ausgewählt war. Ein Klick auf diese Spalte hätte diese selbst auswählen müssen. In einem bestimmten Fall tat er das nicht, und der Server lehnte die Regel ab. Ein Coding-Agent schrieb einen Fix. Er lagerte die Prüfung, ob eine Spalte erst ausgewählt werden muss, aus dem Dialog in eine eigene Funktion aus und ergänzte zwölf Unit-Tests dafür. Alle zwölf waren grün, und die gesamte Test-Suite mit 773 Tests war es auch.
Ob der Fehler damit behoben war, stand noch nicht fest. Bevor er geschlossen wurde, kontrollierte ein Agent den Fix in einem eigenen Prüfdurchgang. Dabei kam eine Frage auf, die ein grüner Lauf nicht beantwortet: Würde einer der zwölf Tests rot, wenn der Fehler zurückkäme? Die Antwort war nein.
Die zwölf Tests rufen die Funktion direkt auf und prüfen, ob sie richtig antwortet. Ob der Dialog die Funktion überhaupt benutzt, sehen sie nicht. Der Fehler saß aber im Dialog, an der Aufrufstelle. Das ist die Stelle im Programm, an der der Dialog die Funktion fragt und danach den Server aufruft oder es bleiben lässt. Auf eine Kurzform gebracht heißt das: Unit-Test grün, Integration kaputt. Genauer gesagt besteht jeder Baustein seine Tests, und die Anwendung ist trotzdem fehlerhaft, weil ein Baustein nicht oder falsch eingebaut ist.
Die Kurzfassung dieses Falls steht im Überblick Der grüne Test, der nichts beweist, der drei Wege beschreibt, auf denen ein grüner Test am Fehler vorbeiführt. Dieser Artikel erzählt den zweiten Weg aus der Sicht dessen, der den Code nicht lesen kann. Er zeigt, was am Bildschirm zu sehen war, mit welcher Frage sich herausstellte, dass kein Test den Fehler bemerken würde, und welche drei Fragen sich daraus für jeden Fix ableiten lassen. Das gilt nicht nur für Oberflächen. Auch in der Datenbank kann eine SQL-Funktion getestet sein, während die Prozedur, die sie aufrufen soll, einen anderen Weg nimmt, und darauf geht ein eigener Abschnitt ein.
Fix, Tests und Prüfdurchgang stammen von Claude Code mit dem Modell Claude Fable 5. Der Maintainer des Projekts kennt TypeScript nicht. Er hat den Fehler bei einem manuellen Testfall am Bildschirm gefunden, den Prüfdurchgang angestoßen und vor dem Schließen den zugehörigen Testfall selbst ausgeführt.
Das Wichtigste vorab:
- Was die zwölf Tests nicht sehen, zeigt sich erst im Lauf gegen den alten, fehlerhaften Stand: Der Prüf-Agent schrieb dafür einen Test, der den Dialog bedient wie ein Nutzer, und gegen den Stand vor dem Fix wurde dieser Test rot. Einen solchen Test bekam das Projekt 45 Minuten nach dem Fix dauerhaft.
- Ob nach einem Fix ein Test an der richtigen Stelle sitzt, lässt sich erfragen, ohne den Code zu lesen: Drei Fragen genügen dafür, nämlich wo der Fehler saß, ob ein Test rot wird, wenn diese Stelle auf den alten Stand zurückgedreht wird, und ob ein fehlender Test Absicht oder ein Versehen ist. Die Antworten sind ein Satz und zwei Test-Läufe, und beides kann auch beurteilen, wer die Sprache nicht kennt.
- Im Projekt ist der Fall zum Vorbild geworden: Sechs spätere Test-Suiten prüfen wie er, ob ein getesteter Baustein auch richtig eingebaut ist, und für die Verbindung zwischen einem Baustein und der Stelle, die ihn benutzt, hat das Projekt ein eigenes Wort: Verdrahtung. Einen Test bekommt trotzdem nicht jede Verbindung. Wo das Projekt bewusst darauf verzichtet, trägt es die Stelle mit einer Begründung in eine Liste ein.
Voraussetzung: Keine. Das Code-Beispiel stammt aus einer React-Anwendung, die mit Vitest getestet wird, und wer kein TypeScript liest, versteht den Artikel auch ohne es. Das Prinzip gilt überall, wo ein Stück Logik in eine eigene Funktion ausgelagert und getrennt von ihrem Aufrufer getestet wird. Wie im Überblick meint Test eine automatisierte Prüfung, die grün oder rot endet, und Testfall einen aufgeschriebenen Ablauf mit Erwartungen, den ein Mensch am Bildschirm ausführt.
Inhalt
- Der Fehler: eine Spalte, die niemand auswählte
- Der Fix: eine eigene Funktion und zwölf Tests
- Die Frage, die ein grüner Lauf nicht beantwortet
- Der Komponenten-Test an der Aufrufstelle
- Drei Fragen, für die man den Code nicht lesen muss
- Was im Projekt daraus wurde
- In SQL gilt dasselbe: Funktion getestet, Prozedur nicht
- Arbeits-Prompts als Beispiel
- Zusammenfassung
- FAQ
- Verwandte Artikel
Der Fehler: eine Spalte, die niemand auswählte
In der DI²-Anwendung lassen sich für die Spalten einer Tabelle Prüfregeln anlegen, etwa eine Liste zulässiger Werte oder ein Wertebereich. Das geschieht in einem Dialog. Sein Feld für die Spalte bietet auch Spalten an, die im Projekt noch nicht ausgewählt sind, und kennzeichnet sie mit der Markierung „NEU“. Wählt der Nutzer eine solche Spalte, soll die Anwendung sie im selben Moment im Projekt auswählen. Das ist ein Schreibvorgang auf dem Server, noch bevor die Regel gespeichert ist.
Das Bild zeigt den Dialog in der Testumgebung am 14. September 2026, also nach dem Fix. Das Feld ist aufgeklappt, denn nur dort ist die Markierung zu sehen, und mit dem Klick auf eine Spalte verschwindet die Markierung wieder.
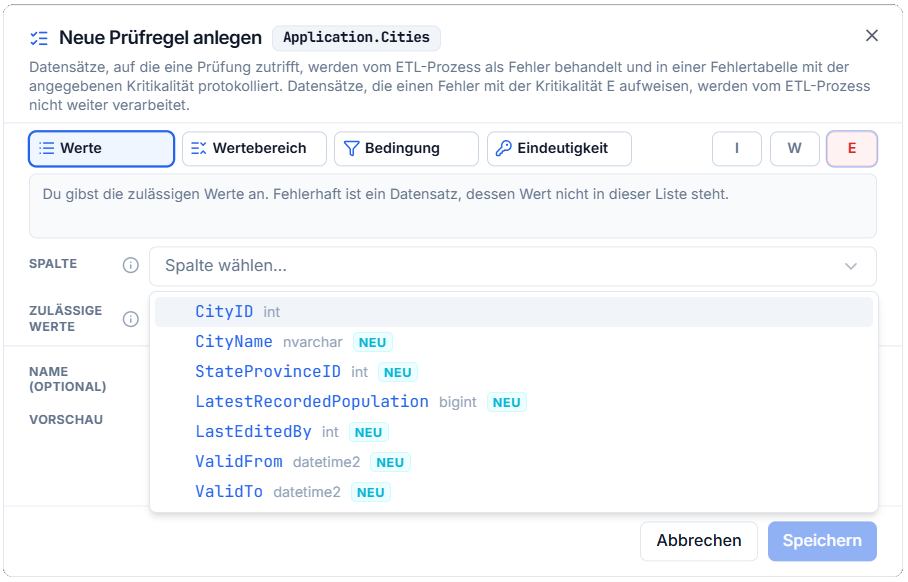
Gefunden hat den Fehler kein Test und kein Agent. Am 28. August 2026 führte der Maintainer einen manuellen Testfall aus und versuchte dabei, eine Prüfregel auf eine andere Spalte umzuziehen. Er wählte dafür die Spalte StateProvinceID, die in der Liste die Markierung „NEU“ trug. Der Dialog meldete keinen Fehler, der Knopf zum Speichern war aktiv, und trotzdem lehnte der Server die Regel ab, weil sie sich auf eine nicht ausgewählte Spalte bezog.
Der Fehlerbericht vom selben Abend ließ die Ursache noch offen, am nächsten Tag war sie bestätigt. Der Grund liegt darin, woran der Dialog erkannte, ob dieser Aufruf an den Server nötig ist. Jede Spalte in der Liste trägt einen internen Wert. Spalten, die die Anwendung schon einmal erfasst hat, tragen ihre Kennung, eine Zahl. Spalten, die noch nie erfasst wurden, tragen stattdessen ihren Namen. Der Dialog nahm diesen Wert als Hinweis: Steht da ein Name, ist die Spalte neu und muss ausgewählt werden. Steht da eine Kennung, ist sie schon ausgewählt, und es gibt nichts zu tun.
Das stimmt aber nicht immer. Eine Spalte, die einmal ausgewählt und dann wieder abgewählt wurde, behält ihre Kennung und ist trotzdem nicht mehr ausgewählt. Die Liste zeigte für sie „NEU“, denn die Markierung fragt den tatsächlichen Zustand ab. Der Dialog sah nur die Kennung, hielt die Spalte für ausgewählt und ließ den Aufruf weg. Der Server prüfte danach den tatsächlichen Zustand und lehnte die Regel ab. Auf dem Server war dabei alles in Ordnung, denn die Prozedur hinter dem Aufruf wählt eine abgewählte Spalte ausdrücklich wieder aus. Es fehlte allein der Aufruf.
Der Fix: eine eigene Funktion und zwölf Tests
Der Fix kam am 29. August 2026 um 13:37 Uhr. Seitdem prüft der Dialog nicht mehr, wie der Wert aussieht, sondern ob die Spalte ausgewählt ist. Genau daran hängt auch die Markierung „NEU“, und was die Liste anzeigt und was der Dialog tut, kann sich nicht mehr widersprechen. Zugleich lagerte der Fix diese Prüfung aus dem Dialog in eine reine Funktion aus. So heißt eine Funktion, deren Ergebnis allein von ihren Eingaben abhängt und die außer diesem Ergebnis nichts verändert. Am nächsten kommt dem in Postgres eine Funktion, die als IMMUTABLE deklariert ist. Mit dieser Angabe sichert ihr Autor zu, dass sie keine Tabelle liest oder ändert und für dieselben Eingaben immer dasselbe Ergebnis liefert. Eine reine Funktion braucht deshalb keinen Dialog, keinen Browser und keinen Server, und ein Test kann sie mit vorbereiteten Werten in Millisekunden prüfen.
Die Funktion bekommt den Wert aus der Liste und alle Spalten der Tabelle und antwortet mit einem Plan. Der Plan sagt dem Dialog, ob dieser die Kennung direkt verwenden kann oder die Spalte erst auf dem Server auswählen muss. Zwölf Unit-Tests rufen die Funktion mit vorbereiteten Spalten auf und vergleichen den Plan. Im Beispiel heißt die Funktion decidePick, und der Test für den Fall aus dem Fehlerbericht sieht so aus:
  1: it("eine erfasste, aber abgewählte Spalte muss ausgewählt werden", () => {
  2:   const columns = [
  3:     { id: "100", name: "CityID", isSelected: true },
  4:     { id: "101", name: "StateProvinceID", isSelected: false },
  5:   ]
  6:
  7:   expect(decidePick("101", columns)).toEqual({
  8:     kind: "select",
  9:     columnName: "StateProvinceID",
 10:   })
 11: })
In den Zeilen 2 bis 5 steht die Spalte StateProvinceID mit einer Kennung und als nicht ausgewählt, so wie im Fehlerbericht. Die Zeilen 7 bis 10 erwarten den Plan select, also das Auswählen auf dem Server. An diesem Test ist nichts auszusetzen, denn er stellt genau die Lage her, in der der Fehler auftrat, und prüft das richtige Ergebnis. Die Commit-Nachricht vermerkte allerdings, dass der Prüfdurchgang noch aussteht.
Das Auslagern war richtig. Es hat allerdings eine Nebenwirkung, die leicht zu übersehen ist: Getestet wird jetzt die Funktion, und der Dialog, der sie aufruft, bleibt ohne Test. In dem ganzen Test oben kommt der Dialog nicht vor.
Die Frage, die ein grüner Lauf nicht beantwortet
37 Minuten nach dem Fix lag der Bericht des Prüfdurchgangs vor. Er umfasst elf Prüfpunkte, und alle elf sind bestanden. Die meisten betreffen den Server und benachbarte Fälle. Zwei betreffen die Aufrufstelle: Ruft der Dialog das Auswählen für den gemeldeten Fall wirklich auf, und schlägt dieselbe Prüfung gegen den Stand vor dem Fix fehl?
Für die erste Frage schrieb der Prüf-Agent einen Komponenten-Test. So heißt ein Test, der ein Stück der Oberfläche in einer nachgebildeten Browser-Umgebung aufbaut und es bedient wie ein Nutzer. Der Test baute den Dialog auf, klickte die abgewählte Spalte an und prüfte, ob der Aufruf zum Auswählen abgesetzt wird, und gegen den Fix war der Test grün. Für die zweite Frage lief derselbe Test gegen den Stand vor dem Fix. Dort schlug er fehl, der Bericht vermerkt null Aufrufe. Erst dieser rote Lauf zeigt, dass der Test den gemeldeten Fehler tatsächlich erkennt. Die Methode dahinter beschreibt der Überblick als Gegenprobe gegen den alten Stand, der Prüfbericht nennt sie Negativ-Kontrolle.
Aus den beiden Läufen folgte ein weiterer Befund. Er betrifft den Regressionsschutz, also die Tests, die sich melden sollen, wenn ein einmal beseitigter Fehler zurückkehrt. Der Bericht formuliert ihn sinngemäß so:
Lücke im Regressionsschutz: Die zwölf neuen Tests prüfen ausschließlich die reine Funktion. Wer den Dialog auf die alte Prüfung zurückdreht, bekommt die reine Funktion weiterhin grün. Genau die Stelle, an der der Fehler saß, ist unbewacht.
Baut jemand im Dialog die alte Prüfung wieder ein, etwa beim Aufräumen oder weil ein Agent in einer späteren Sitzung den früheren Code für einfacher hält, dann ist der Fehler zurück, und keiner der zwölf Tests meldet es. Die Funktion antwortet weiterhin richtig, nur fragt sie niemand mehr.
Man muss dazusagen, dass in diesem Fall kein Fehler überlebt hat. Der Fix war richtig, und dass der Dialog ohne Test dastand, fiel auf, bevor dort wieder etwas kaputtging. Den Fehler fand ein Mensch mit einem manuellen Testfall am Bildschirm, und dass ihn künftig kein Test mehr bemerken würde, fand die Frage nach dem alten Stand.
Den Komponenten-Test selbst übernahm der Prüf-Agent nicht ins Projekt. Der Test diente nur dem Bericht, und dort blieb ein Rezept zurück, nach dem sich ein dauerhafter Test schreiben lässt.
Der Komponenten-Test an der Aufrufstelle
Acht Minuten nach dem Bericht und 45 Minuten nach dem Fix stand ein solcher Komponenten-Test dauerhaft im Projekt. Er kam in einem Commit, der sich in erster Linie gegen zwei verwandte Fehler im selben Dialog richtet. Mit diesem Commit kam auch die erste Test-Datei, die den Dialog überhaupt aufbaut. Bis dahin hatte das kein einziger Test getan.
Insgesamt sind es drei Tests an der Aufrufstelle. Jeder baut den Dialog auf, klickt eine Spalte an und sieht nach, ob daraufhin der Aufruf an den Server folgt oder ausbleibt. Gegen die alte Prüfung im Dialog wird einer von ihnen rot, während die zwölf Tests der Funktion grün bleiben. Die beiden anderen decken Fälle ab, die schon mit der alten Prüfung richtig liefen, damit eine spätere Änderung sie nicht unbemerkt beschädigt.
Ein solcher Test kostet mehr als ein Test der reinen Funktion, weil er Ersatz für alles braucht, was der nachgebildeten Umgebung fehlt, vom Server bis zu einzelnen Fähigkeiten des Browsers. Solche Ersatz-Bausteine heißen Mocks oder Stubs. Dass ein solcher Ersatz selbst eine falsche Annahme festhalten kann, ist das Thema des ersten Wegs im Überblick.
Der Prüfbericht hatte den Fehler schon als bereit zum Schließen gemeldet, obwohl ein Nachweis noch fehlte. Den Weg am Bildschirm hatte der Prüf-Agent nur als manuellen Testfall aufgeschrieben und nicht selbst durchgeklickt, weil in seiner lokalen Umgebung die Anmeldung fehlte. Dieser Testfall war bis dahin nie gelaufen, und erst am Nachmittag führte der Maintainer ihn aus. Was der erste Lauf am Testfall selbst fand, steht im Artikel Die erste Ausführung testet den Testfall, und warum ein geschriebener Testfall noch kein Nachweis ist, im Artikel Manuelle Testfälle schreiben. Am frühen Abend war der Fehler geschlossen.
Drei Fragen, für die man den Code nicht lesen muss
Aus dem Fall lässt sich eine Regel ableiten: Wer Logik aus einer Komponente wie dem Dialog in eine Funktion auslagert, sorgt dafür, dass auch die Stelle abgesichert bleibt, an der der Fehler saß. Das ist die Stelle, die die Funktion aufruft und nach ihrem Ergebnis handelt. Oft leistet das ein Test an dieser Stelle, aber nicht immer, wie der nächste Abschnitt zeigt. Ob die Stelle abgesichert ist, lässt sich mit drei Fragen klären, und keine von ihnen verlangt, den Test lesen zu können:
- Wo saß der Fehler, und kommt diese Stelle in einem der neuen Tests vor? Im Dialog-Fall lautete die Antwort nein. Ein Coding-Agent kann sie in einem Satz geben, wenn man ihn danach fragt.
- Wird ein Test rot, wenn diese Stelle auf den alten Stand zurückgedreht wird? Das ist die Gegenprobe gegen den alten Stand aus dem Überblick. Ihr Ergebnis sind zwei Läufe, und beide sind ohne Kenntnis der Sprache zu beurteilen.
- Und wenn kein Test diese Stelle prüft, ist das Absicht oder ein Versehen? Ein grüner Lauf beantwortet das nicht, denn er sieht in beiden Fällen gleich aus. Beantworten lässt es sich nur, wenn die Absicht irgendwo aufgeschrieben ist, und wie das DI²-Projekt das handhabt, steht im nächsten Abschnitt.
Was im Projekt daraus wurde
Im DI²-Projekt blieb es nicht bei den drei Tests am Dialog. Das Projekt gibt seinen Coding-Agenten Regeln mit, und zu den Regeln für Tests gehört eine Tabelle, die für jede Test-Datei festhält, was sie absichert. In der Zeile für die neue Test-Datei des Dialogs steht seitdem, dass drei ihrer Tests die Verdrahtung der ausgelagerten Funktion absichern. Mit Verdrahtung meint das Projekt die Verbindung zwischen einem Baustein und der Stelle, die ihn benutzt. Andernorts heißt das Integration, und hier geht es um ihren kleinsten Fall, eine Funktion und ihren Aufrufer.
Ein eigenes Wort wie Verdrahtung hilft bei der Arbeit mit Coding-Agenten besonders. Ein Agent beginnt jede Sitzung ohne Erinnerung an die vorige, aber er liest, was in den Regeln steht. Findet er dort das Wort mit einem Beispiel, kann er eine ungeprüfte Verdrahtung bei der nächsten Aufgabe wiedererkennen.
Im Projekt ist das seitdem sechsmal geschehen. Zwischen dem 8. und dem 13. September 2026 entstanden sechs Test-Suiten, die sich ausdrücklich auf diesen Fall berufen. Fünf tun das in der Tabelle, die sechste im Kommentar ihrer Test-Datei, und gezählt wurde am 18. September 2026. Das Muster war jedes Mal dasselbe: Ein Baustein war für sich getestet, und ob die Stelle, die ihn benutzt, das auch richtig tut, prüfte nichts. In einem dieser Fälle lieferte ein Baustein die Adresse einer Seite, und ein zweiter zeigte diese Adresse als Link an. Beide waren getestet, aber kein Test prüfte, ob die vier Ansichten, die den Link zeigen sollen, die Adresse auch weiterreichen. Hätte eine von ihnen das vergessen, wäre der Link dort verschwunden, ohne dass ein Test rot geworden wäre. Die sechs Suiten stehen nicht für sechs durchgerutschte Fehler, sondern dafür, dass dieselbe Lücke immer wieder entsteht und im Projekt inzwischen erkannt wird.
Nicht jede Verbindung bekommt einen Komponenten-Test
Die Antwort auf eine ungeprüfte Verbindung ist nicht immer ein Komponenten-Test. Das Projekt kennt drei weitere Antworten. Für den Link aus dem Beispiel liest ein Test den Quelltext der vier Ansichten und prüft, ob jede von ihnen die Adresse weiterreicht. Ein Komponenten-Test stünde hier in keinem Verhältnis zur Frage, weil diese Ansichten zwischen 1800 und 6100 Zeilen lang sind und ein Test sie samt allem aufbauen müsste, was an ihnen hängt. Eine andere Verbindung sichert die Typprüfung, eine automatische Prüfung des Quelltexts. Liefert eine der Funktionen, die die Daten für eine Ansicht laden, ein verlangtes Feld nicht mehr mit, scheitert die Typprüfung schon vor dem ersten Lauf. In beiden Fällen ist per Gegenprobe belegt, dass die Absicherung anschlägt.
Was bewusst ohne Test bleibt
Die dritte Antwort ist, eine Stelle vorerst ohne Test zu lassen und genau das aufzuschreiben. Der Grund steht in denselben Regeln: Dateien, die auf die Datenbank zugreifen, bekommen im Projekt vorerst keine Unit-Tests, weil die Test-Umgebung dafür erst noch gebaut wird. Diese Regel hat eine Nebenwirkung. Fehlt an einer solchen Datei ein Test, kann niemand mehr erkennen, ob er wegen der Regel fehlt oder weil niemand daran gedacht hat, denn ein grüner Lauf sieht in beiden Fällen gleich aus.
Seit dem 6. September 2026 führt das Projekt deshalb eine Liste. Wer eine Stelle bewusst ohne Test lässt, trägt sie dort ein und hält fest, warum der Test fehlt, was eine spätere Änderung unbemerkt zerstören würde und wodurch die Lücke einmal geschlossen werden soll. Für alles, was nicht in der Liste steht, gilt umgekehrt, dass der Test aus Versehen fehlt. Der erste Eintrag stammt aus dem Teil der Anwendung, der in die Postgres-Datenbank schreibt. Dort gehen mehrere Datensätze in einer Transaktion in die Datenbank, und jeder ist mit einem eigenen SAVEPOINT abgesichert, auf den die Anwendung im Fehlerfall mit ROLLBACK TO SAVEPOINT zurücksetzt. Entfernt jemand diese Anweisungen, bricht ein einziger fehlerhafter Datensatz die Transaktion ab, und Postgres verwirft auch alle schon geschriebenen. Bei einer Gegenprobe am 6. September wurden die Anweisungen testweise entfernt. Die Suite war bis dahin auf 1101 Tests gewachsen, und alle 1101, die Typprüfung, der Linter und das SQL-Prüfskript blieben grün. Ein weiterer Eintrag betrifft genau das Muster dieses Artikels, denn dort ist eine Funktion getestet und ihr Aufruf beim Speichern nicht. Die Liste ist damit die Antwort des Projekts auf die dritte der drei Fragen.
In SQL gilt dasselbe: Funktion getestet, Prozedur nicht
Was für den Dialog gilt, gilt auch in der Datenbank. Eine SQL-Funktion, die zum Beispiel prüft, ob ein Text leer ist, lässt sich mit einigen SELECT-Aufrufen direkt testen. Ob die Prozedur, die Daten lädt, diese Funktion an der richtigen Stelle aufruft oder stattdessen eine eigene, ältere Bedingung verwendet, zeigt erst ein Lauf der Prozedur gegen Testdaten. Die Tests der Funktion bleiben in beiden Fällen grün.
Das DI²-Projekt kennt die Trennung zwischen der Prüfung eines einzelnen Bausteins und der Prüfung des Zusammenspiels auch aus seiner Datenbank-Entwicklung. Ein Prüfskript liest jede SQL-Datei einzeln und findet Verstöße gegen die Konventionen. Ob sich alle Dateien zusammen in eine leere Datenbank einspielen lassen, zeigt erst ein eigener Lauf gegen eine Wegwerf-Datenbank. Auch dieser Lauf hat eine Grenze: Die SQL-Anweisungen im Körper einer PL/pgSQL-Prozedur löst Postgres beim Anlegen nicht gegen die Datenbank auf. Ob die Tabellen und Spalten existieren, die sie ansprechen, stellt sich deshalb erst beim ersten Aufruf heraus. Beschrieben sind Prüfskript und Lauf im Artikel Warum sqlfluff unsere SQL-Konventionen nicht prüfen kann.
Arbeits-Prompts als Beispiel
Die Sitzungen, in denen der Fall bearbeitet wurde, sind nicht versioniert. Die zwei Prompts hier sind aus dem Fehlerbericht, dem Prüfbericht und den Commit-Nachrichten abgeleitet und keine Zitate. Den allgemeinen Prompt für die Gegenprobe zeigt der Überblick.
Der erste Prompt gibt einem Prüfdurchgang die Frage mit, ob einer der neuen Tests den Fehler bemerken würde:
Der Fix ist drin, und die zwölf neuen Tests sind grün. Prüf, ob einer von
ihnen den Fehler melden würde, wenn er zurückkäme: Stell im Dialog
vorübergehend die alte Prüfung wieder her und lass die Suite laufen.
Abnahme: Ich sehe zwei Läufe, einen mit der alten Prüfung und einen mit
dem Fix. Bleibt beim ersten alles grün, fehlt ein Test an der Stelle, an
der der Fehler saß. Schreib dann auf, welcher Test das wäre.
Im Projekt beantwortete der Prüf-Agent diese Frage mit dem Komponenten-Test aus dem Abschnitt oben. Er ließ ihn gegen den Stand vor dem Fix laufen, hielt das Ergebnis mit null Aufrufen im Bericht fest und schrieb das Rezept für den dauerhaften Test dazu.
Der zweite Prompt übergibt dieses Rezept an die Umsetzung:
Der Prüfbericht nennt eine Lücke im Regressionsschutz und ein Rezept
dafür. Setz die drei Fälle als dauerhafte Tests um, genau nach dem
Rezept im Bericht.
Abnahme: Gegen die alte Prüfung im Dialog wird der erste Fall rot, und
die zwölf Tests der Funktion bleiben grün. Beide Läufe stehen im Commit.
Beide Prompts formulieren, was geprüft werden soll und woran das Ergebnis abgenommen wird. Sie enthalten keine Dateinamen, keine Bibliotheken und keine Test-Technik, denn die hätte der Maintainer nicht vorgeben können. Welche Bausteine im Test zu ersetzen sind und wie der Dialog geöffnet werden muss, stand im Bericht des Prüf-Agenten.
Zusammenfassung
- Wer Logik in eine reine Funktion auslagert, testet danach die Funktion und nicht den Aufrufer: Die Funktion bekommt schnelle und gründliche Tests, während der Dialog, der sie aufruft, ohne Test bleibt, solange niemand einen dorthin setzt. So entsteht, was die Kurzform Unit-Test grün, Integration kaputt meint.
- Ob ein Test den Fehler bemerken würde, zeigt erst der Lauf gegen den alten Stand: Gegen die alte Prüfung im Dialog wurde einer von drei Tests an der Aufrufstelle rot und keiner der zwölf Tests der Funktion. Dieses Ergebnis lässt sich beurteilen, ohne den Code lesen zu können, und in diesem Fall lag es vor, bevor im Dialog wieder etwas kaputtging.
- Das Projekt prüft seitdem eigens, ob ein Baustein richtig eingebaut ist: Sechs spätere Test-Suiten berufen sich auf den Fall. Wo ein Komponenten-Test zu teuer wäre, liest ein Test stattdessen den Quelltext, oder die Typprüfung sichert die Verbindung. Was bewusst offen bleibt, steht mit Begründung in einer Liste.
FAQ
Weil ein Unit-Test die Funktion selbst aufruft. Ob die Stelle im Programm, die diese Funktion benutzen soll, das auch tut, liegt außerhalb seines Blickfelds. Sitzt der Fehler dort, bleibt der Test grün, und er bleibt es auch dann, wenn der Fehler nach einer späteren Änderung zurückkehrt.
Nein. Die Testabdeckung, englisch Code Coverage, misst, welche Zeilen oder Verzweigungen während der Tests ausgeführt wurden, und nicht, ob ihr Ergebnis geprüft wurde. Ein nach Dateien aufgeschlüsselter Abdeckungsbericht kann zeigen, dass eine Komponente von keinem Test berührt wird, und das ist ein nützlicher Hinweis. Sobald aber ein Test die Komponente aufbaut und bedient, gelten die dabei durchlaufenen Zeilen als abgedeckt, auch wenn kein Test prüft, ob der entscheidende Aufruf stattfindet.
Mit einem Test, der nicht die Funktion aufruft, sondern die Stelle bedient, die sie benutzen soll. Ein Komponenten-Test baut dafür ein Stück der Oberfläche in einer nachgebildeten Browser-Umgebung auf, bedient es wie ein Nutzer und beobachtet, ob daraufhin der erwartete Aufruf folgt. Der Server ist dabei durch einen Mock ersetzt, der jeden Aufruf aufzeichnet. Ein solcher Test ist langsamer als ein Unit-Test und braucht Ersatz für alles, was in der Testumgebung fehlt.
Nein. Ein Komponenten-Test lohnt sich dort, wo schon einmal ein Fehler saß oder wo eine ausgelagerte Funktion darüber bestimmt, ob ein Aufruf an den Server stattfindet. Für sehr große Komponenten kann ein Test genügen, der den Quelltext der Aufrufer liest, und manche Verbindung sichert bereits die Typprüfung. Was bewusst ohne Test bleibt, gehört mit Begründung aufgeschrieben, damit es von einer vergessenen Stelle zu unterscheiden ist.
Verwandte Artikel
Übergeordnet:
- Der grüne Test, der nichts beweist — der Überblick der drei Wege, auf denen ein grüner Test am Fehler vorbeiführt, mit der Gegenprobe gegen den alten Stand als Methode.
- Manuelle Testfälle schreiben — der Hub dieses Astes: Aufbau, Vorlage und vier Regeln für einen Katalog manueller Testfälle.
- KI-gestützte SQL-Entwicklung mit Claude Code — der Hub des KI-Coding-Clusters: Rules, Skills und Agenten im Überblick.
Geschwister:
- Die erste Ausführung testet den Testfall — derselbe Tag von der manuellen Seite: der Testfall zu diesem Fehler, der nie gelaufen war, und was sein erster Lauf fand.
Kontrolle und Konventionen:
- Die Kontroll-Schleife — wie der Prüfdurchgang und die Gegenprobe gegen den alten Stand Teil einer wiederkehrenden Kontrolle wurden, wenn man den Code nicht lesen kann.
- Warum sqlfluff unsere SQL-Konventionen nicht prüfen kann — dieselbe Trennung in der Datenbank: ein Prüfskript für die einzelne Datei und ein Lauf gegen eine Wegwerf-Datenbank für das Zusammenspiel.