Ein einziger nicht konvertierbarer Wert — ein 25.5 in einer Integer-Spalte, ein leerer String, ein Datum wie 20240230 — und der ETL-Lauf bricht mitten im Import ab. Wer Textdaten aus Vorsystemen lädt, kennt das: Die Lieferung hält sich nicht an die vereinbarte Schnittstelle, und ein nacktes CONVERT wirft eine Exception, statt den fehlerhaften Wert sauber zu protokollieren.
Dieser Artikel beschreibt ein Design Pattern für die sichere Typ-Konvertierung: eine Systematik, die jeden Konvertierungsfehler einzeln identifizierbar macht, ohne den ETL-Prozess abzubrechen. Sie ruht auf drei Paradigmen, die der nächste Abschnitt herleitet.
Das lernst du hier:
- Materialisierung — warum die Zwischenergebnisse persistiert gehören, damit das Ergebnis jederzeit einsehbar bleibt: nach einem Abbruch wie nach erfolgreicher Verarbeitung.
- Fehler-Identifikation — wie eine einzige
WHERE-Klausel fehlgeschlagene Konvertierungen findet, ohne dass der Lauf abbricht. - Datentyp-Feinheiten — warum
TRY_CONVERT(int, N'')eine0liefert und wann das fachlich falsch ist. - Konvertierung ist nicht Validierung — warum ein technisch konvertierter Wert trotzdem fachlich falsch sein kann.
- Wiederverwendbare UDFs —
fn_try_convert_*mit Leerstring-→-NULL-Handling als Baustein pro Zieltyp.
Voraussetzung: SQL Server / T-SQL und ein ETL-Kontext, in dem Textdaten in typisierte Spalten zu überführen sind. Für die reinen Konvertierungs-Funktionen CAST, CONVERT, TRY_CAST und TRY_CONVERT siehe die Grundlagen der Typ-Konvertierung mit T-SQL — dieser Artikel baut darauf das Pattern auf.
Das Pattern in Kurzform: Der Rohwert bleibt als Text in einer _E1-Spalte erhalten, daneben speichert eine typisierte Spalte das Ergebnis der fehlertoleranten Konvertierung — TRY_CONVERT bzw. eine fn_try_convert_*-Funktion, die auch Leerstrings auf NULL abbildet. Die WHERE-Klausel [Integer_E1] IS NOT NULL AND [Integer] IS NULL findet anschließend die fehlgeschlagenen Konvertierungen, ohne dass der Lauf abbricht. Die folgenden Abschnitte liefern die Herleitung, die Datentyp-Feinheiten, die UDFs und die Grenzen des Musters.
Inhalt
- Die drei Paradigmen
- Eingangs- und Ausgangswerte
- Materialisierung der extrahierten Daten
- Identifikation von Konvertierungs-Fehlern
- Konvertierung in Abhängigkeit vom Ziel-Datentyp
- Konvertierung ist nicht Validierung
- Wiederverwendbare Konvertierungs-Funktionen
- Kritische Würdigung der Systematik
- FAQ
- Verwandte Artikel
Die drei Paradigmen
Die Systematik ruht auf drei Paradigmen:
NULLstatt Abbruch. Die Konvertierungsfunktion gibtNULLzurück, wenn der Eingangswert nicht in den Zieldatentyp konvertiert werden kann — kein Laufzeitfehler, kein ETL-Abbruch.- Eingangs- und Ausgangswert materialisieren. Der ETL-Prozess speichert in einer Tabelle sowohl den Eingangswert (Text) als auch den konvertierten Ausgangswert.
- Fehler durch Vergleich identifizieren. Der Vergleich von Eingangs- und Ausgangswert findet fehlgeschlagene Konvertierungen per einfacher
WHERE-Klausel — vorausgesetzt,NULLim Ausgangswert steht eindeutig für „nicht konvertierbar“.
SQL Server liefert mit TRY_CONVERT das erste Paradigma frei Haus: Schlägt eine grundsätzlich zulässige Konvertierung fehl, gibt die Funktion NULL zurück, statt eine Exception zu werfen. Nur explizit unzulässige Konvertierungspfade werfen weiterhin einen Fehler (siehe FAQ). Allein ihre Anwendung sichert aber noch keine fachlich korrekte Konvertierung — dafür muss man die Besonderheiten je Zieldatentyp kennen (siehe unten). Bei einigen Datentypen lässt sich TRY_CONVERT zudem gar nicht sinnvoll anwenden: Eine Ja/Nein-Information kommt etwa als Text (J, N, Y, Yes, No, …), und auch Datumswerte brauchen oft Vorverarbeitung. Für diese Fälle schreibt man benutzerdefinierte Funktionen, die das erste Paradigma (NULL bei Fehler) erfüllen. Der Abschnitt Wiederverwendbare Konvertierungs-Funktionen zeigt sie.
Das Pattern ist damit bewusst zweistufig: TRY_CONVERT liefert die technische Fehlertoleranz, die fn_try_convert_*-Funktionen ergänzen die Pattern-Konvention — sie normalisieren die Eingabe und machen NULL zum eindeutigen Fehlersignal.
Eine robuste und sichere Typ-Konvertierung ist insbesondere in Datenmigrationsprojekten wichtig, bei denen die zu verarbeitenden Daten in Form von Dateien (Excel, CSV, XML, JSON, …) geliefert werden.
Eingangs- und Ausgangswerte
Als Eingangswerte werden Daten bezeichnet, die extrahiert und in einer Datenbank in Tabellen und Spalten mit dem Datentyp nvarchar gespeichert wurden. Als Ausgangswerte werden Daten bezeichnet, die aus den Eingangswerten in den Zieldatentypen konvertiert wurden. Zu jedem zu verarbeitenden Eingangswert gibt es auch einen Ausgangswert.
Materialisierung der extrahierten Daten
Eine reine In-Memory-Verarbeitung verleitet dazu, Zwischenergebnisse gar nicht erst zu persistieren: Extraktion, Typ-Konvertierung und Fehler-Identifikation laufen dann in einem einzigen Verarbeitungsfluss im Arbeitsspeicher (SSIS mit seinem Data Flow ist ein bekanntes Beispiel). Können Werte nicht konvertiert werden, ist eine umfangreiche Fehlerbehandlung mitten im Fluss nötig. Enthält ein Datensatz mehrere Fehler, wird in vielen Projekten nur der erste behandelt und protokolliert. Fehlerhafte Datensätze landen allenfalls in einer Textdatei, die in der Praxis selten systematisch ausgewertet wird. So mächtig solche Werkzeuge sind: In der Projektpraxis, aus der dieser Artikel stammt, wurde eine umfassende Fehlerbehandlung bei der Typ-Konvertierung selten konsequent umgesetzt.
Besser ist es, die Arbeitsschritte strikt voneinander zu trennen und die Zwischenergebnisse in einer Datenbank zu materialisieren, unabhängig davon, welches Werkzeug die Verarbeitung übernimmt. Der entscheidende Gewinn ist die Persistierung selbst: Das Konvertierungsergebnis bleibt einsehbar, solange die T1-Bestände nicht überschrieben oder aufgeräumt werden — nicht nur nach einem Abbruch, sondern auch nach einer erfolgreichen Verarbeitung. Man kann hineinschauen, einzelne Fehler nachvollziehen und Ursachen analysieren. ETL steht für Extract, Transform, Load — wo die Zwischenergebnisse der drei Schritte leben, gibt das Akronym nicht vor. Dieses Pattern entscheidet sich bewusst für Datenbank-Tabellen: Die Daten werden zunächst in eine Datenbank extrahiert, anschließend fehlertolerant in die Zieldatentypen konvertiert, und im letzten Schritt werden fehlerfreie Daten identifiziert und weiterverarbeitet:
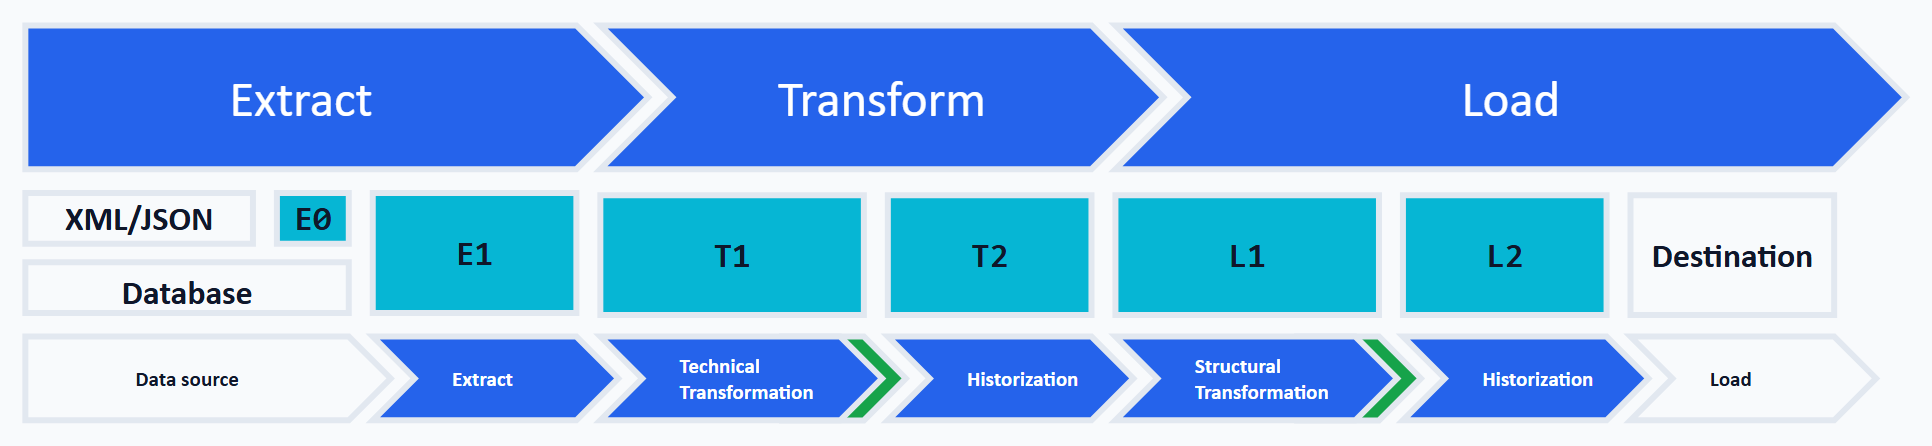
Diese Abbildung zeigt einen ETL-Prozess, in dem für jede durchzuführende Aufgabe ein separates Datenbankschema erzeugt wird:
| Schema | Bedeutung |
|---|---|
| E0 | Speicherung von XML- und JSON-Dateien in der Datenbank |
| E1 | Extraktion der Werte aus den Textdateien |
| T1 | Typ-Konvertierung der extrahierten Werte |
| T2 | Historisierung von fehlerfrei konvertierten Datensätzen |
| L1 | Strukturelle Transformation in Richtung Zielsystem |
| L2 | Speicherung fehlerfreier und strukturell transformierter Daten |
Die vollständige Herleitung dieser Schema-Schichtung — von der Extraktion (E0/E1) über die Transformation bis zum Laden (L1/L2) — liefert der Artikel Design Pattern // Architektur eines ETL-Prozesses. Dieser Artikel hier vertieft den Schritt der Typ-Konvertierung von Schema E1 nach T1. Die beiden folgenden Abschnitte stellen diese zwei Schemas vor.
Schema E1
Extrahierte Daten werden in Tabellen des Schemas E1 in Spalten mit dem Datentyp nvarchar gespeichert. Gegebenenfalls ist die Länge der Textfelder nicht zu beschränken. Sie ist jedenfalls so zu wählen, dass eine vollständige Extraktion aller Daten sichergestellt ist. Die Speicherung als Text entkoppelt die Typ-Konvertierung von der Extraktion: Konvertierungsfehler können in diesem Schritt nicht mehr auftreten. Fehler beim Lesen und Parsen der Quelldaten selbst — ungültiges XML, Encoding-Probleme, fehlende Spalten — bleiben davon unberührt. Die extrahierten Daten werden auch als Eingangswerte bezeichnet.
Schema T1
Zu jeder Tabelle aus dem Schema E1 existiert eine gleichnamige Tabelle im Schema T1. In den Tabellen des Schemas T1 werden die Spalten der Eingangswerte im Datentyp nvarchar übernommen und zusätzlich eine zweite Spalte je Eingangswert eingefügt, dieses Mal aber mit dem Datentyp des Zielsystems. Aus pragmatischen Gründen erhalten diese Spaltenpaare den gleichen Spaltennamen, wobei die Spalten, die den Eingangswert aufnehmen, das Suffix _E1 erhalten. Ein Beispiel zeigt die Struktur:
  1: CREATE TABLE [T1].[Table]
  2: (
  3:     [Id]         int IDENTITY(1,1) NOT NULL
  4:    ,[PK_E1]      nvarchar(256)         NULL
  5:    ,[PK]         int                   NULL
  6:    ,[Text_E1]    nvarchar(256)         NULL
  7:    ,[Text]       nvarchar(3)           NULL
  8:    ,[Integer_E1] nvarchar(256)         NULL
  9:    ,[Integer]    int                   NULL
 10:    ,[Date_E1]    nvarchar(256)         NULL
 11:    ,[Date]       datetime              NULL
 12: );
In der Tabelle [T1].[Table] sind alle Spalten bis auf die Spalte [Id] als Nullable deklariert. Damit können sowohl die Eingangswerte aus einer Tabelle [E1].[Table] als auch die konvertierten Ausgangswerte gespeichert werden — auch dann, wenn einzelne Konvertierungen fehlschlagen. Voraussetzung ist jedoch, dass alle Konvertierungsfunktionen im Fehlerfall ein NULL zurückgeben.
Identifikation von Konvertierungs-Fehlern
Ein Datenbeispiel für die oben deklarierte Tabelle [T1].[Table] zeigt, wie fehlgeschlagene Konvertierungen in den Spaltenpaaren aussehen:
| Id | PK_E1 | PK | Text_E1 | Text | Integer_E1 | Integer | Date_E1 | Date |
|---|---|---|---|---|---|---|---|---|
| 1 | 1023 | 1023 | S01 | S01 | 25.5 | NULL | 20240218 | 18.02.2024 |
| 2 | 1024 | 1024 | S022 | S02 | 87 | 87 | 20240230 | NULL |
| 3 | 1025X | NULL | S03 | S03 | 65 | 65 | 20240219 | 19.02.2024 |
Konvertierungsfehler lassen sich über eine einfache WHERE-Klausel finden. Für Ausgangswerte vom allgemeinen Datentyp Nicht-Text finden die folgenden WHERE-Klauseln die Probleme bei der Typ-Konvertierung — der Eingangswert ist gefüllt, der konvertierte Ausgangswert aber NULL:
  1: WHERE [PK_E1]      IS NOT NULL AND [PK]      IS NULL
  2: WHERE [Integer_E1] IS NOT NULL AND [Integer] IS NULL
  3: WHERE [Date_E1]    IS NOT NULL AND [Date]    IS NULL
Die Klauseln setzen die Pattern-Konvention voraus: NULL im Ausgangswert entsteht nur durch eine leere oder nicht konvertierbare Eingabe — genau das stellen die fn_try_convert_*-Funktionen unten sicher, denn ein rohes TRY_CONVERT würde etwa den Leerstring als 0 durchlassen.
Für Ausgangswerte vom allgemeinen Datentyp Text macht Ungleichheit die meisten zu langen (abgeschnittenen) Werte sichtbar:
1: WHERE [Text_E1] <> [Text]
Eine Feinheit hat dieser Vergleich: SQL Server füllt beim String-Vergleich den kürzeren Wert mit Leerzeichen auf. Ein nur um nachgestellte Leerzeichen gekürzter Text gilt damit als gleich — N'S02 ' <> N'S02' liefert kein Ungleich (nachgemessen auf SQL Server 2022). Wer auch diese Trunkierung finden will, vergleicht zusätzlich die gespeicherte Länge:
1: WHERE DATALENGTH([Text_E1]) <> DATALENGTH([Text])
Beide Prüfungen setzen Ziel-Spalten mit variabler Länge voraus (varchar/nvarchar). Eine char-/nchar-Zielspalte polstert jeden Wert auf die feste Länge auf. Der DATALENGTH-Vergleich wäre dort dauerhaft ungleich. Und weil DATALENGTH Byte zählt, nicht Zeichen, trägt der Längen-Vergleich nur, wenn Eingangs- und Ausgangs-Spalte dieselbe Zeichenkodierung verwenden. Im Pattern dieser Serie sind beide nvarchar, dort ist das gegeben.
Warum beide Werte persistiert werden — und was die Alternative kostet: Das Pattern speichert bewusst sowohl den Eingangswert (_E1, Text) als auch den konvertierten Ausgangswert nebeneinander. Rein theoretisch könnte man auf die Ausgangs-Spalte verzichten und nur die Eingangswerte halten. Die Prüfroutinen werden dann aber komplexer. Entscheidend ist, wo die Konvertierung stattfindet:
- Konvertierung materialisiert (dieser Ansatz): Das Konvertierungsergebnis wird in die Ausgangs-Spalte geschrieben. Die Prüfung ist danach ein einfacher Spaltenvergleich auf dem Eingangs-/Ausgangs-Paar — und man sieht direkt in der Zeile, in welcher konkreten Spalte der Fehler steckt (im Beispiel oben: Zeile 1 bei
Integer, Zeile 2 beiDate, Zeile 3 beiPK). - Konvertierung nur in der Prüfung: Die Prüfroutine wendet die eigentliche Konvertierungs- bzw. Validierungslogik zur Laufzeit direkt auf die Eingangswerte an und protokolliert oder zählt die Fehler. Das funktioniert, aber der Tabelle sieht man nicht mehr an, wo der Fehler liegt: Man erfährt, wie viele Fehler ein Datensatz enthält, aber nicht durch bloßes Ansehen der Zeile, in welcher Spalte. Genau diese fehlende Sichtbarkeit hat in der Praxis schon für Irritationen gesorgt. Diesen regelbasierten Weg — Prüfregeln generisch über dynamisches SQL anwenden — beschreibt der Artikel Datenqualität mit SQL prüfen ausführlich.
Konvertierung in Abhängigkeit vom Ziel-Datentyp
SQL Server stellt Funktionen für die Konvertierung von Daten in einen Zieldatentyp zur Verfügung. Wendet man sie an, ohne genau zu untersuchen, wie sie arbeiten, erlebt man Überraschungen. Bei genauerer Betrachtung zeigt sich etwa, dass das Ergebnis der Konvertierung einer leeren Zeichenfolge die Zahl 0 ist:
  1: SELECT TRY_CONVERT(int, N'')   -- 0
  2: SELECT TRY_CONVERT(int, N' ')  -- 0
Das kann fachlich korrekt sein. Aus Sicht des Datenbankentwicklers wird jedoch kein Wert geliefert — der Wert ist unbekannt, und demzufolge wäre NULL das korrekte Ergebnis der Konvertierung. Von solchen Feinheiten gibt es einige, und eine sichere Typ-Konvertierung muss sie berücksichtigen.
Die Deep-Dive-Artikel dieser Serie leiten je Datentyp her, wie sich ein Eingangswert sicher und fachlich korrekt in den Datentyp des Ausgangswertes konvertieren lässt. Die Auswahl folgt dem ETL-Kontext: Es sind die Zieltypen, die typischerweise aus Textquellen befüllt werden. Eine vollständige Referenz aller SQL-Server-Datentypen ist nicht das Ziel:
| Datentyp | Wertebereich | Byte |
|---|---|---|
| char | Zeichenfolge mit fester Länge. n = Länge in Byte: klassisch 1 Byte pro Zeichen, mit UTF-8-Collation (ab SQL Server 2019) belegt ein Zeichen 1-4 Byte | n |
| nchar | Zeichenfolge mit fester Länge, UTF-16 mit 2 Byte pro Codeeinheit. n zählt Codeeinheiten, nicht Zeichen | 2 * n |
| varchar | Zeichenfolge mit variabler Länge. n = maximale Länge in Byte: klassisch 1 Byte pro Zeichen, mit UTF-8-Collation 1-4 Byte | variabel |
| nvarchar | Zeichenfolge mit variabler Länge, UTF-16 mit 2 Byte pro Codeeinheit — Ergänzungszeichen belegen zwei Codeeinheiten, n zählt Codeeinheiten, nicht Zeichen | variabel |
| bigint | -9.223.372.036.854.775.808 bis 9.223.372.036.854.775.807 | 8 |
| int | -2.147.483.648 bis 2.147.483.647 | 4 |
| smallint | -32.768 bis 32.767 | 2 |
| tinyint | 0 bis 255 | 1 |
| numeric [(p [, s])] / decimal [(p [, s])] | p = Gesamtzahl der Stellen (Präzision, maximal 38), s = Anzahl der Nachkommastellen. Wertebereich abhängig von p und s, maximal -10^38 + 1 bis 10^38 – 1. Funktional sind beide Datentypen identisch. | 5-17 |
| money / smallmoney | Aus Gründen der Genauigkeit und des besonderen Verhaltens von money-Werten bei Berechnungen wird empfohlen, ersatzweise den Datentyp decimal zu verwenden. | 8 / 4 |
| float(n) | n = Anzahl der Bits, die zum Speichern der Mantisse verwendet werden (1-53) | 4 oder 8 |
| real | Synonym für float(24) | 4 |
| bit | 0 oder 1 | 1 je bis zu 8 bit-Spalten (gepackt) |
| date | Wertebereich = 01.01.0001 bis 31.12.9999 (ohne Uhrzeit) | 3 |
| datetime | Wertebereich = 01.01.1753 bis 31.12.9999 mit Uhrzeit. Sekundenbruchteile gerundet auf ,000/,003/,007 (rund 3,33 ms) | 8 |
| datetime2(n) | Wertebereich = 01.01.0001 bis 31.12.9999 mit Uhrzeit. n = Anzahl der Nachkommastellen der Sekunden (0-7) | 6-8 |
| time(n) | Wertebereich = 00:00:00.0000000 bis 23:59:59.9999999. n = Anzahl der Nachkommastellen der Sekunden (0-7) | 5 |
Die Artikel je Datentyp sind am Ende dieses Artikels unter Verwandte Artikel verlinkt.
Konvertierung ist nicht Validierung
TRY_CONVERT beantwortet genau eine Frage: Kann SQL Server diesen Text technisch in den Zieldatentyp überführen? Ob der Wert fachlich zulässig ist, beantwortet die Funktion nicht. Nach der Konvertierung steht jeder Wert deshalb in einem von drei Zuständen:
- Technisch konvertierbar und fachlich gültig. Der Normalfall, der Wert wandert weiter.
- Technisch nicht konvertierbar. Der Ausgangswert ist
NULL. Genau diese Fälle findet dieWHERE-Klausel aus dem Abschnitt Identifikation von Konvertierungs-Fehlern. - Technisch konvertierbar, aber fachlich ungültig. Die Konvertierung liefert einen Wert, und trotzdem verstößt er gegen eine fachliche Regel. Ein Beispiel zeigt der Abschnitt zu den Fließkomma-Funktionen unten:
1.234konvertiert anstandslos zu1.234— gemeint sein kann in einer deutschen Quelle aber die Tausendergruppierung1234.
Das Spaltenpaar-Pattern dieses Artikels deckt den zweiten Zustand ab. Der dritte braucht eigene Validierungsregeln wie Wertebereiche, Muster oder Plausibilitäten — dafür ist das regelbasierte Framework aus Datenqualität mit SQL prüfen der passende Ort.
Eine zweite Grenze zieht die NULL-Semantik: Die fn_try_convert_*-Funktionen bilden bewusst auch Leerstrings auf NULL ab. Ein leer gelieferter Eingangswert ('') fällt damit in dieselbe WHERE-Klausel wie ein nicht konvertierbarer. Beide erscheinen als Fehler. Das ist in diesem Pattern gewollt: Ein leerer Text ist kein Wert. NULL dient hier bewusst als Sammelsignal für „fehlt“ und „unlesbar“ — das vereinfacht die Prüfung, unterscheidet die beiden Ursachen aber nicht. Wer die Unterscheidung braucht, ergänzt eine eigene Regel auf dem Eingangswert oder erweitert das Pattern um eine explizite Status-Spalte je Wertepaar (etwa ok / leer / nicht konvertierbar). Die Status-Spalte macht die Ursache direkt abfragbar, kostet aber eine dritte Spalte pro Eingangswert und gehört dann konsequent in jede T1-Tabelle.
Wiederverwendbare Konvertierungs-Funktionen
Das erste Paradigma wiederholt sich pro Zieltyp: NULL statt Exception bei einem nicht konvertierbaren Wert. Statt es in jedem SELECT auszuformulieren, kapselt man es in eine benutzerdefinierte Funktion fn_try_convert_<typ>. Sie übernimmt zwei Aufgaben, die TRY_CONVERT allein nicht erledigt: Leerstrings und Eingaben, die nur aus Leerzeichen bestehen, auf NULL abbilden (statt der 0-Falle von oben) und — bei Fließkommazahlen — die deutsche Dezimalschreibweise normalisieren. Andere Whitespace-Zeichen entfernen LTRIM/RTRIM nicht. Für das Versprechen der Funktion ist das unschädlich: Eingaben, die nur aus Tab, Zeilenumbruch oder geschütztem Leerzeichen bestehen, liefern bei allen numerischen Zieltypen dieses Patterns NULL (nachgemessen auf SQL Server 2022 für int, bigint, smallint, decimal und float). Im Detail parst SQL Server allerdings typabhängig: float toleriert etwa einen führenden Tab vor der Zahl, int und decimal nicht.
Für die ganzzahligen Typen sieht der Integer-Vertreter so aus (die Schwestern fn_try_convert_bigint, fn_try_convert_smallint und fn_try_convert_tinyint unterscheiden sich nur im Ziel-Typ):
  1: CREATE FUNCTION [dbo].[fn_try_convert_int] (@p_input AS nvarchar(max))
  2: RETURNS int
  3: AS
  4: BEGIN
  5:    DECLARE @normalized AS nvarchar(max);
  6:
  7:    SET @normalized = LTRIM(RTRIM(@p_input));
  8:
  9:    -- Leerstring/nur Leerzeichen ist ein unbekannter Wert, keine 0
 10:    IF @normalized = N'' RETURN NULL;
 11:
 12:    RETURN TRY_CONVERT(int, @normalized);
 13: END;
Der Parameter ist bewusst als nvarchar(max) deklariert. Eine engere Länge wäre eine stille zweite Trunkierungsgrenze: SQL Server schneidet einen zu langen Wert bei der Parameter-Übergabe kommentarlos ab, und aus einem ungültigen langen Eingangswert kann so ein scheinbar gültiger kurzer werden. Der Effekt lässt sich direkt nachstellen (SQL Server 2022):
  1: DECLARE @input AS nvarchar(300) = N'25' + REPLICATE(N' ', 254) + N'X';
  2:
  3: SELECT [dbo].[fn_try_convert_int](@input);  -- NULL: das 'X' macht den Wert ungueltig
  4: -- Mit @p_input nvarchar(256) lieferte derselbe Aufruf faelschlich 25 —
  5: -- der Parameter schneidet das 'X' an Position 257 ab, uebrig bleibt '25' plus Leerzeichen.
Wer die Parameter-Länge doch begrenzen will, setzt sie mindestens auf die Länge der E1-Spalten.
Für die Fließkomma-Typen kommt die Komma-zu-Punkt-Normalisierung hinzu, damit eine deutsche Notation wie 25,5 korrekt konvertiert (fn_try_convert_real ist identisch bis auf den Ziel-Typ):
  1: CREATE FUNCTION [dbo].[fn_try_convert_float] (@p_input AS nvarchar(max))
  2: RETURNS float
  3: AS
  4: BEGIN
  5:    DECLARE @normalized AS nvarchar(max);
  6:
  7:    -- deutsche Dezimal-Notation: Komma zu Punkt
  8:    SET @normalized = REPLACE(LTRIM(RTRIM(@p_input)), N',', N'.');
  9:
 10:    IF @normalized = N'' RETURN NULL;
 11:
 12:    RETURN TRY_CONVERT(float, @normalized);
 13: END;
Die Komma-Ersetzung setzt eine Eingabegrammatik voraus: deutsche Dezimal-Notation ohne Tausendertrennzeichen. Ein Wert wie 1.234,56 wird nach der Ersetzung zu 1.234.56 und fällt damit als NULL auf. Tückischer ist 1.234: Der Wert konvertiert anstandslos als Punkt-Notation zu 1.234, obwohl die Quelle womöglich die Tausendergruppierung 1234 meinte (nachgemessen auf SQL Server 2022). Das ist der dritte Zustand aus Konvertierung ist nicht Validierung — abfangen kann ihn nur eine Formatregel auf dem Eingangswert.
Mit diesen Funktionen wird aus der Konvertierung im Schema T1 ein einfacher, abbruchsicherer Ausdruck: [dbo].[fn_try_convert_int]([Integer_E1]) liefert für die nvarchar-Zahl-Pfade dieses Patterns den typisierten Wert oder NULL — selbst ein Überlauf wie 99999999999999 wird zu NULL. Der einzige Sonderfall sind explizit unzulässige Konvertierungspfade (siehe FAQ).
Die datentyp-spezifischen Feinheiten (Wertebereiche, Rundung bei decimal, J/N-Mapping bei bit, Datumsformate) leiten die verlinkten Artikel dieser Serie je Typ her.
Bei großen Datenmengen gehört die Ausführung solcher Skalar-Funktionen auf den Prüfstand, denn klassisch ruft SQL Server sie pro Zeile auf. Seit SQL Server 2019 kann der Optimizer geeignete Skalar-UDFs automatisch inlinen. Die hier gezeigte Form ist davon ausgenommen, weil sie zwei RETURN-Anweisungen enthält — inlinefähige Skalar-UDFs dürfen seit SQL Server 2019 CU5 nur eine einzige RETURN-Anweisung haben, IF/ELSE selbst ist kein Hindernis (sys.sql_modules.is_inlineable meldet für die gezeigte Form 0, nachgemessen auf SQL Server 2022). Wer die Funktionen auf Millionen Zeilen anwendet, formuliert den Rumpf als einzelnes RETURN CASE WHEN … THEN NULL ELSE TRY_CONVERT(…) END — diese Variante verhält sich identisch und meldet is_inlineable = 1. Auch dann gilt: is_inlineable = 1 beschreibt nur die Eignung der Funktion. Ob eine konkrete Abfrage sie tatsächlich inlined, entscheidet der Optimizer im Einzelfall.
Kritische Würdigung der Systematik
Dieser Artikel hat die grundlegende Systematik einer sicheren Typ-Konvertierung aufgezeigt. Ihre Implementierung in einem ETL-Prozess erscheint auf den ersten Blick aufwändig: SELECT-Statements, die Daten aus den Tabellen des Schemas E1 lesen und typisiert in den Tabellen des Schemas T1 speichern, können bei Tabellen mit vielen Spalten komplex werden.
Es bietet sich daher an, diese Aufgabe einmalig über eine generische, metadaten-getriebene Prozedur zu lösen: eine Prozedur, die aus den Tabellenstrukturen des Schemas T1 dynamisch das Konvertierungs-SELECT erzeugt, reduziert den Entwicklungsaufwand pro Tabelle im Wesentlichen auf eine Zeile Code. Genau dieses Muster — die konfigurierbare Erkennung fehlerhafter Daten über dynamisches SQL — beschreibt der Artikel Datenqualität mit SQL prüfen.
Damit ordnet sich dieser Artikel klar ein: Er ist die praktische Regelrichtlinie für die Konvertierungs-Fehlerprüfung. Den architektonischen Rahmen — die Schema-Schichtung E0–L2 — liefert die Architektur eines ETL-Prozesses. Die Verallgemeinerung auf beliebige Datenqualitäts-Regeln übernimmt das eben genannte Framework. Dieser Artikel deckt das Stück dazwischen ab: wie sich Fehler beim Schritt der Typ-Konvertierung konkret aufspüren lassen.
FAQ
TRY_CONVERT direkt im SELECT verwenden? TRY_CONVERT allein hat zwei Tücken: Ein Leerstring wird zu 0 statt NULL, und im Fehlerfall verschwindet die Information, welcher Wert nicht konvertierbar war. Das Pattern löst beides — die fn_try_convert_*-Funktion bildet Leerwerte auf NULL ab, und die E1/T1-Materialisierung behält den Originalwert neben dem Konvertierungsergebnis.
Der Grundlagen-Artikel vergleicht die Funktionen selbst — CAST, CONVERT, TRY_CAST und TRY_CONVERT. Dieser Artikel baut darauf das Design Pattern: die ETL-Systematik aus Materialisierung, Fehler-Identifikation per WHERE-Klausel und wiederverwendbaren UDFs. Die Grundlagen sind das Werkzeug, dieses Pattern die Methode.
Über eine WHERE-Klausel auf dem Spaltenpaar: Bei Nicht-Text-Typen ist die Konvertierung fehlgeschlagen, wenn der Eingangswert gefüllt, der Ausgangswert aber NULL ist ([x_E1] IS NOT NULL AND [x] IS NULL). Bei Text-Typen verrät Ungleichheit ([x_E1] <> [x]) abgeschnittene Werte — nur um nachgestellte Leerzeichen gekürzte Texte findet erst ein zusätzlicher DATALENGTH-Vergleich (siehe Identifikation von Konvertierungs-Fehlern).
TRY_CONVERT einen ETL-Prozess trotzdem abbrechen? Ja, in einem Sonderfall. NULL statt Fehler gilt nur für Konvertierungen, die SQL Server grundsätzlich zulässt. Ist ein Konvertierungspfad explizit unzulässig — etwa xml nach int —, löst auch TRY_CONVERT einen Fehler aus (Fehler 529, nachgemessen auf SQL Server 2022). Für die in diesem Artikel behandelten nvarchar-Zieltyp-Konvertierungen ist dieser Sonderfall nicht relevant. Dort liefert die Funktion den konvertierten Wert oder NULL.
Mit einer generischen, metadaten-getriebenen Prozedur, die aus den Tabellenstrukturen dynamisch das Konvertierungs-SELECT erzeugt. Das Muster ist im Artikel Datenqualität mit SQL prüfen ausgeführt. Dort läuft es als konfigurierbare Erkennung fehlerhafter Daten über dynamisches SQL.
Konzeptuell ja. Die drei Paradigmen sind engine-neutral. Postgres hat kein TRY_CONVERT, aber dieselbe Idee lässt sich mit einer PL/pgSQL-Funktion umsetzen, die den Cast in einen BEGIN … EXCEPTION-Block kapselt und dort gezielt die für den Zieltyp relevanten SQLSTATE-Fehlerklassen behandelt — bei Zahlen etwa invalid_text_representation und numeric_value_out_of_range, bei Datumswerten zusätzlich invalid_datetime_format und datetime_field_overflow. Ein pauschales WHEN OTHERS verschluckt dagegen auch echte Programmfehler. Und günstig ist der Weg nicht: Jeder EXCEPTION-Block kostet eine Subtransaktion pro Aufruf. Besonders relevant ist das bei der Datenmigration nach PostgreSQL.
Verwandte Artikel
Grundlagen:
- Datenqualität // Grundlagen der Typ-Konvertierung mit T-SQL —
CAST,CONVERT,TRY_CASTundTRY_CONVERTim Vergleich.
Sichere Konvertierung je Datentyp:
- TRY_CONVERT für bigint, int, smallint und tinyint
- TRY_CONVERT für decimal und numeric
- TRY_CONVERT für money und smallmoney
- TRY_CONVERT für float und real
- TRY_CONVERT für date, datetime, datetime2 und time
- TRY_CONVERT für bit — Ja/Nein-Werte konvertieren
Im ETL-, Datenqualitäts- und Migrations-Kontext:
- Architektur eines ETL-Prozesses — die Schema-Schichtung
E0–L2, in die dieses Pattern denE1→T1-Konvertierungsschritt einordnet. - Datenqualität in einem ETL-Prozess — der übergeordnete Blick auf Datenqualität im Prozess.
- Datenqualität mit SQL prüfen — generisches Bad-Data-Aufspüren über dynamisches SQL.
- Datenmigration: SQL Server nach PostgreSQL — der Kontext, in dem sichere Typ-Konvertierung besonders zählt.