Drei Wege, dieselbe ETL-Aufgabe in SSIS abzubilden. Einer braucht 10 Minuten und ist nachvollziehbar. Einer braucht Stunden, 40 Komponenten im Data Flow und überlebt die nächste Anforderungs-Änderung nicht. Die Frage „wie viel SQL gehört in ein SSIS-Paket?“ entscheidet über Wartbarkeit, Lesbarkeit und Entwicklungs-Tempo — nicht über Tool-Loyalität.
In diesem Artikel:
- Drei Lösungs-Ansätze für eine reale Hierarchie-/Ranking-Aufgabe auf
[DimEmployee]aus AdventureWorks (Stored Procedure, OLE DB Source, Pure-SSIS-Tasks). - Bewertung entlang fünf Dimensionen: Entwicklungs-Dauer, Lesbarkeit, Wartbarkeit, Performance, Funktionsumfang — als Fallstudie, nicht als Benchmark.
- Strategische Einordnung „ETL 2026“: wo SSIS noch passt und wo Modernisierungs-Alternativen (Azure Data Factory, dbt, Airflow, Postgres-Bordmittel, Talend Open Studio) heute besser greifen.
- Take-Away und FAQ mit den vier häufigsten SSIS-vs.-SQL-Fragen am Ende.
Voraussetzung: SQL Server 2017+ und SSIS 2017+ (Visual Studio mit SSDT), AdventureWorksDW2017 als Sample-Datenbank. Die Argumentation überträgt sich sinngemäß auf aktuelle SSIS-Versionen (2019/2022) und auf Postgres mit modernen ETL-Tools.
Hinweis zu den Screenshots: Die Bildschirmfotos zeigen noch die historische Tabellen-Nomenklatur (
[dbo].[post00210001]…) und alternative Ranking-Achsen in Lösung 3 (HireDate/BirthDatestattVacationHours/SickLeaveHours) — im Fließtext und in den Code-Beispielen ist die Nomenklatur auf sprechende Namen modernisiert.
Inhalt
- Die Vorgeschichte zu diesem Artikel
- Die drei Lösungsansätze
- Bewertung
- ETL 2026 — wie viel SQL gehört heute in ein SSIS-Paket?
- Take-Away
- FAQ
- Verwandte Artikel
Die Vorgeschichte zu diesem Artikel
SQL Server Integration Services (SSIS) ist ein äußerst mächtiges Toolset für die Entwicklung von ETL-Strecken. Es gibt viele gute Gründe, die für einen Einsatz von SSIS sprechen. Es gibt aber genauso viele, die dagegen sprechen. Beschränkt man sich auf den Microsoft-Produkt-Stack, bleibt als Alternative für die Entwicklung komplexer ETL-Strecken im Wesentlichen nur Transact-SQL (T-SQL).
Dieser Artikel gehört zu einer Serie von Artikeln, die wichtige Entscheidungskriterien für die Wahl der richtigen Technologie beleuchten: SSIS, T-SQL oder beides.
Mit Blick auf die Quellcodeverwaltung stellt der Artikel SSIS vs. Transact-SQL: Quellcodeverwaltung die Vorteile von SQL-Skripten gegenüber SSIS heraus, besonders die von SQL Server Stored Procedures. Die Änderungen in einer Stored Procedure lassen sich leicht durch Vergleich zweier Versionen in Visual Studio darstellen. Ein ähnlicher Vergleich zweier Versionen eines SSIS-Pakets zeigt selbst bei minimalen Änderungen bereits eine unübersichtliche Anzahl an Änderungen im zugrundeliegenden .dtsx-Format. Damit ist kaum noch nachvollziehbar, was sich zwischen zwei Versionen geändert hat.
Dort leitet ein T-SQL-Statement die Hierarchie-Ebenen der Mitarbeiter aus der Tabelle [AdventureWorksDW2017].[DimEmployee] ab, um anschließend auf der Basis der gefundenen Hierarchie-Ebenen 1 bis 5 ein Ranking der Urlaubs- und Krankheitsstunden zu ermitteln. Die Ermittlung sollte jeweils über die Window Functions NTILE() und DENSE_RANK() erfolgen. Die Klassifizierung der Mitarbeiter über die NTILE-Funktion sollte drei Klassen ergeben.
Die Bearbeitung der Aufgabe mit T-SQL hat nur wenige Minuten gedauert. Eine Common Table Expression (CTE) kann sich selbst referenzieren und damit Hierarchien verarbeiten, und das Ranking ließ sich schnell über die Window Functions ermitteln.
Um T-SQL-Prozeduren und -Skripte mit Blick auf die Quellcodeverwaltung gegen SSIS-Pakete stellen zu können, sollte eine funktional äquivalente SSIS-Implementierung entstehen. Die Erwartung dabei war naiv, aber naheliegend: etwas mehr Zeitaufwand als in T-SQL, insgesamt aber eine Aufgabe in vertretbarem Rahmen.
Diese Erwartung hat sich nicht bestätigt.
Für die beiden wesentlichen Anforderungen gibt es soweit ersichtlich keine einfache Lösung, geschweige denn Standard-Tasks oder Funktionen, die sich in einer Expression verwenden ließen.
- Rekursive Ermittlung der Hierarchie-Ebenen
- Ermittlung des Rankings
Ein einfacher Lösungsweg für die rekursive Ermittlung der Hierarchie-Ebenen fand sich weder in einschlägigen Blogs, noch ließ er sich auf die Schnelle selbst ableiten. Der Versuch, das Ranking gemäß der Funktion NTILE() über eine Expression zu ermitteln, wurde schnell aufgegeben. Dieser Teil der Aufgabe entstand schließlich über Skript-Tasks. Das Ergebnis ist trotz der Komplexität des Artefakts recht übersichtlich geblieben. Es ist aber eine statische Lösung und auf fünf Hierarchie-Ebenen beschränkt.
Zwischendurch blitzte immer wieder dieselbe Frage auf: Warum liegt das relevante SQL-Statement eigentlich nicht in der OLE DB Source — wie viel SQL darf’s denn sein?
In diesem Artikel werden drei Lösungsansätze mit Blick auf diese Fragestellung beschrieben und verglichen:
- Lösung 1 — Komplexes SQL in einer Stored Procedure. Ausgangspunkt ist eine Stored Procedure, die das Ergebnis eines SELECT-Statements in eine Ziel-Tabelle schreibt. Die Stored Procedure wird von einer Execute SQL Task im Control Flow eines SSIS-Pakets aufgerufen. Ein Control Flow, sonst nichts.
- Lösung 2 — Komplexes SQL in einer OLE DB Source. Das SQL-Statement kann alternativ auch in der OLE DB Source eines SSIS-Data-Flows platziert werden, gefolgt von einer OLE DB Destination, um die Daten in die Ziel-Tabelle zu schreiben. Die Lösung enthält einen Control Flow und darin einen einzigen Data Flow Task mit genau zwei Komponenten.
- Lösung 3 — Einfaches SQL in einer OLE DB Source. Die extreme Alternative ohne SQL (außer einem einfachen SELECT in der OLE DB Source) hat in der hier entwickelten Variante eine „temporäre“ Tabelle zum Zwischenspeichern des Ergebnisses, einen Control Flow, zwei Data Flow Tasks und darin zahlreiche Komponenten, die darüber hinaus mit nicht ganz einfachen Conditional Splits und Precedence Constraints verknüpft sind.
Diese drei Alternativen werden in diesem Artikel unter den folgenden Gesichtspunkten bewertet:
- Dauer der Entwicklung
- Lesbarkeit
- Wartbarkeit
- Performance
- Funktionsumfang
Die drei Lösungsansätze
Zunächst werden die drei Lösungen vorgestellt. Alle Lösungen wurden mit Microsoft Visual Studio 2017 und SQL Server 2017 entwickelt.
Lösung 1 — Komplexes SQL in einer Stored Procedure
Diese Lösung basiert auf einem komplexen SQL-Statement, das die Daten in die Zieltabelle [dbo].[fct_employee_hierarchy_ranking] schreibt. Basis des Statements ist die rekursive Verwendung einer Common Table Expression (CTE) für die Berechnung der Hierarchie-Ebenen. Dem Statement vorangestellt ist eine TRUNCATE TABLE-Anweisung, um die Zieltabelle vor dem INSERT zu leeren. Die Prozedur trägt den Namen [dbo].[sp_insert_employee_hierarchy_ranking] und wird in SSIS über eine Execute SQL Task im Control Flow aufgerufen.
  1: CREATE OR ALTER PROCEDURE [dbo].[sp_insert_employee_hierarchy_ranking]
  2: AS
  3: BEGIN
  4:    SET NOCOUNT ON;
  5:
  6:    TRUNCATE TABLE [dbo].[fct_employee_hierarchy_ranking];
  7:
  8:    WITH CTE_Employee AS
  9:    (
 10:       -- Anker der rekursiven CTE: der CEO als Top-Level-Mitarbeiter ohne
 11:       -- Vorgesetzten. [Level] = 1 markiert die Wurzel der Hierarchie.
 12:       SELECT
 13:           [EmployeeKey]
 14:          ,[FirstName]
 15:          ,[LastName]
 16:          ,[Title]
 17:          ,[ParentEmployeeKey]
 18:          ,[VacationHours]
 19:          ,[SickLeaveHours]
 20:          ,1 AS [Level]
 21:       FROM
 22:           [AdventureWorksDW2017].[dbo].[DimEmployee]
 23:       WHERE
 24:           [ParentEmployeeKey] IS NULL
 25:       AND [Status] = N'Current'
 26:
 27:       UNION ALL
 28:
 29:       -- Rekursionsschritt: alle Mitarbeiter, deren [ParentEmployeeKey] auf
 30:       -- einen bereits in der CTE enthaltenen Mitarbeiter zeigt. [Level] wird
 31:       -- pro Tiefe um 1 erhöht. T-SQL verbindet Anker und rekursives Glied
 32:       -- mit UNION ALL.
 33:       SELECT
 34:           T01.[EmployeeKey]
 35:          ,T01.[FirstName]
 36:          ,T01.[LastName]
 37:          ,T01.[Title]
 38:          ,T01.[ParentEmployeeKey]
 39:          ,T01.[VacationHours]
 40:          ,T01.[SickLeaveHours]
 41:          ,T00.[Level] + 1 AS [Level]
 42:       FROM
 43:          [AdventureWorksDW2017].[dbo].[DimEmployee] AS T01
 44:       INNER JOIN
 45:          CTE_Employee AS T00
 46:          ON
 47:            T01.[ParentEmployeeKey] = T00.[EmployeeKey]
 48:       WHERE
 49:          T01.[Status] = N'Current'
 50:    )
 51:    INSERT INTO [dbo].[fct_employee_hierarchy_ranking]
 52:    (
 53:        [ParentEmployeeKey]
 54:       ,[EmployeeKey]
 55:       ,[LastName]
 56:       ,[FirstName]
 57:       ,[Title]
 58:       ,[Level]
 59:       ,[VacationHours]
 60:       ,[SickLeaveHours]
 61:       ,[VacationHours_NTILE]
 62:       ,[VacationHours_DENSE_RANK]
 63:       ,[SickLeaveHours_NTILE]
 64:       ,[SickLeaveHours_DENSE_RANK]
 65:    )
 66:    SELECT
 67:        [ParentEmployeeKey]
 68:       ,[EmployeeKey]
 69:       ,[LastName]
 70:       ,[FirstName]
 71:       ,[Title]
 72:       ,[Level]
 73:       ,[VacationHours]
 74:       ,[SickLeaveHours]
 75:       ,NTILE(3)     OVER (PARTITION BY [Level] ORDER BY [VacationHours],  [EmployeeKey]) AS [VacationHours_NTILE]
 76:       ,DENSE_RANK() OVER (PARTITION BY [Level] ORDER BY [VacationHours])                 AS [VacationHours_DENSE_RANK]
 77:       ,NTILE(3)     OVER (PARTITION BY [Level] ORDER BY [SickLeaveHours], [EmployeeKey]) AS [SickLeaveHours_NTILE]
 78:       ,DENSE_RANK() OVER (PARTITION BY [Level] ORDER BY [SickLeaveHours])                AS [SickLeaveHours_DENSE_RANK]
 79:    FROM
 80:       CTE_Employee;
 81: END;
 82: GO
Die rekursive CTE erzeugt für jeden aktiven Mitarbeiter den [Level]-Wert. Wichtig ist, dass Anker und Rekursionsteil auf denselben Datenbestand filtern: Beide schränken auf [Status] = N'Current' ein. Würde nur der Rekursionsteil filtern, könnte ein ausgeschiedener Mitarbeiter als Wurzel der Hierarchie auftauchen, während ausgeschiedene Mitarbeiter unterhalb der Wurzel herausfallen. Das wäre eine stille Asymmetrie in den Eingangsdaten. Über das anschließende INSERT … SELECT werden die NTILE- und DENSE_RANK-Werte pro Hierarchie-Ebene berechnet — getrennt nach [VacationHours] und [SickLeaveHours]. SQL Server liefert beides als Window Function direkt aus dem Statement. Die beiden Funktionen behandeln Gleichstände dabei absichtlich unterschiedlich: DENSE_RANK() sortiert allein nach der Stundenzahl, sodass Mitarbeiter mit identischem Wert denselben Rang teilen. NTILE(3) bekommt zusätzlich [EmployeeKey] als zweites Sortierkriterium, weil die Zuordnung zu einer der drei Klassen sonst bei Gleichstand nicht reproduzierbar wäre.
Lösung 2 — Komplexes SQL in einer OLE DB Source
Die zweite Lösung basiert auf einem SSIS-Data-Flow, der nichts anderes enthält als eine OLE DB Source sowie eine OLE DB Destination.
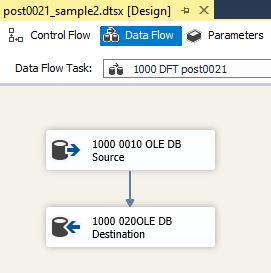
Die OLE DB Source definiert die Datenquelle als SQL-Statement — eben das oben erwähnte komplexe Statement aus der Prozedur [dbo].[sp_insert_employee_hierarchy_ranking], jedoch ohne den INSERT INTO-Part. Der Datenstrom wird durch die nachgelagerte OLE DB Destination in die Zieltabelle geschrieben.
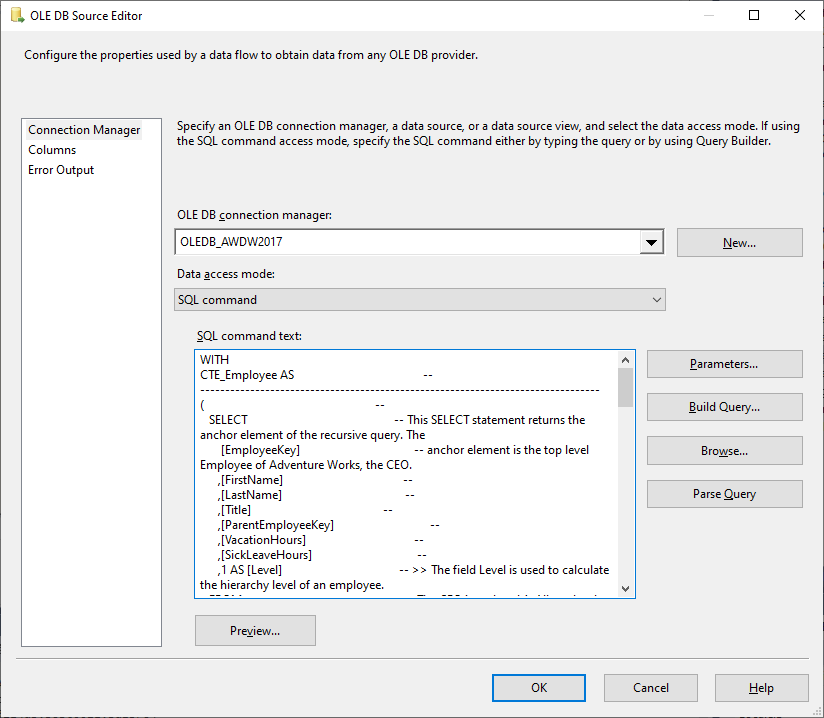
Es werden keine weiteren Transformationen in dem Data Flow durchgeführt.
Lösung 3 — Einfaches SQL in einer OLE DB Source
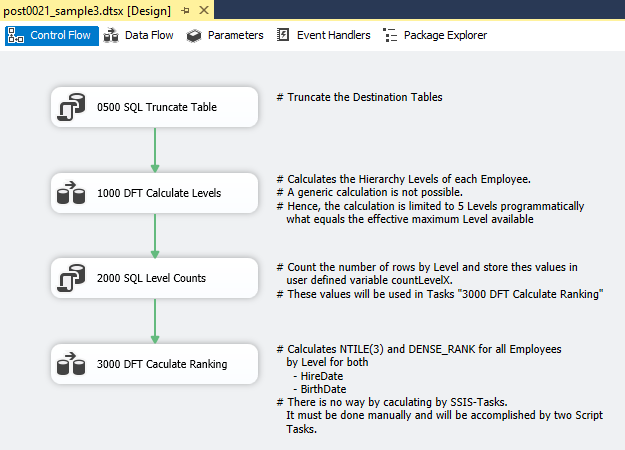
Die dritte Lösung verwendet ausschließlich SSIS-Bordmittel für die Berechnung der Hierarchie-Ebenen sowie des Rankings. Die gewählte Lösung beinhaltet einen Control Flow, zwei Data Flow Tasks und zwei Tabellen. Der Control Flow enthält zwei Execute SQL Tasks sowie die zwei Data Flow Tasks mit den folgenden Aufgaben:
- 0500 SQL Truncate Table. Diese Task löscht die beiden Tabellen, die für die Lösung benötigt werden:
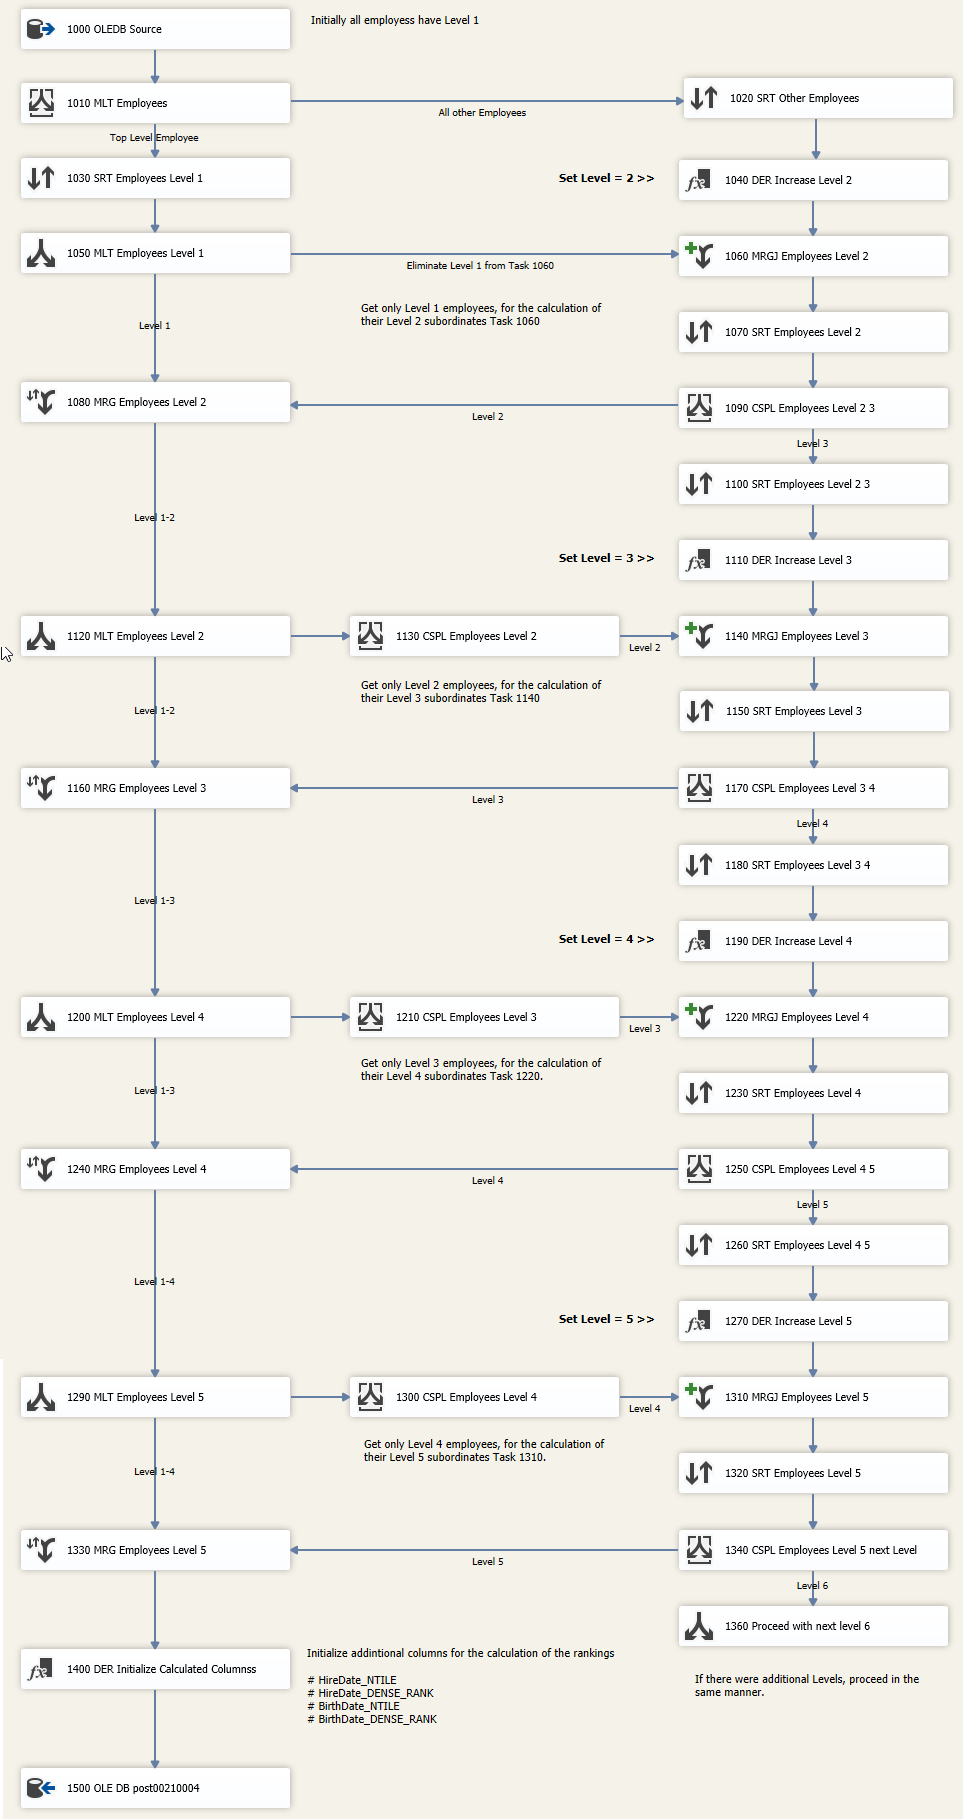
[dbo].[stg_employee_levels](Staging für die berechneten Hierarchie-Ebenen) und[dbo].[fct_employee_hierarchy_ranking](Ziel-Fakten-Tabelle). - 1000 DFT Calculate Levels. Dieser Data Flow berechnet zu jedem Mitarbeiter den Hierarchie-Level. Die Berechnung ist nicht generisch und auf die fünf vorhandenen Hierarchie-Level begrenzt.
- 2000 SQL Level Counts. Für die Berechnung des Rankings gemäß der Window Function
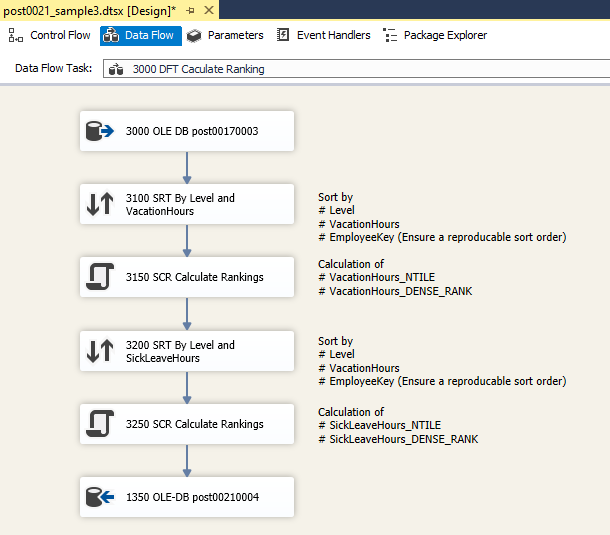
NTILE()ist es erforderlich, die Anzahl der Mitarbeiter je Hierarchie-Level zu kennen. Diese SQL Task führt fünf SELECT-Statements aus, um die Anzahl der Mitarbeiter je Level zu ermitteln und in hierfür vorgesehenen Variablen zu speichern. - 3000 DFT Calculate Ranking. Der zweite Data Flow ermittelt schließlich das Ranking mit Hilfe von Skript-Tasks und speichert das Endergebnis in der Zieltabelle
[dbo].[fct_employee_hierarchy_ranking].
Control Flow
1000 DFT Calculate Levels
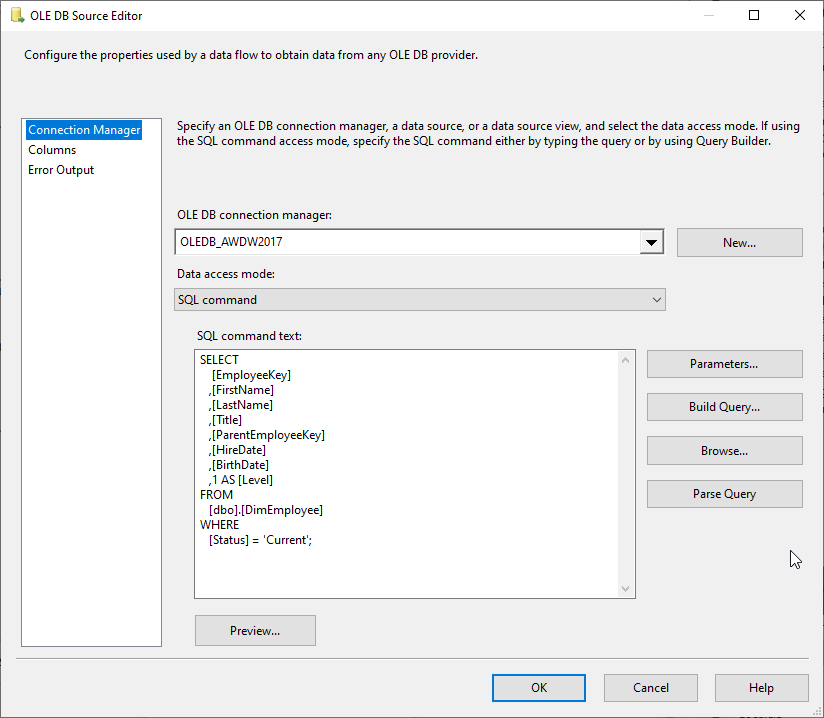
Die Datenquelle 1000 OLEDB Source enthält ein einfaches SQL-Statement ohne weitere Berechnungen.
3000 DFT Calculate Ranking
Bewertung
Eine Einordnung vorweg: Was folgt, ist ein Erfahrungs- und Design-Vergleich an genau dieser Aufgabe, kein allgemeiner Benchmark. Die Bewertungen sind an einer Hierarchie-/Ranking-Berechnung auf [DimEmployee] gewonnen und lassen sich nicht ungeprüft auf beliebige ETL-Strecken übertragen.
Dauer der Entwicklung
| Lösung 1 | Lösung 2 | Lösung 3 | Bewertung |
|---|---|---|---|
| Wenige Minuten | Wenige Minuten | Mehrere Stunden | T-SQL klar im Vorteil |
Komplexes SQL in einer Stored Procedure
Bei der Entwicklung gab es, wie oben erwähnt, zwei Herausforderungen: die Ermittlung der Hierarchie-Ebenen der Mitarbeiter und die Ermittlung des Rankings. T-SQL bietet für beide Herausforderungen Konzepte und Lösungen an, die eine einfache und schnelle Umsetzung ermöglichen. Über das Konzept der rekursiven Common Table Expression können hierarchisch organisierte Daten schnell und mit wenig Aufwand abgefragt werden. Mit den Window Functions NTILE() und DENSE_RANK() ist auch die zweite Herausforderung mit nur wenigen Zeilen umgesetzt. Das SQL-Statement ist in nur wenigen Minuten erstellt.
Komplexes SQL in einer OLE DB Source
Die zweite Lösung verwendet das komplexe SQL-Statement als Datenquelle in einer OLE DB Source. Das SSIS-Paket der zweiten Lösung enthält lediglich einen Data Flow Task mit zwei Komponenten: einer Datenquelle und einem Datenziel. Es werden keine weiteren Transformationen durchgeführt. Der wesentliche Aufwand ergibt sich aus der Erstellung des SQL-Statements. Wie im vorigen Abschnitt erläutert, ist dieses in nur wenigen Minuten erstellt. Das SSIS-Paket selbst ist mit nur minimalem Aufwand ebenfalls schnell erstellt.
Einfaches SQL in einer OLE DB Source
Diese Lösung wurde unter der Maßgabe entwickelt, dass sowohl die Berechnung der Hierarchie-Ebenen sowie des Rankings mit den Bordmitteln von SSIS umzusetzen sind. Die Datenquelle der OLE DB Source wird durch ein einfaches SELECT-Statement definiert. Alle weiteren Transformationen erfolgen über Komponenten im Data Flow. Im Unterschied zu T-SQL gibt es hier nicht die eine ideale Lösung. Tatsächlich lag der Erstellung dieser Beispiel-Lösung der Trugschluss zugrunde, die beiden Herausforderungen ließen sich in SSIS ähnlich komfortabel lösen. Nach heutigem Kenntnisstand ist das nicht möglich. Für die nicht generische Ermittlung der Hierarchie-Ebenen und die Ermittlung des Rankings wurden in den beiden Data Flow Tasks mehr als 40 Komponenten konfiguriert, die darüber hinaus mit komplexen Precedence-Constraints und Join/Split-Tasks verbunden sind. Die Entwicklung hat einige Stunden Zeit gekostet.
Fazit
In diesem Beispiel sind die Anforderungen mit T-SQL wesentlich schneller umgesetzt als mit (nur) SSIS. Während in T-SQL der Lösungsweg mehr oder weniger vorgegeben ist, musste der Lösungsweg in SSIS erst einmal entworfen werden. Der Aufwand der Entwicklung des SQL-Statements entsprach nur einem Bruchteil der Zeit, die für die SSIS Lösung aufgewendet werden musste.
Bei datenbanknahen, mengenorientierten Transformationen verkürzt mehr SQL die Entwicklungszeit spürbar, weil Rekursion, Joins und Window Functions direkt aus der Datenbank-Engine kommen. Für prozedurale Speziallogik, Datei- oder API-Zugriffe gilt das nicht.
Lesbarkeit
| Lösung 1 | Lösung 2 | Lösung 3 | Bewertung |
|---|---|---|---|
| Gut im SSMS-Editor | Schwer im „Guckloch“ der OLE DB Source | Aufwändig — 40+ Komponenten zu sichten | T-SQL klar im Vorteil |
Komplexes SQL in einer Stored Procedure
Das eigentliche SQL-INSERT-Statement der ersten Lösung erstreckt sich bei großzügiger Strukturierung gerade mal über ca. 80 Zeilen. Sofern das Statement zusätzlich halbwegs ordentlich formatiert ist, ist der gewählte Lösungsweg schnell erfassbar. Das oben abgebildete Statement der ersten Lösung ist gut lesbar.
Komplexes SQL in einer OLE DB Source
Die zweite Lösung verwendet in Teilen das SQL-Statement aus der Stored Procedure [dbo].[sp_insert_employee_hierarchy_ranking] der ersten Lösung. Während das Statement an sich gut verständlich ist, ist es innerhalb des Feldes SQL command text der OLE DB Source nur schwer lesbar. Zum einen wird für die Darstellung eine proportionale Schriftart verwendet, zum anderen ist das Feld nichts anderes als ein Guckloch. Komplexe Statements sind über diesen Dialog nur sehr schwer lesbar.
Einfaches SQL in einer OLE DB Source
In dem auf SSIS basierenden dritten Lösungsansatz wurde als Datenquelle für die Lösung ein einfaches SQL-Statement definiert. Die Komplexität liegt hier in den über 40 Komponenten der beiden Data Flow Tasks. Während ein SQL-Statement mehr oder minder von oben nach unten gelesen werden kann, sind bei der Lektüre eines komplexen SSIS-Pakets umfangreiche Aktionen erforderlich: Jede Komponente ist zu öffnen, ihre Konfiguration muss geprüft werden. Ein großer Teil der Logik ist über die Precedence Constraints und die Merge-Join-Transformationen abgebildet und muss erarbeitet werden. Die Erfassung der Logik dieser Lösung ist mit ungleich mehr Aufwand verbunden als die Erfassung des komplexen SQL-Statements.
Fazit
T-SQL-Statements sind bei strukturierter und formatierter Notation ungleich lesbarer als SSIS-Pakete, die die gleiche Aufgabe erfüllen.
Der Grad der Lesbarkeit richtet sich auch danach, wo das SQL-Statement gespeichert und in welchem „Editor“ das Statement per Default angezeigt wird. Während eine Prozedur oder ein Statement in SQL Server Management Studio gut lesbar ist, ist es das in dem Dialog der OLE DB Source nicht.
Wartbarkeit
| Lösung 1 | Lösung 2 | Lösung 3 | Bewertung |
|---|---|---|---|
| SP-Diff lesbar, versioniert | SQL versteckt im .dtsx | .dtsx-Diff stark verrauscht | T-SQL klar im Vorteil; SSIS gewinnt nur bei Provider-Wechsel |
Lesbarkeit
Sofern bei Wartbarkeit auf die Lesbarkeit abgestellt wird, geht dieser Punkt ganz klar ebenfalls an T-SQL. Jene Stellen, die zu ändern sind, aber auch solche, an denen neue Funktionen bereitgestellt werden, können in einem SQL-Skript schnell identifiziert werden.
Künftige Anforderungen
Wartbarkeit stellt prinzipiell auf künftige Änderungen ab. Hier gibt es durchaus Aspekte, die eine einfache Bewertung schwierig machen.
Faktisch ist die Anzahl der Hierarchie-Ebenen in der Dimension [AdventureWorksDW2017].[DimEmployee] auf fünf beschränkt. Eine künftige Änderung auf sechs Hierarchie-Ebenen bedeutet für die Lösung 1 (komplexes Statement) keinen zusätzlichen Aufwand. Egal wie tief die Hierarchie strukturiert ist, T-SQL kommt damit zurecht. Zu beachten ist die Rekursionsgrenze: Für Statements mit rekursiver Common Table Expression gilt standardmäßig MAXRECURSION 100. Mit OPTION (MAXRECURSION n) lässt sich das Limit bis 32.767 heraufsetzen, 0 erlaubt unbegrenzte Rekursion.
Anders sieht es bei Verwendung von vorwiegend SSIS aus. Eine Erweiterung um zusätzliche Hierarchie-Ebenen bedeutet hier einen nicht unerheblichen Mehraufwand für die Anpassung des SSIS-Pakets. Besonders hoch kann der Mehraufwand ausfallen, wenn ein komplexer SSIS-Data-Flow irgendwo in der Mitte geändert werden muss. Das kann zur Folge haben, dass jene Data Flow Tasks, die der Änderung folgen, komplett neu entwickelt werden müssen.
Auf der anderen Seite kann die Bewertung auch ganz anders ausfallen, wenn der Grund für eine künftige Änderung der Wechsel des Datenbank-Providers ist. Bei einem Wechsel des Datenbank-Management-Systems von zum Beispiel SQL Server nach Oracle ist nicht gewährleistet, dass der in SQL-Statements verwendete Sprachumfang von der künftigen Plattform unterstützt wird. Im schlechtesten Fall kann ein Statement nicht oder nur mit umfangreichem Aufwand an den Sprachumfang der neuen Umgebung angepasst werden. Eine künftige Änderung der Plattform bedeutet für die Lösung 3 – unter der Voraussetzung, dass der Datenbank-Provider von SSIS unterstützt wird – keine Notwendigkeit einer funktionalen Änderung des SSIS-Pakets.
Vergleich von zwei Versionen eines Artefaktes
Eine Voraussetzung für die Entwicklung wartbarer Artefakte ist die Versionierung der Artefakte in einer Quellcodeverwaltung. Zu jeder ausgelieferten und installierten Version einer Software oder einer ETL-Strecke muss sich der zugehörige Code im Repository identifizieren lassen. Im Fehlerfall sind Änderungen am Code zurückzuverfolgen, um Fehler identifizieren zu können. Mit welcher Version ist eine fehlerhafte Implementierung erfolgt? Was wurde von Version zu Version geändert? Der Vergleich von jeweils zwei Versionen eines Artefakts führt in der Regel schnell zu einer Antwort. Der Artikel SSIS vs. Transact-SQL: Quellcodeverwaltung arbeitet die Aspekte der Vergleichbarkeit von T-SQL-Statements und SSIS-Paketen im Detail heraus. Ein XML-Diff zweier .dtsx-Versionen ist wegen GUIDs, Layout- und Metadaten-Änderungen kaum auszuwerten. SSIS-Pakete sind unter diesem Gesichtspunkt nur sehr schwer wartbar.
Fazit
In der Praxis wandert ohnehin ein großer Teil der Transformationen als SQL-Statement in die OLE DB Source. Kaum jemand wird ein komplexes Statement, das mehrere Tabellen verjoint, stattdessen über einen SSIS-Data-Flow nachbauen wollen. Der Aufwand dafür wäre unverhältnismäßig hoch, und die Performance dürfte deutlich schlechter ausfallen. Unter dem Aspekt der Wartbarkeit stellt sich dann allerdings die Frage, warum ein Statement überhaupt in der OLE DB Source liegt. Wäre es nicht besser, das Statement in einer View, einer Table-Valued Function oder einer Stored Procedure zu kapseln? Als Datenbank-Objekt lässt es sich in einem SSDT-Datenbankprojekt versionieren, und Änderungen laufen über Schema Compare nachvollziehbar ins Deployment.
Bei der Bewertung der Vor- und Nachteile von SQL gegenüber SSIS unter dem Gesichtspunkt der Wartbarkeit fällt auch hier die Beurteilung eindeutig zugunsten von SQL aus.
Es gibt eine kleine Ausnahme: Sofern sich künftige Änderungen aus Änderungen der Infrastruktur (anderer Datenbank-Provider, verteilte Umgebung, etc.) ergeben, sind Vor- und Nachteile der beiden Technologien im Detail gegeneinander abzuwägen.
Performance
| Lösung 1 | Lösung 2 | Lösung 3 | Bewertung |
|---|---|---|---|
| Engine-nativ schnell | Ähnlich Lösung 1 | ≈ 2× langsamer | T-SQL bei synchroner Verarbeitung; SSIS bei async/Files |
Es gibt zahlreiche Faktoren, die die Performance beeinflussen können und bei einem belastbaren Vergleich zu berücksichtigen sind. Der Einfachheit halber bleiben diese Faktoren hier außen vor. Die gemessenen Ausführungszeiten stützen deshalb nur eine Tendenz-Aussage: Wenn eine Transformation vollständig innerhalb derselben Datenbank ausführbar ist, ist die SQL-Umsetzung häufig effizienter, weil der relationale Optimizer die Verarbeitung planen kann und kein zusätzlicher Datenfluss durch die SSIS-Pipeline nötig ist.
Ein Beispiel hierfür ist bereits das einfache Verjoinen von Tabellen. In SSIS müssen die Eingänge der Transformation Merge Join sortiert vorliegen. Eine dafür eingesetzte Sort-Transformation ist ein asynchroner, blockierender Verarbeitungsschritt: Sie muss ihren gesamten Input puffern, bevor die erste Zeile weiterfließt. Gegenüber einem Join, den der SQL-Optimizer innerhalb der Datenbank plant, entstehen dadurch in aller Regel zusätzliche Kosten.
In der hier gemessenen Konstellation lief die Lösung 3 (nur SSIS) rund doppelt so lange wie die Lösung 1 (nur SQL). Das ist eine bewusst undifferenzierte Aussage. Sie beruht auf genau einem Vergleich unter einer Konfiguration und taugt nicht als allgemeiner Benchmark.
Der Vollständigkeit halber sei allerdings erwähnt, dass es auch Aufgaben gibt, die in SSIS wesentlich besser performen als ein SQL-Statement.
Fazit
Für datenbanknahe, mengenorientierte Transformationen ist eine reine SQL-Umsetzung häufig effizienter als ein funktional gleichwertiger SSIS-Data-Flow. Ob das im Einzelfall zutrifft, muss gemessen werden.
Funktionsumfang
| Lösung 1 | Lösung 2 | Lösung 3 | Bewertung |
|---|---|---|---|
| Engine-Funktionen voll nutzbar | Wie Lösung 1 | Volle SSIS-Flexibilität (Quellen, Parallelisierung) | T-SQL bei SQL-Lösbarem; SSIS bei Non-SQL (Fuzzy, Files) |
Dieser Artikel behandelt eine Aufgabe, die unter anderem eindrucksvoll aufzeigt, wie unterschiedlich die Leistungsfähigkeit der gewählten Technologien ist. Was in diesem Beispiel mit einem vergleichsweise einfachen SQL-Statement gelöst werden kann, erfordert mit SSIS einen eher komplexen Lösungsansatz. Das zeigt nicht, dass SSIS generell ungeeignet wäre — es zeigt, dass rekursive Hierarchie-Verarbeitung und Window-Function-Semantik nicht zu den Stärken des klassischen Data Flows gehören. Ein grundsätzliches Plädoyer für T-SQL soll das nicht sein. Es gibt eine Menge Anforderungen, die mit T-SQL nicht oder nicht so einfach lösbar sind. SSIS ist ungleich flexibler bezüglich Datenquellen, Parallelisierung, Dateioperationen und vieler anderer Aspekte.
Fazit
Die tragfähigere Frage lautet nicht „SQL oder SSIS?“, sondern: Welche Verarbeitung gehört in welche Schicht? Als Faustregeln aus diesem Vergleich:
- Joins, Window Functions, rekursive Hierarchien → SQL
- mengenorientierte Transformationen auf Daten, die schon in der Datenbank liegen → SQL
- Datei- und API-Zugriffe, Fremdformate → SSIS
- Datenbewegung zwischen Systemen ohne Linked Server → SSIS
- Ablauf-Steuerung, Fehlerbehandlung, Benachrichtigung → SSIS
Wer nach diesen Regeln aufteilt, bekommt schlanke Pakete, deren SQL versionierbar bleibt — und nutzt SSIS dort, wo seine Stärken tatsächlich liegen.
ETL 2026 — wie viel SQL gehört heute in ein SSIS-Paket?
Die Kernfrage des Artikels lautet: Wie viel SQL gehört in eine ETL-Strecke, wie viel in die Engine? Das ist 2026 keine reine SQL-Server-Frage mehr. Der Microsoft-Stack ist eine Option neben anderen, und die Antwort „mehr SQL ist besser“ überträgt sich auf alle modernen Stacks. Drei Sichten auf die Tool-Landschaft, die die Wartbarkeits-Argumentation heute prägt (Produkt-Stände: August 2026).
Microsoft-Stack heute
Der Fakt zuerst: SQL Server Integration Services ist weiter Bestandteil von SQL Server 2022 und wird unterstützt, in der Standard- wie in der Enterprise-Edition. Erweiterte Adapter für Oracle, Teradata, SAP BW und Fuzzy Lookup sind Enterprise-only. Der Mainstream-Support für SQL Server 2022 läuft bis 2028, der erweiterte Support bis 2033. Von einem Auslaufmodell zu sprechen, ist also verfrüht.
Die Einschätzung danach: Der Schwerpunkt der Produktentwicklung liegt erkennbar nicht mehr bei SSIS. Größere Neuerungen kommen seit Jahren hauptsächlich für die Cloud-Pendants: Azure Data Factory und Synapse Pipelines liefern dieselben Drag-&-Drop-Paradigmen, ergänzt um Cloud-native Konnektoren (Blob Storage, Cosmos DB, Snowflake, Databricks). Wer einen SSIS-Stack auf Azure migriert, kann bestehende Pakete via SSIS Integration Runtime in ADF weiterbetreiben — Migrationspfad, kein End-of-Life.
Die Wartbarkeits-Frage aus diesem Artikel stellt sich dort genauso: auch in ADF/Synapse ist eine Copy Data-Activity mit eingebettetem SQL-Statement lesbarer als ein verschachtelter Pipeline-Graph mit 20+ Mapping-Data-Flow-Steps. Das Tool wechselt, die Architektur-Frage bleibt.
Postgres-Welt
Auf Postgres-Seite gibt es kein direktes SSIS-Pendant — die Welt ist offener und SQL-zentrierter. Drei Bausteine prägen die Architektur:
Bordmittel der Datenbank. COPY für Bulk-Loads aus CSV, Text und Binary, INSERT ... ON CONFLICT für Upserts, RETURNING für Kettung. COPY unterstützt die Formate text, csv und binary. Ein natives FORMAT json gibt es nicht. JSON lädt man deshalb zeilenweise als Text und überführt es anschließend nach jsonb. Für das Beispiel dieses Artikels reicht ein einziges Postgres-Statement — rekursive CTE, NTILE und DENSE_RANK sind Bordmittel seit Postgres 8.4:
  1: WITH RECURSIVE cte_employee AS
  2: (
  3:    SELECT
  4:        employee_key         AS employee_key
  5:       ,parent_employee_key  AS parent_employee_key
  6:       ,vacation_hours       AS vacation_hours
  7:       ,sick_leave_hours     AS sick_leave_hours
  8:       ,1                    AS hierarchy_level
  9:    FROM
 10:       public.dim_employee
 11:    WHERE
 12:       parent_employee_key IS NULL
 13:   AND status = 'Current'
 14:
 15:    UNION ALL
 16:
 17:    SELECT
 18:        T01.employee_key
 19:       ,T01.parent_employee_key
 20:       ,T01.vacation_hours
 21:       ,T01.sick_leave_hours
 22:       ,T02.hierarchy_level + 1
 23:    FROM
 24:       public.dim_employee AS T01
 25:       INNER JOIN cte_employee AS T02
 26:       ON
 27:          T01.parent_employee_key = T02.employee_key
 28:    WHERE
 29:       T01.status = 'Current'
 30: )
 31: INSERT INTO public.fct_employee_hierarchy_ranking
 32: SELECT
 33:     employee_key
 34:    ,hierarchy_level
 35:    ,vacation_hours
 36:    ,sick_leave_hours
 37:    ,NTILE(3)     OVER (PARTITION BY hierarchy_level ORDER BY vacation_hours,   employee_key)
 38:    ,DENSE_RANK() OVER (PARTITION BY hierarchy_level ORDER BY vacation_hours)
 39:    ,NTILE(3)     OVER (PARTITION BY hierarchy_level ORDER BY sick_leave_hours, employee_key)
 40:    ,DENSE_RANK() OVER (PARTITION BY hierarchy_level ORDER BY sick_leave_hours)
 41: FROM
 42:    cte_employee;
Dieselben relationalen Konstrukte wie in Lösung 1, also rekursive CTE und Window Functions, als ein Single-Statement — idiomatisch snake_case und ohne [Bracket]-Quoting. Ein Dialekt-Unterschied ist sichtbar: Postgres kennzeichnet rekursive CTEs explizit mit WITH RECURSIVE, T-SQL kommt ohne das Schlüsselwort aus.
dbt als Transform-Layer. dbt („data build tool“) ist SQL-zentriert: jedes Modell ist eine .sql-Datei mit einem SELECT, die Materialisierung (Table, View, Incremental, Snapshot) steuert eine Konfig-Direktive. Dasselbe Statement als dbt-Modell:
  1: {{ config(materialized = 'table') }}
  2:
  3: WITH RECURSIVE cte_employee AS
  4: (
  5:    SELECT
  6:        employee_key
  7:       ,parent_employee_key
  8:       ,vacation_hours
  9:       ,sick_leave_hours
 10:       ,1                   AS hierarchy_level
 11:    FROM
 12:       {{ ref('dim_employee') }}
 13:    WHERE
 14:       parent_employee_key IS NULL
 15:   AND status = 'Current'
 16:
 17:    UNION ALL
 18:
 19:    SELECT
 20:        e.employee_key
 21:       ,e.parent_employee_key
 22:       ,e.vacation_hours
 23:       ,e.sick_leave_hours
 24:       ,c.hierarchy_level + 1
 25:    FROM
 26:       {{ ref('dim_employee') }} AS e
 27:    INNER JOIN cte_employee AS c
 28:    ON
 29:       e.parent_employee_key = c.employee_key
 30:    WHERE
 31:       e.status = 'Current'
 32: )
 33: SELECT
 34:     employee_key
 35:    ,hierarchy_level
 36:    ,vacation_hours
 37:    ,sick_leave_hours
 38:    ,NTILE(3)     OVER (PARTITION BY hierarchy_level ORDER BY vacation_hours,   employee_key) AS vacation_hours_ntile
 39:    ,DENSE_RANK() OVER (PARTITION BY hierarchy_level ORDER BY vacation_hours)                 AS vacation_hours_dense_rank
 40:    ,NTILE(3)     OVER (PARTITION BY hierarchy_level ORDER BY sick_leave_hours, employee_key) AS sick_leave_hours_ntile
 41:    ,DENSE_RANK() OVER (PARTITION BY hierarchy_level ORDER BY sick_leave_hours)               AS sick_leave_hours_dense_rank
 42: FROM
 43:    cte_employee;
dbt kompiliert das Modell und setzt die konfigurierte Materialisierung adapterabhängig um, bei table typischerweise als CREATE TABLE AS SELECT. Es legt die Datenbank-Objekte zur Materialisierung an, baut einen DAG aller Modelle aus den {{ ref() }}-Verweisen und liefert versionierbare Diffs — derselbe Wartbarkeits-Hebel wie bei einer Stored Procedure, nur stack-übergreifend (Postgres, Snowflake, BigQuery, Redshift, Databricks).
Orchestrierung. Airflow, Prefect und Dagster werden häufig zur Orchestrierung von dbt- und Datenpipelines eingesetzt. Ein Task kann dort beliebige Arbeit ausführen, von Python über APIs bis zu Spark. In einer SQL-zentrierten Architektur bleibt die eigentliche Transformation aber in der Datenbank. Die SSIS-typische „Datenstrom-läuft-durch-die-Pipeline“-Semantik fehlt in diesen Werkzeugen. Für klassische analytische Transformationen skaliert mengenorientierte Verarbeitung in der Datenbank auch schlicht besser als zeilenorientierte in einer ETL-Pipeline.
Talend Open Studio. Das nächste echte SSIS-Pendant auf Postgres-Seite war Talend Open Studio, ebenfalls Drag-and-Drop und job-zentriert. Qlik hat die kostenfreie Variante zum 31. Januar 2024 eingestellt, gepflegt wird sie nur noch in Community-Forks mit unsicherem Status. Für Neuprojekte ist das kein tragfähiger Pfad mehr, bestehende Jobs sind Migrations-Kandidaten Richtung dbt und Airflow.
Die Frage bleibt: wie viel SQL?
Egal welcher Stack im Einsatz ist, ob SSIS, ADF, dbt, Airflow oder Talend: Die Wartbarkeits-Pointe ändert sich nicht. Das Statement gehört in die Datenbank, wenn die Datenbank es effizient ausführen kann. Die ETL-Engine sollte orchestrieren, wo die Datenbank rechnen kann. SSIS transformiert durchaus selbst — die Frage ist nicht, ob es das kann, sondern ob es die Aufgabe effizienter erledigt als die Engine darunter. Genau darauf sind die modernen Werkzeuge gebaut: dbt ist im Kern „SQL als Code“, und ADF-Copy Data-Activities performen dann am besten, wenn sie die Transformation an die SQL-Engine delegieren statt im Mapping-Data-Flow zu rechnen.
Die ursprüngliche Frage des Artikels, „wie viel SSIS soll es denn sein?“, überträgt sich in den modernen Tool-Stack als „wie viel ETL-Engine soll es denn sein?“. Die Antwort bleibt: so wenig wie möglich, so viel wie nötig.
Take-Away
- Wenn die Datenbank das Statement effizient ausführen kann, gehört das Statement in die Datenbank — nicht in die ETL-Engine. Das ist die strategische Architektur-Entscheidung, nicht eine Geschmacksfrage.
- Ein Data Flow mit 40+ Komponenten ist eine Wartbarkeits-Schuld, kein Feature. Jede künftige Anforderungs-Änderung wird teurer als sie sein müsste.
- Versionskontrolle ist ein Wartbarkeits-Kriterium. Stored-Procedure-Diffs sind lesbar,
.dtsx-Diffs sind es nicht. Wer ETL-Logik in der Engine versteckt, verliert die Audit-Trail-Fähigkeit. - Die Tool-Frage (SSIS, ADF, Talend, dbt, Airflow) ist nachgelagert. Die Aufteilung zwischen Datenbank-Engine und ETL-Pipeline ist die Entscheidung, die zählt. Das konkrete Tool ist Implementierungs-Detail.
FAQ
Stored Procedure — fast immer. Eine Prozedur ist im Datenbank-Repository sichtbar, lässt sich versionieren, durch Schema Compare in ein Visual-Studio-Datenbankprojekt überführen und im SQL Server Management Studio sauber editieren. Das SQL-Statement im SQL command text-Feld der OLE DB Source verschwindet im .dtsx-Paket: kein Syntax-Highlighting, kein vernünftiger Diff zwischen zwei Versionen, kein direkter Zugriff aus anderen Anwendungen.
Drei Trigger sind die üblichen: (1) die Pipeline läuft heute schon mehrheitlich auf SQL-Statements. Dann formalisiert dbt das als Transform-Layer, ohne dass die SQL-Substanz angefasst werden muss. (2) Die Orchestrierungs-Anforderungen wachsen über die SSIS-Bordmittel hinaus (Retry-Logik, Backfill, externe Trigger, paralleles Scheduling auf vielen Pipelines). Dann sind Airflow, Prefect oder Dagster eine bessere Antwort als SSIS-Sequence Containers. (3) Der Stack soll cloud- und multi-database-fähig werden. SSIS ist SQL-Server-zentrisch, dbt und Airflow sind dialekt-agnostisch.
.dtsx-Pakets? Pragmatisch: gar nicht. .dtsx-Dateien sind XML, das XML-Diff ist aber durch GUID-Reorderings und Position-Properties verrauscht. Praktikable Annäherungen: (1) BIDS Helper / SSDT-Diff-Erweiterung für Visual Studio zeigt einen Strukturbaum-Diff statt XML-Diff. (2) Screenshot-Diff der Control Flow– und Data Flow-Designer. (3) Begleitende SQL-Skripte in Stored Procedures auslagern, sodass der inhaltliche Diff im versionierbaren SQL-Skript stattfindet und das .dtsx nur Orchestrierung enthält. Option 3 ist die strategische Antwort und der eigentliche Punkt dieses Artikels.
Als ein einziges Statement — siehe Sektion „Postgres-Welt“ oben. Rekursive CTE für die Hierarchie-Ebenen, NTILE und DENSE_RANK als Window Functions pro Level, geschrieben in eine Ziel-Tabelle per INSERT INTO ... SELECT. Postgres bietet alle drei Konstrukte nativ. Ein SSIS-vergleichbarer Drag-&-Drop-Layer ist gar nicht nötig.
In der Regel reines T-SQL, sofern die Transformation vollständig innerhalb derselben Datenbank ausführbar ist. Die Datenbank-Engine kann dort den Optimizer, parallele Pläne und memory-resident Operatoren nutzen, während SSIS die Daten über Pipeline-Buffers durch den Data Flow bewegt und für jede Transformation zusätzlichen Aufwand erzeugt. Eine belastbare Faktor-Angabe gibt dieser Artikel bewusst nicht an: Der einzige hier gemessene Vergleich stammt aus einer einzigen Konfiguration, und das Verhältnis hängt von Datenmenge, Transformationsart, Hardware und Parallelität ab. Seine Stärken hat SSIS dort, wo Daten zwischen Systemen bewegt werden: parallel lesende und schreibende Pipelines, Datenübertragung zwischen Datenbanken ohne Linked Server, datei-zentrierte Strecken (Bulk-Insert aus 50 CSV-Files mit Schemaerkennung). Ob daraus im Einzelfall ein Performance-Vorteil wird, entscheidet die konkrete Pipeline. Die Frage „SSIS oder T-SQL“ ist also weniger Performance- als Architektur-Entscheidung.
Verwandte Artikel
SSIS-vs.-SQL-Cluster:
- SSIS vs. SQL — die Cluster-Wurzel mit der grundsätzlichen Tool-Diskussion.
- SSIS vs. SQL: Identitätswechsel — Schwester-Artikel zum
EXECUTE AS-Pattern. - SSIS vs. SQL: Quellcodeverwaltung — die Versionierungs-Argumentation aus diesem Artikel im Detail.
ETL-Kontext:
- Design Pattern // Architektur eines ETL-Prozesses — Big-Picture für die Strecken-Architektur.
- Datenqualität in einem ETL-Prozess — Datenqualitäts-Bausteine, die in jeder der drei Lösungen ergänzt werden müssen.
- Design Pattern // Protokollierung eines ETL-Prozesses mit SQL — Logging-Pattern, das den
.dtsx-Diff-Vorteil von SQL noch verstärkt.