Ein Katalog mit rund 3000 Produktkonfigurationen liegt als XML vor. Je nach Ausstattung trägt eine Konfiguration andere und zusätzliche Attribute, über alle Varianten sind es etwa tausend. In einem früheren Projekt lief die Auswertung eines solchen Katalogs im Anwendungscode: eine Schleife über die Objekttypen, darin eine Schleife über die Attribute, dazu Listen im Speicher, die mit jedem Durchlauf länger wurden. Das Programm brauchte mehrere Stunden. Woran genau die Zeit hing, lässt sich im Rückblick nicht mehr sagen. Sicher ist nur, was der Zuschnitt verlangte: Code pro Typ, ein eigener Zugriff pro Attribut und ein Schema, das vorher im Kopf sein musste. Dieser Artikel zeigt, wie sich dasselbe XML in SQL Server auslesen lässt, ohne die Attribute vorher zu kennen: roh laden, in eine Pfad/Wert-Tabelle zerlegen, die je Wert eine Zeile mit seinem Pfad im Dokument hält, das Schema aus den Daten ablesen und die Views pro Typ von der Datenbank erzeugen lassen. In der Messung dieses Artikels dauert das für einen Katalog derselben Größenordnung keine Stunden, sondern rund 15 Sekunden.
Auf einen Blick
- Warum Schleifen über Objekttypen und Attribute bei tausend Attributen so teuer werden, und was der Datenbank-Weg anders macht: Die Attribute werden Datenzeilen statt Code.
- Wie der Katalog als ein einziger XML-Wert in SQL Server geladen und dann in 3000 Tabellenzeilen zerlegt wird, eine je Konfiguration. Aus diesen Zeilen holt eine Abfrage, in der kein Attributname vorkommt, jeden Wert zusammen mit seinem Pfad im Dokument, etwa
/Antrieb/Gaengemit dem Wert14. Das Ergebnis sind 1,5 Millionen solcher Zeilen aus Pfad und Wert, und der ganze Weg dauert in der Messung rund 15 Sekunden statt Stunden. - Wie eine Inventur aus diesen Zeilen Pflicht-, optionale und Varianten-Attribute je Typ ablesbar macht, ohne dass jemand die Attribute vorher kannte.
- Wie die Datenbank aus der Inventur Views mit über 600 Spalten selbst erzeugt, und wo die Grenzen des Verfahrens liegen: Spaltenlimits, Typisierung, sehr große Dateien. Was es voraussetzt, ist wenig: das Element der Teildokumente, eine Obergrenze für die Tiefe und Listen, die sich in mindestens einer Konfiguration gleichförmig wiederholen.
Voraussetzung: Docker und SQL Server 2022 als Container (Developer Edition). Die Skripte laufen mit sqlcmd, dem Kommandozeilen-Client, der im Container mitgeliefert ist. Der Aufruf steht am Anfang des Abschnitts „Roh laden“. Der Beispiel-Katalog, der Generator dafür und die Skripte liegen in vier Downloads am Ende des Artikels: der XML-Weg und der JSON-Weg, jeweils für SQL Server und für Postgres. Für die Brücke am Schluss dient Postgres 18.6.
Inhalt
- Der Katalog: drei Typen, ein Antrieb mit zwei Gesichtern
- Warum Schleifen über variable Attribute teuer werden
- Roh laden: eine Zeile pro Konfiguration
- Generisch zerlegen: jedes Blatt mit seinem Pfad
- Inventur: das Schema aus den Daten ablesen
- Views generieren statt schreiben
- Postgres-Brücke
- Grenzen und Entscheidungen
- Zusammenfassung
- FAQ
- Verwandte Artikel
Der Katalog: drei Typen, ein Antrieb mit zwei Gesichtern
Das Beispiel ist ein Fahrrad-Konfigurator mit 3000 Konfigurationen. Es gibt drei Objekttypen: Rennrad, Trekkingrad und Lastenrad. Die drei Typen teilen sich die Gruppen Stammdaten, Rahmen, Bremsen und Laufraeder, und schon hier ähneln sie sich mehr, als sie sich unterscheiden. Was im Antrieb steht, hängt von seinem XML-Attribut art ab. Trägt er art="kette", stehen darin Kettenblätter, Ritzel, Schaltwerk, Umwerfer, Übersetzungen und Kettenlinie. Trägt er art="nabe", stehen darin Gänge, Bandbreite, Riemen, Nabentyp und Rücktritt. Dieselbe Gruppe, aber je nach Variante andere Attribute. Auch die Bremsen tragen ihre Bauart als XML-Attribut, typ, und nicht als Kind-Element. Licht und Federung sind optionale Gruppen, die ein Rennrad selten und ein Lastenrad fast immer hat. Zwei Gruppen sind Listen. Zubehoer enthält null bis vier Teil-Elemente mit Name, Gewicht und Serienkennzeichen. Laufraeder enthält immer zwei Laufrad-Elemente, eines für vorn und eines für hinten, mit Felge, Reifen und Speichenzahl.
„Attribut“ meint in diesem Artikel das fachliche Merkmal einer Konfiguration, etwa die Zahl der Gänge oder das Material des Rahmens. Im XML steht ein solches Merkmal meist als Element und nur selten als XML-Attribut. Wo das XML-Konstrukt gemeint ist, heißt es im Folgenden ausdrücklich XML-Attribut.
Um auf die Größenordnung von tausend Attributen zu kommen, trägt jede Konfiguration zusätzlich zwölf von zwanzig Parametergruppen mit je 48 Werten, von denen jeder einzelne mit achtzig Prozent Wahrscheinlichkeit vorhanden ist. Diese Gruppen heißen schlicht G01 bis G20 und sind Füllmaterial. Sie stehen hier, damit die Messungen die richtige Größenordnung haben, nicht weil sie fachlich etwas bedeuten. Welcher Typ welche Gruppen trägt, ist so verteilt, dass sich die Typen überlappen, aber nicht decken.
So sieht eine Konfiguration gekürzt aus:
  1: <Konfiguration id="K000001" typ="lastenrad">
  2:   <Stammdaten>
  3:     <Modell>Lastenrad-214</Modell>
  4:     <Modelljahr>2019</Modelljahr>
  5:     <Gewicht>13.25</Gewicht>
  6:     <Preis>4576.94</Preis>
  7:   </Stammdaten>
  8:   <Rahmen>
  9:     <Material>Aluminium</Material>
 10:     <Groesse>56</Groesse>
 11:   </Rahmen>
 12:   <Antrieb art="nabe">
 13:     <Gaenge>14</Gaenge>
 14:     <Bandbreite>371</Bandbreite>
 15:     <Riemen>ja</Riemen>
 16:   </Antrieb>
 17:   <Bremsen typ="Scheibe hydraulisch">
 18:     <Scheibe_vorn>160</Scheibe_vorn>
 19:     <Belag>gesintert</Belag>
 20:   </Bremsen>
 21:   <Laufraeder>
 22:     <Laufrad><Position>vorn</Position><Felge>584x23</Felge><Reifen>32-622</Reifen><Speichen>24</Speichen></Laufrad>
 23:     <Laufrad><Position>hinten</Position><Felge>559x25</Felge><Reifen>47-622</Reifen><Speichen>36</Speichen></Laufrad>
 24:   </Laufraeder>
 25:   <Licht>
 26:     <Vorn_Lumen>70</Vorn_Lumen>
 27:     <Versorgung>Nabendynamo</Versorgung>
 28:   </Licht>
 29:   <Zubehoer>
 30:     <Teil><Name>Flaschenhalter</Name><Gewicht>275</Gewicht><Serie>ja</Serie></Teil>
 31:     <Teil><Name>Tacho</Name><Gewicht>441</Gewicht><Serie>ja</Serie></Teil>
 32:   </Zubehoer>
 33:   <Parameter>
 34:     <G09><P02>552.04</P02><P04>861.71</P04><P06>B</P06></G09>
 35:   </Parameter>
 36: </Konfiguration>
Der Katalog stammt nicht aus einem realen Projekt, sondern aus einem Python-Skript, dem Generator aus dem Download. Das Skript würfelt Typ, Ausstattung und Werte jeder Konfiguration aus, startet den Zufallsgenerator aber bei jedem Lauf mit demselben Startwert, dem Seed. Deshalb liefert jeder Lauf exakt denselben Katalog, und alle Zahlen in diesem Artikel lassen sich damit nachrechnen. Das XML ist 28 MB groß und enthält gut 1,5 Millionen Werte. Dieselben Daten gibt es als JSON Lines, eine Zeile pro Konfiguration, in der Schreibweise, die das Python-Paket xmltodict erzeugt: Attribute als Schlüssel mit @, wiederholte Elemente als Arrays. Jede der beiden Dateien liegt mit dem Generator in eigenen Downloads, XML und JSON getrennt.
Warum Schleifen über variable Attribute teuer werden
Der naheliegende Entwurf im Anwendungscode sieht so aus: Für jeden Objekttyp gibt es eine Klasse oder eine Zuordnungstabelle, die seine Attribute kennt. Für jede Konfiguration läuft der Code die Attribute dieses Typs ab, sucht den Knoten im Dokument, liest den Wert und legt ihn in einer Liste ab. Taucht ein Wert auf, den die Liste noch nicht kennt, wächst die Liste. Bei drei Typen und zwanzig Attributen ist das übersichtlich. Bei tausend Attributen, die sich teilweise überlappen und teilweise nur in einer Variante vorkommen, wird daraus Code, der die Struktur des Katalogs nachbaut, Zeile für Zeile. Jedes neue Attribut ist eine Codeänderung. Jeder Zugriff auf einen Knoten ist ein eigener Suchlauf im Dokument. Und jede Liste, die mit dem Fortschritt wächst, wird mit jedem Durchlauf ein bisschen langsamer durchsucht.
Wo genau die Stunden im damaligen Projekt entstanden, lässt sich nicht mehr belegen, und dieser Artikel behauptet es auch nicht. Er behauptet nur, dass der Zuschnitt die Kosten multipliziert: Typen mal Attribute mal Konfigurationen, dazu Listen, deren Größe von der Reihenfolge der Verarbeitung abhängt. Das allgemeine Argument, warum eine Schleife je Element gegen eine Abfrage über die Menge verliert, erklärt der Artikel Set-basiert statt Schleife an einer anderen Fallstudie. Hier geht es um den Spezialfall, dass die Schleife nicht einmal weiß, worüber sie läuft, weil das Schema erst in den Daten steckt. Die Programmiersprache ist dabei nicht das Problem. Ein Programm, das den Baum einmal durchläuft und jedes Blatt mit seinem Pfad ausgibt, kommt ohne Schema aus und bleibt schnell, und genau das zeigt der Zwilling zu diesem Artikel in Python. Teuer wird es erst durch den Zuschnitt, der für jedes Attribut erneut im Dokument sucht.
Der Datenbank-Weg dreht die Aufgabe um. Er kennt die Attribute nicht und braucht sie auch nicht zu kennen. Was er voraussetzt, ist wenig: das Element, unter dem die Konfigurationen liegen, und eine Obergrenze für die Tiefe des Baums. Dazu kommt eine Annahme über Listen: Er erkennt sie nur, wenn sich darin in mindestens einer Konfiguration ein Elementname wiederholt. Er lädt das Dokument roh, zerlegt es mit generischen Abfragen, in denen kein Attributname vorkommt, in Zeilen aus Pfad und Wert, und erst danach wird geschaut, welche Pfade es überhaupt gibt. Die tausend Attribute sind dann tausend verschiedene Werte in einer Spalte, keine tausend Zeilen Code. Das Schema wird gezählt statt gewusst. Und die Views, die ein Abnehmer am Ende sehen will, baut die Datenbank aus dieser Zählung selbst. Architektonisch ist das ELT: roh laden, dann in SQL transformieren. Was das vom klassischen ETL unterscheidet, steht in ETL vs. ELT.
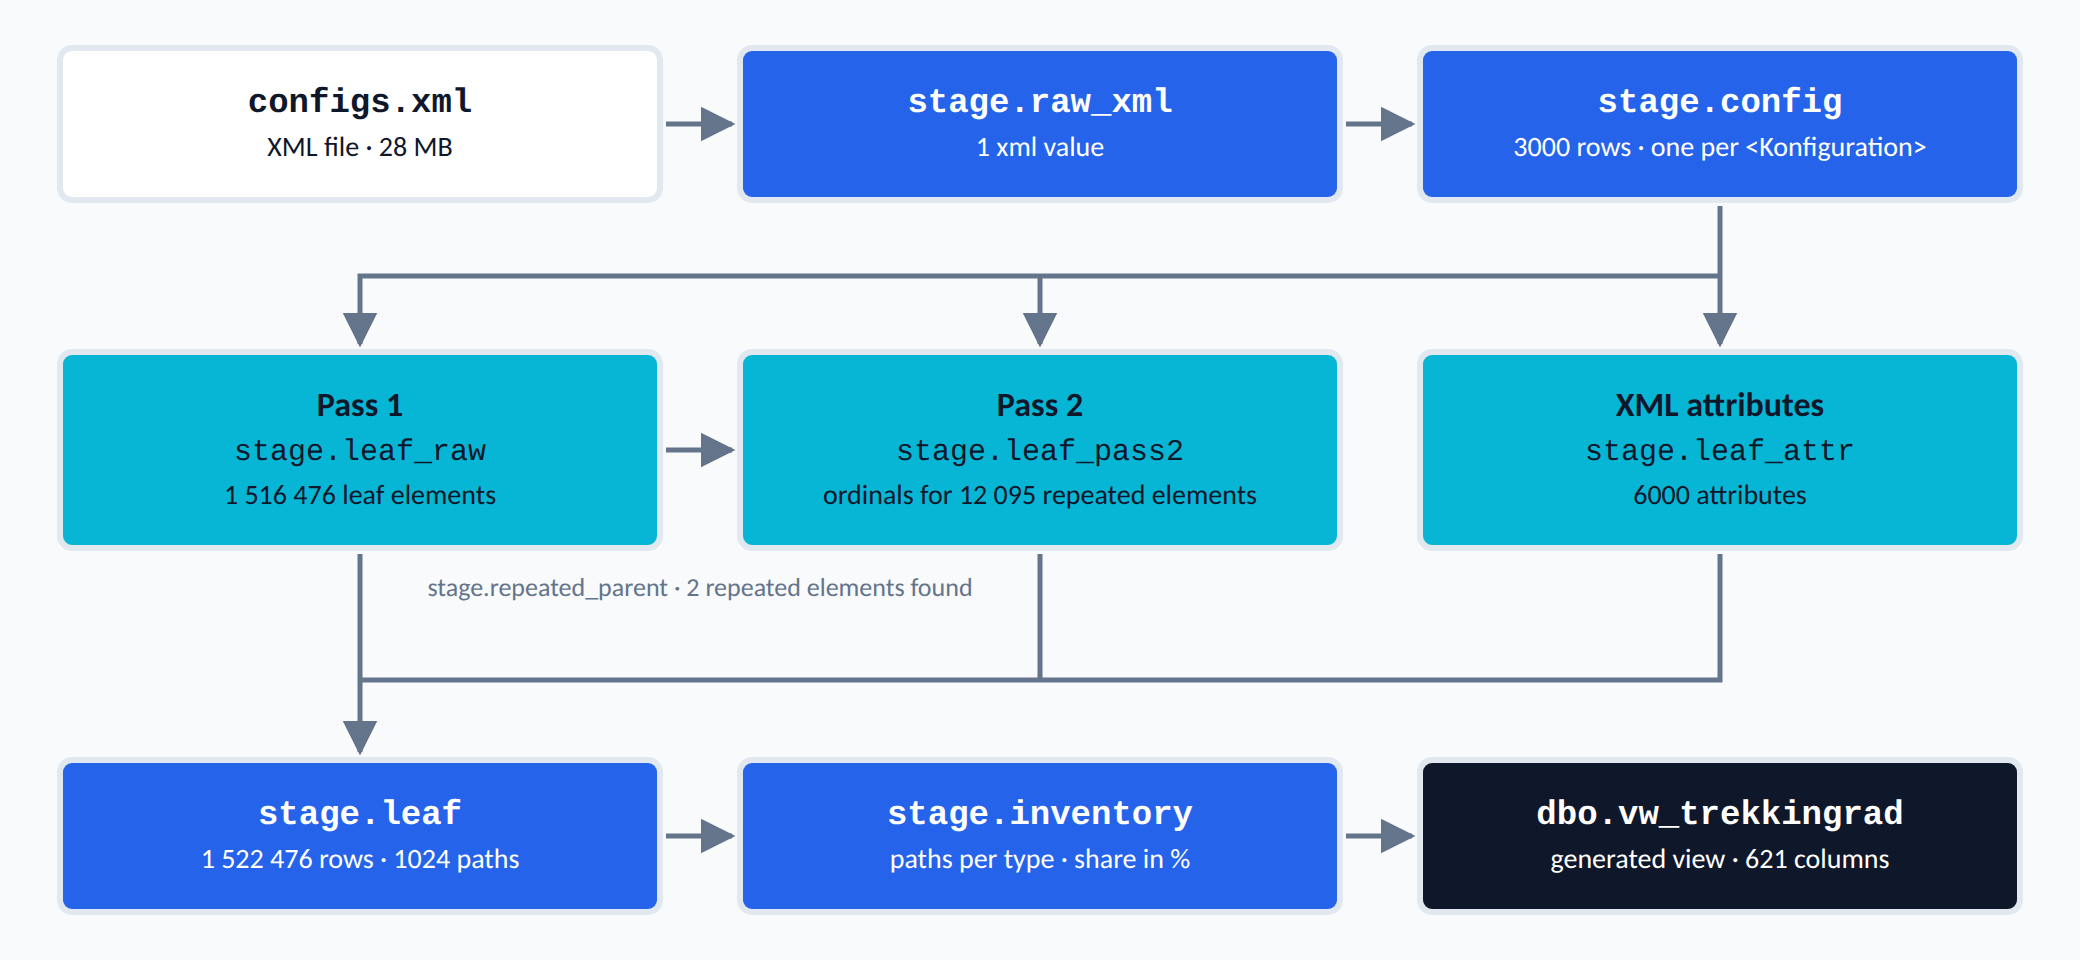
Das folgende Diagramm zeigt den ganzen Weg mit den Tabellen, die in den nächsten Abschnitten entstehen, und mit den Zahlen aus dem Beispiel-Katalog.
Roh laden: eine Zeile pro Konfiguration
Alle SQL-Server-Skripte dieses Artikels laufen gegen einen Docker-Container. Der Katalog und die Skripte werden mit docker cp nach /tmp im Container kopiert, dorthin zeigen die Pfade in den Skripten. Ausgeführt wird jede Datei mit sqlcmd, das im Image mitgeliefert ist: Der Schalter -i nennt die Datei, -C akzeptiert das selbstsignierte Zertifikat des Containers, und -I schaltet QUOTED_IDENTIFIER ein, was die XML-Methoden verlangen. Für die weiteren Dateien ändert sich nur der Dateiname.
  1: docker run -d --name 147-mssql-xml -e ACCEPT_EULA=Y -e MSSQL_SA_PASSWORD='S3cret!Pass' `
  2:     mcr.microsoft.com/mssql/server:2022-latest
  3: docker exec 147-mssql-xml /opt/mssql-tools18/bin/sqlcmd -C -S localhost -U sa -P 'S3cret!Pass' `
  4:     -Q "CREATE DATABASE catalog"
  5: docker cp .\configs.xml 147-mssql-xml:/tmp/configs.xml
  6: docker cp .\147001-mssql-xml-laden.sql 147-mssql-xml:/tmp/147001-mssql-xml-laden.sql
  7: docker exec 147-mssql-xml /opt/mssql-tools18/bin/sqlcmd -C -I -S localhost -U sa -P 'S3cret!Pass' `
  8:     -d catalog -i /tmp/147001-mssql-xml-laden.sql
Der erste Schritt lädt die ganze Datei als einen Wert vom Typ xml. OPENROWSET im Modus SINGLE_BLOB liefert die Datei als varbinary, und CONVERT nach xml parst sie einmal in die interne Darstellung von SQL Server. Danach wird das Dokument sofort gesplittet: nodes() liefert pro Konfiguration-Element eine Zeile, value() holt die beiden XML-Attribute als Spalten, und query('.') legt das Fragment als eigenen xml-Wert ab.
  1: -- --------------------------------------------------------------------------------
  2: -- 147001: Katalog laden und in eine Zeile pro Konfiguration splitten (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- XML-Methoden verlangen QUOTED_IDENTIFIER ON; sqlcmd startet mit OFF (Schalter -I).
  5: SET QUOTED_IDENTIFIER ON;
  6: GO
  7: IF SCHEMA_ID('stage') IS NULL EXEC ('CREATE SCHEMA [stage]');
  8: GO
  9: -- --------------------------------------------------------------------------------
 10: -- Das ganze Dokument als ein xml-Wert
 11: -- --------------------------------------------------------------------------------
 12: DROP TABLE IF EXISTS [stage].[raw_xml];
 13: CREATE TABLE [stage].[raw_xml]
 14: (
 15:     doc   xml NOT NULL
 16: );
 17:
 18: INSERT INTO [stage].[raw_xml] (doc)
 19: SELECT
 20:    CONVERT(xml, T01.BulkColumn)
 21: FROM
 22:    OPENROWSET(BULK '/tmp/configs.xml', SINGLE_BLOB) AS T01;
 23:
 24: -- --------------------------------------------------------------------------------
 25: -- Eine Zeile pro Konfiguration: Schluessel, Typ und das Fragment als xml
 26: -- --------------------------------------------------------------------------------
 27: DROP TABLE IF EXISTS [stage].[config];
 28: SELECT
 29:     T02.n.value('@id',  'varchar(20)') AS config_id
 30:    ,T02.n.value('@typ', 'varchar(20)') AS config_type
 31:    ,T02.n.query('.')                   AS node
 32: INTO [stage].[config]
 33: FROM
 34:    [stage].[raw_xml] T01
 35:    CROSS APPLY T01.doc.nodes('/Katalog/Konfiguration') AS T02(n);
 36:
 37: SELECT
 38:     config_type
 39:    ,COUNT(*) AS configs
 40: FROM
 41:    [stage].[config]
 42: GROUP BY
 43:    config_type;
 44: -- lastenrad     1025
 45: -- rennrad        995
 46: -- trekkingrad    980
Der Split ist der wichtigste Schritt des ganzen Verfahrens, und zwar aus einem Grund, der erst später sichtbar wird. Alle folgenden XQuery-Ausdrücke laufen dann gegen Fragmente von rund 9 KB statt gegen ein Dokument von 28 MB. Was das ausmacht, zeigt Postgres drastischer als SQL Server: Dort lief dieselbe generische Abfrage über das ganze Dokument nach 36 Minuten noch, und ließ sich nicht einmal abbrechen. Mehr dazu in der Postgres-Brücke.
Eine Falle gleich zu Beginn: Die XML-Methoden nodes(), value() und query() verlangen QUOTED_IDENTIFIER ON, neben weiteren Sitzungsoptionen wie ANSI_NULLS, ANSI_PADDING und ANSI_WARNINGS, die in sqlcmd schon gesetzt sind. Das Werkzeug sqlcmd startet aber mit QUOTED_IDENTIFIER OFF, und die Fehlermeldung dazu nennt zwar die Option, sagt aber nicht, welches Konstrukt im Statement sie braucht, sondern zählt alle Features auf, die davon abhängen. Der Schalter -I beim Aufruf von sqlcmd erledigt das, alternativ die erste Zeile im Skript.
Generisch zerlegen: jedes Blatt mit seinem Pfad
Das Ziel ist eine Tabelle mit vier Spalten: Konfiguration, Typ, Pfad und Wert. In der SQL-Server-Welt heißt dieses Zerlegen eines Dokuments in Zeilen XML Shredding, und die Werkzeuge dafür sind die Methoden nodes() und value() des xml-Typs. Die Werte stehen in den Blättern des Baums, also in Elementen ohne Kind-Elemente, und außerdem in XML-Attributen. Ein XML-Attribut kann an jedem Element hängen, auch an einem mit Kindern, so wie art am Antrieb. Der Pfad ist die Kette der Elementnamen vom Konfiguration-Element bis zum Blatt, bei einem XML-Attribut endet er mit @ und dem Attributnamen. Aus dem Lese-Auszug oben werden so Zeilen wie /Rahmen/Material mit dem Wert Aluminium, /Antrieb/Gaenge mit dem Wert 14 oder /Antrieb/@art mit dem Wert nabe.
Das passiert in zwei Durchläufen über alle 3000 Fragmente, im Folgenden Pass 1 und Pass 2 genannt. Der Grund für die Aufteilung sind die Listen. Eine Konfiguration mit zwei Zubehör-Teilen hat zwei Elemente mit demselben Pfad /Zubehoer/Teil/Name. Um sie auseinanderzuhalten, müsste zu jedem Element seine Position unter den gleichnamigen Geschwistern mitkommen, also ob es das erste oder das zweite Teil ist. Diese Position heißt im Folgenden Ordinal und steht in eckigen Klammern im Pfad, etwa /Zubehoer/Teil[2]/Name. Ihre Berechnung ist in SQL Server teuer: Für jedes der 1,5 Millionen Blätter müsste die XQuery-Engine die Geschwister davor zählen, und das hebt die Laufzeit in der Messung von rund zwei auf rund 40 Sekunden. Pass 1 holt deshalb alle Werte mit ihrem Pfad, aber ohne Positionen. Aus seinem Ergebnis lässt sich mit einer gewöhnlichen Gruppierung ablesen, an welchen Stellen sich Elemente überhaupt wiederholen, im Katalog sind das Teil unter Zubehoer und Laufrad unter Laufraeder. Pass 2 berechnet die Positionen dann nur für diese Stellen, also für rund 12 000 Elemente statt für 1,5 Millionen. XML-Attribute sind keine Elemente und werden von beiden Pässen übergangen, sie bekommen einen eigenen, kurzen Durchlauf.
Pass 1: alle Blätter, keine Positionen
Der Pfad-Ausdruck /Konfiguration//*[not(*)] trifft jedes Element im Fragment, das kein Kind-Element hat, auf beliebiger Tiefe. Die Namen seiner Vorfahren liefert die Parent-Achse: local-name(..) ist der Name des Elternelements, local-name(../..) der des Großelternelements und so weiter. SQL Server unterstützt in XQuery die Achsen child, descendant, descendant-or-self, parent, attribute und self, aber nicht ancestor. Deshalb ist die Tiefe fest zu wählen. Der Katalog hat höchstens drei Ebenen unter der Konfiguration, vier Namensspalten reichen also mit einer Spalte Reserve: In der vierten steht immer Konfiguration. Genau das lässt sich prüfen. Ein Blatt, bei dem Konfiguration in keiner Vorfahren-Spalte steht, liegt tiefer als die Reserve, und ab der fünften Ebene wäre sein Pfad vorn abgeschnitten, ohne dass eine Fehlermeldung darauf hinweist. Wer tiefere Dokumente hat, ergänzt Spalten.
  1: -- --------------------------------------------------------------------------------
  2: -- 147002: Pass 1 - jedes Blatt-Element mit den Namen seiner Vorfahren (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Ein Durchlauf ueber alle Konfigurationen. Die Parent-Achse (..) liefert die
  5: -- Namen der Vorfahren; Positionen werden hier bewusst NICHT berechnet.
  6: SET QUOTED_IDENTIFIER ON;
  7: GO
  8: DROP TABLE IF EXISTS [stage].[leaf_raw];
  9: SELECT
 10:     T01.config_id
 11:    ,T01.config_type
 12:    ,T02.n.value('local-name(.)',        'varchar(100)') AS name0   -- das Blatt selbst
 13:    ,T02.n.value('local-name(..)',       'varchar(100)') AS name1   -- Eltern
 14:    ,T02.n.value('local-name(../..)',    'varchar(100)') AS name2   -- Grosseltern
 15:    ,T02.n.value('local-name(../../..)', 'varchar(100)') AS name3   -- Urgrosseltern
 16:    ,T02.n.value('.',                    'varchar(200)') AS value
 17: INTO [stage].[leaf_raw]
 18: FROM
 19:    [stage].[config] T01
 20:    CROSS APPLY T01.node.nodes('/Konfiguration//*[not(*)]') AS T02(n);
 21:
 22: SELECT
 23:    COUNT(*) AS leaves
 24: FROM
 25:    [stage].[leaf_raw];
 26: -- 1516476
Dieser eine Durchlauf liefert alle 1 516 476 Blatt-Elemente der 3000 Konfigurationen in rund zwei Sekunden. Die Zeilen 12 bis 15 holen die vier Namen, Zeile 16 den Wert, und das ist schon alles. Was absichtlich fehlt, ist die Position eines Elements unter seinen Geschwistern. Sie wäre nötig, um die beiden Teil-Elemente im Zubehör auseinanderzuhalten. Der naheliegende XQuery-Ausdruck dafür lautet let $i := . return count(../*[. << $i]) + 1: Zähle die Geschwister, die im Dokument vor mir stehen. Mit zwei solchen Ausdrücken, einem für das Blatt und einem für sein Elternelement, braucht dieselbe Abfrage statt rund zwei Sekunden das Zwanzigfache, gemessen waren es 1,8 gegen 40,2 Sekunden. Für jedes der 1,5 Millionen Blätter läuft SQL Server dann die Geschwisterliste ab und vergleicht Dokumentpositionen, und genau diese Auswertung ist in der XQuery-Engine teuer. Die Position flächig zu berechnen ist also keine Option. Sie wird im zweiten Pass nur dort berechnet, wo sie gebraucht wird.
XML-Attribute
XML-Attribute sind keine Elemente und tauchen in Pass 1 nicht auf, egal ob sie an einem Blatt oder an einem Element mit Kindern hängen. Dafür gibt es einen eigenen, kurzen Durchlauf. Die Methode nodes() liefert in SQL Server 2022 auch Attributknoten, der Pfad /Konfiguration//@* trifft alle XML-Attribute im Fragment, und die Parent-Achse führt vom XML-Attribut zu dem Element, das es trägt. Die beiden XML-Attribute des Konfiguration-Elements selbst sind bereits Spalten und werden ausgeklammert.
  1: -- --------------------------------------------------------------------------------
  2: -- 147003: Attribute - nodes() liefert auch Attributknoten (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Die Attribute der Konfiguration selbst (id, typ) sind schon Spalten in
  5: -- [stage].[config] und werden hier ausgeklammert.
  6: SET QUOTED_IDENTIFIER ON;
  7: GO
  8: DROP TABLE IF EXISTS [stage].[leaf_attr];
  9: SELECT
 10:     T01.config_id
 11:    ,T01.config_type
 12:    ,T02.n.value('local-name(.)',        'varchar(100)') AS attr_name
 13:    ,T02.n.value('local-name(..)',       'varchar(100)') AS name1   -- Element, das das Attribut traegt
 14:    ,T02.n.value('local-name(../..)',    'varchar(100)') AS name2
 15:    ,T02.n.value('local-name(../../..)', 'varchar(100)') AS name3
 16:    ,T02.n.value('.',                    'varchar(200)') AS value
 17: INTO [stage].[leaf_attr]
 18: FROM
 19:    [stage].[config] T01
 20:    CROSS APPLY T01.node.nodes('/Konfiguration//@*') AS T02(n)
 21: WHERE
 22:    T02.n.value('local-name(..)', 'varchar(100)') <> 'Konfiguration';
 23:
 24: SELECT
 25:     name1
 26:    ,attr_name
 27:    ,COUNT(*) AS n
 28: FROM
 29:    [stage].[leaf_attr]
 30: GROUP BY
 31:     name1
 32:    ,attr_name
 33: ORDER BY
 34:     name1
 35:    ,attr_name;
 36: -- Antrieb   art   3000
 37: -- Bremsen   typ   3000
Im Katalog gibt es zwei weitere XML-Attribute, art am Antrieb und typ an den Bremsen, und der Durchlauf dauert eine halbe Sekunde.
Pass 2: Ordinale nur, wo sich etwas wiederholt
Ohne Positionen fallen die beiden Teil-Elemente einer Konfiguration auf denselben Pfad /Zubehoer/Teil/Name. Für die Inventur im nächsten Abschnitt ist das sogar in Ordnung, für eine View mit einer Spalte pro Pfad nicht. Die Lösung hat zwei Schritte. Zuerst wird set-basiert aus Pass 1 abgelesen, welche Elternelemente sich überhaupt wiederholen: Liegt in einer Konfiguration unter demselben Elternpfad mehr als ein Blatt mit demselben Namen, dann wiederholt sich das Elternelement, oder das Blatt selbst wiederholt sich innerhalb des Elternelements. Beides braucht Ordinale. Welcher der beiden Fälle vorliegt, verrät die Gruppierung nicht, in Pass 1 sehen beide gleich aus. Die Vorlage unten löst den ersten. Den zweiten zeigt die Inventur nach Pass 2 an: Der Pfad trägt dann in einer Konfiguration mehr als einen Wert.
  1: -- --------------------------------------------------------------------------------
  2: -- 147004: Welche Eltern wiederholen sich? Set-basiert aus Pass 1 (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Ein Eltern-Element wiederholt sich, wenn unter demselben Eltern-Pfad innerhalb
  5: -- einer Konfiguration mehr als ein gleichnamiges Blatt liegt. Dieselbe Abfrage
  6: -- findet auch Blaetter, die sich innerhalb eines Elternteils wiederholen.
  7: DROP TABLE IF EXISTS [stage].[repeated_parent];
  8: WITH
  9: CTE_leaf_count AS
 10: (
 11:    SELECT
 12:        config_id
 13:       ,name3
 14:       ,name2
 15:       ,name1
 16:       ,name0
 17:       ,COUNT(*) AS n
 18:    FROM
 19:       [stage].[leaf_raw]
 20:    GROUP BY
 21:        config_id
 22:       ,name3
 23:       ,name2
 24:       ,name1
 25:       ,name0
 26: )
 27: SELECT DISTINCT
 28:     CASE WHEN name2 = 'Konfiguration' THEN ''
 29:          WHEN name3 = 'Konfiguration' THEN '/' + name2
 30:          ELSE '/' + name3 + '/' + name2 END AS parent_path
 31:    ,name1 AS parent_name
 32: INTO [stage].[repeated_parent]
 33: FROM
 34:    CTE_leaf_count
 35: WHERE
 36:    n > 1;
 37:
 38: SELECT
 39:     parent_path
 40:    ,parent_name
 41: FROM
 42:    [stage].[repeated_parent]
 43: ORDER BY
 44:    parent_path;
 45: -- /Laufraeder   Laufrad
 46: -- /Zubehoer     Teil
Die Abfrage findet zwei Stellen, /Laufraeder mit dem Kind Laufrad und /Zubehoer mit dem Kind Teil, und braucht dafür unter einer Sekunde. Erst jetzt kommt die teure Positionsberechnung zum Einsatz, und zwar nur für die Knoten, die diese Erkennung geliefert hat. Für jede gefundene Stelle entsteht aus einer Vorlage ein SELECT, das die betroffenen Elternelemente mit nodes() holt, ihre Position unter den gleichnamigen Geschwistern berechnet und darunter die Blätter mit ihrer eigenen Position liest. An einer solchen Stelle bekommt jedes Element sein Ordinal, auch wenn eine Konfiguration dort nur ein einziges Element hat. Eine Konfiguration mit drei Teilen bekommt /Zubehoer/Teil[1]/Name bis /Zubehoer/Teil[3]/Name, eine mit genau einem Teil /Zubehoer/Teil[1]/Name. Bliebe das einzelne Teil ohne Ordinal, läge das erste Element derselben Liste je nach Konfiguration auf zwei verschiedenen Pfaden. Die Inventur würde eine Liste dann als zwei Dinge zählen, und der Pfad ohne Ordinal fiele als Spalte in die View des Typs, gefüllt nur für die Konfigurationen mit genau einem Teil. Die beiden Laufräder jeder Konfiguration heißen entsprechend /Laufraeder/Laufrad[1]/Felge und /Laufraeder/Laufrad[2]/Felge.
  1: -- --------------------------------------------------------------------------------
  2: -- 147005: Pass 2 - Ordinale nur fuer die Eltern, die sich wiederholen (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Fuer jede Zeile aus [stage].[repeated_parent] entsteht aus der Vorlage ein
  5: -- SELECT. An einer solchen Stelle bekommt jedes Element sein Ordinal, auch wenn
  6: -- eine Konfiguration dort nur ein einziges Element hat: Eine Liste bleibt eine
  7: -- Liste, und ihr erstes Element liegt in jeder Konfiguration auf demselben Pfad.
  8: -- Der teure Positionsausdruck laeuft nur ueber die wenigen betroffenen Knoten,
  9: -- nicht ueber alle Blaetter.
 10: -- Wiederholen sich Blaetter direkt innerhalb eines Elternelements, bekommt die
 11: -- Vorlage denselben Ausdruck noch einmal auf Blattebene (T03). Das kostet ein
 12: -- Vielfaches der Laufzeit von Pass 2 und ist hier nicht noetig. Ob der Fall
 13: -- vorliegt, zeigt die Inventur: n_values groesser als n_configs.
 14: SET QUOTED_IDENTIFIER ON;
 15: GO
 16: DECLARE @template nvarchar(max) = N'
 17: SELECT
 18:     T01.config_id
 19:    ,T01.config_type
 20:    ,''{path}/{name}''
 21:     + T02.n.value(''let $p := .
 22:                     return concat("[", string(count(../*[local-name() = "{name}"][. << $p]) + 1), "]")'', ''varchar(10)'')
 23:     + ''/'' + T03.n.value(''local-name(.)'', ''varchar(100)'') AS path
 24:    ,T03.n.value(''.'', ''varchar(200)'') AS value
 25: FROM
 26:    [stage].[config] T01
 27:    CROSS APPLY T01.node.nodes(''/Konfiguration{path}/{name}'') AS T02(n)
 28:    CROSS APPLY T02.n.nodes(''./*[not(*)]'') AS T03(n)';
 29:
 30: DECLARE @sql nvarchar(max);
 31:
 32: SELECT
 33:    @sql = STRING_AGG(
 34:              CAST(REPLACE(REPLACE(@template, N'{path}', parent_path), N'{name}', parent_name) AS nvarchar(max))
 35:             ,N' UNION ALL ')
 36: FROM
 37:    [stage].[repeated_parent];
 38:
 39: DROP TABLE IF EXISTS [stage].[leaf_pass2];
 40: CREATE TABLE [stage].[leaf_pass2]
 41: (
 42:     config_id     varchar(20)  NOT NULL
 43:    ,config_type   varchar(20)  NOT NULL
 44:    ,path          varchar(400) NOT NULL
 45:    ,value         varchar(200) NULL
 46: );
 47:
 48: INSERT INTO [stage].[leaf_pass2]
 49: EXEC sp_executesql @sql;
 50:
 51: SELECT
 52:     path
 53:    ,COUNT(*) AS n
 54: FROM
 55:    [stage].[leaf_pass2]
 56: WHERE
 57:       path LIKE '%/Name'
 58:    OR path LIKE '%/Felge'
 59: GROUP BY
 60:    path
 61: ORDER BY
 62:    path;
 63: -- /Laufraeder/Laufrad[1]/Felge   3000
 64: -- /Laufraeder/Laufrad[2]/Felge   3000
 65: -- /Zubehoer/Teil[1]/Name         2406
 66: -- /Zubehoer/Teil[2]/Name         1831
 67: -- /Zubehoer/Teil[3]/Name         1243
 68: -- /Zubehoer/Teil[4]/Name          615
Pass 2 läuft über 6095 Teil-Elemente und 6000 Laufrad-Elemente statt über 1,5 Millionen Blätter und dauert unter einer Sekunde. Die Vorlage setzt an jeder Stelle an, die die Erkennung meldet, egal wie tief das wiederholte Element im Fragment liegt. Sie liest darunter aber nur die direkten Blatt-Kinder, so wie Name, Gewicht und Serie direkt unter Teil stehen. Wiederholen sich Blätter direkt innerhalb eines Elternelements, bekommt die Vorlage denselben Ausdruck noch einmal auf Blattebene. Das kostet in der Messung rund 15 statt einer Sekunde, weil die Navigation zum Elternelement von jedem Blatt aus teuer ist, bleibt aber auf die erkannten Stellen beschränkt. Zwei Formen deckt die Vorlage nicht ab. Liegt zwischen dem wiederholten Element und seinen Blättern eine weitere Ebene, etwa Teil/Produkt/Name, dann schreibt die Erkennung die Wiederholung dem Zwischenelement Produkt zu, und Pass 2 vergibt jedem Produkt das Ordinal 1, weil jedes Teil nur ein Produkt hat. Die beiden Namen landen dann auf demselben Pfad /Zubehoer/Teil/Produkt[1]/Name. Dasselbe gilt für Listen in Listen. Beide Fälle brauchen eine weitere CROSS APPLY-Stufe mit demselben Muster, und ob sie vorliegen, verrät die Inventur im nächsten Abschnitt an einer einzigen Kennzahl. Eine dritte Form entgeht schon der Erkennung, denn sie ist eine Heuristik über die Blattnamen: Sie findet eine Liste nur, wenn sich darin mindestens ein Blattname wiederholt. Trägt von zwei Teil-Elementen das eine nur einen Name und das andere nur ein Gewicht, wiederholt sich kein Blattname, und die beiden Teile sehen in der Pfad/Wert-Tabelle wie ein einziges aus. Die Kennzahl der Inventur zeigt diesen Fall nicht an. Verborgen bleibt er allerdings nur, solange keine einzige Konfiguration die Liste gleichförmig führt. Sobald eine das tut, meldet die Erkennung die Stelle, und Pass 2 vergibt die Ordinale in allen Konfigurationen.
Eine Abkürzung sieht verlockend aus und ist keine. ROW_NUMBER() OVER (ORDER BY (SELECT NULL)) über die Ausgabe von nodes() liefert in der Praxis die Dokumentreihenfolge, und in der Messung stimmten die daraus abgeleiteten Ordinale in allen 12 095 Fällen mit der XQuery-Berechnung überein. Die Dokumentation garantiert diese Reihenfolge aber nicht, und die Fensterfunktion zwingt den Optimierer in einen Plan, der die Laufzeit von Pass 1 von rund zwei auf rund 40 Sekunden hebt. Beides zusammen reicht, um die Abkürzung zu lassen.
Zusammenführen
Die Pfad/Wert-Tabelle entsteht aus drei Quellen: Pass 1 ohne die Blätter unter den wiederholten Elternelementen, dazu Pass 2 und die XML-Attribute. Der Pfad wird aus den Namensspalten zusammengesetzt, bis zu dem Namen Konfiguration, der den Anfang markiert. Ein Index auf Typ und Pfad hilft allen Abfragen, die jetzt folgen. Am Ende des Skripts steht ein Abgleich: Die Zahl der Blätter und XML-Attribute in den Fragmenten muss der Zahl der Zeilen in der Pfad/Wert-Tabelle entsprechen. Dieser Abgleich zählt nur. Ob jeder Wert auf dem richtigen Pfad liegt, zeigt er nicht.
  1: -- --------------------------------------------------------------------------------
  2: -- 147006: Zusammenfuehren - die Pfad/Wert-Tabelle (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Pass 1 ohne die Blaetter unter wiederholten Eltern, dazu Pass 2 und die
  5: -- Attribute. Ergebnis: eine Zeile pro Blattwert mit seinem Pfad.
  6: -- Der Abgleich am Ende zaehlt mit XML-Methoden und braucht QUOTED_IDENTIFIER ON.
  7: SET QUOTED_IDENTIFIER ON;
  8: GO
  9: DROP TABLE IF EXISTS [stage].[leaf];
 10: SELECT
 11:     T01.config_id
 12:    ,T01.config_type
 13:    ,CASE WHEN T01.name1 = 'Konfiguration' THEN ''
 14:          WHEN T01.name2 = 'Konfiguration' THEN '/' + T01.name1
 15:          WHEN T01.name3 = 'Konfiguration' THEN '/' + T01.name2 + '/' + T01.name1
 16:          ELSE '/' + T01.name3 + '/' + T01.name2 + '/' + T01.name1 END
 17:     + '/' + T01.name0 AS path
 18:    ,T01.value
 19: INTO [stage].[leaf]
 20: FROM
 21:    [stage].[leaf_raw] T01
 22: WHERE
 23:    NOT EXISTS
 24:    (
 25:       SELECT
 26:          1
 27:       FROM
 28:          [stage].[repeated_parent] T02
 29:       WHERE
 30:              T02.parent_name = T01.name1
 31:          AND T02.parent_path = CASE WHEN T01.name2 = 'Konfiguration' THEN ''
 32:                                     WHEN T01.name3 = 'Konfiguration' THEN '/' + T01.name2
 33:                                     ELSE '/' + T01.name3 + '/' + T01.name2 END
 34:    )
 35: UNION ALL
 36: SELECT
 37:     config_id
 38:    ,config_type
 39:    ,path
 40:    ,value
 41: FROM
 42:    [stage].[leaf_pass2]
 43: UNION ALL
 44: SELECT
 45:     config_id
 46:    ,config_type
 47:    ,CASE WHEN name2 = 'Konfiguration' THEN ''
 48:          WHEN name3 = 'Konfiguration' THEN '/' + name2
 49:          ELSE '/' + name3 + '/' + name2 END
 50:     + '/' + name1 + '/@' + attr_name
 51:    ,value
 52: FROM
 53:    [stage].[leaf_attr];
 54:
 55: CREATE INDEX ix_leaf_type_path ON [stage].[leaf] (config_type, path);
 56:
 57: SELECT
 58:     COUNT(*)                  AS leaves
 59:    ,COUNT(DISTINCT config_id) AS configs
 60:    ,COUNT(DISTINCT path)      AS paths
 61: FROM
 62:    [stage].[leaf];
 63: -- 1522476   3000   1024
 64:
 65: -- --------------------------------------------------------------------------------
 66: -- Abgleich: Blaetter und Attribute in der Quelle gegen die Zeilen der Tabelle
 67: -- --------------------------------------------------------------------------------
 68: -- Die Attribute der Konfiguration selbst (id, typ) zaehlen nicht mit. Stimmt die
 69: -- Summe der ersten beiden Spalten nicht mit der dritten ueberein, ist beim
 70: -- Zusammenfuehren etwas verloren gegangen oder doppelt angekommen.
 71: SELECT
 72:     SUM(T01.node.value('count(/Konfiguration//*[not(*)])', 'int')) AS source_leaves
 73:    ,SUM(T01.node.value('count(/Konfiguration/*//@*)',      'int')) AS source_attributes
 74:    ,(SELECT COUNT(*) FROM [stage].[leaf])                           AS leaf_rows
 75: FROM
 76:    [stage].[config] T01;
 77: -- 1516476   6000   1522476
 78:
 79: SELECT
 80:     path
 81:    ,value
 82: FROM
 83:    [stage].[leaf]
 84: WHERE
 85:        config_id = 'K000001'
 86:    AND path LIKE '/Antrieb%'
 87: ORDER BY
 88:    path;
 89: -- /Antrieb/@art         nabe
 90: -- /Antrieb/Bandbreite   371
 91: -- /Antrieb/Gaenge       14
 92: -- /Antrieb/Nabentyp     N8
 93: -- /Antrieb/Riemen       ja
 94: -- /Antrieb/Ruecktritt   nein
Das Ergebnis sind 1 522 476 Zeilen aus 3000 Konfigurationen mit 1024 verschiedenen Pfaden. Der Abgleich geht auf: 1 516 476 Blätter und 6000 XML-Attribute in der Quelle ergeben dieselbe Zahl. Die Zuordnung von Wert und Pfad wurde für diesen Artikel getrennt geprüft, gegen einen einzelnen Durchlauf, der die Position für jedes der 1,5 Millionen Blätter berechnet. Ein Vergleich mit EXCEPT über Konfiguration, Pfad und Wert ergibt in beiden Richtungen null Abweichungen. Die Ordinale der Teile machen aus drei Pfaden zwölf, die der Laufräder aus vier Pfaden acht, der Rest sind die 1004 Pfade des Katalogs einschließlich der XML-Attribute /Antrieb/@art und /Bremsen/@typ. Für die Konfiguration aus dem Lese-Auszug liefert die Tabelle unter /Antrieb genau die sechs Zeilen, die man erwartet: das XML-Attribut und die fünf Naben-Attribute.
In Summe sieht der XML-Weg in SQL Server so aus. Gemessen wurde die Laufzeit je Skript in einem Docker-Container unter Docker Desktop auf einem aktuellen Desktop-Rechner: Intel Core i7-14700KF mit 28 logischen Kernen, 62 GB RAM und NVMe-SSD unter Ubuntu, davon 28 Kerne und 8 GB für die Docker-VM, der SQL-Server-Container auf 4 GB Speicher begrenzt, SQL Server 2022 Build 16.0.4265.3 ohne weiteres Tuning, im zweiten Lauf im selben Container. Die Zahlen sind Größenordnungen auf diesem einen System, keine Benchmarks. Zur Einordnung: Ein drei Jahre altes Notebook mit Intel Core i7-1165G7 brauchte in einer früheren Messung mit einer kleineren Fassung des Katalogs rund das Dreifache für den ganzen Weg und rund das Zehnfache für die XQuery-Schritte Pass 1 und Pass 2.
| Schritt | Zeit |
|---|---|
Laden als SINGLE_BLOB und Split in 3000 Konfigurationen | 8 s |
| Pass 1: alle Blätter mit Vorfahren-Namen | 1,8 s |
| XML-Attribute | 0,5 s |
| Erkennung wiederholter Elternelemente | 0,7 s |
| Pass 2: Ordinale für die Wiederholungen | 0,9 s |
| Zusammenführen, Index und Abgleich | 2,4 s |
| gesamt | rund 15 s |
Dasselbe mit JSON und OPENJSON
Liegt der Katalog als JSON vor, gibt es den Umweg über Pass 1 und Pass 2 nicht, weil ein Array seine Ordinale mitbringt. Die Datei wird als SINGLE_CLOB geladen und mit STRING_SPLIT an den Zeilenumbrüchen in eine Zeile pro Konfiguration zerlegt. Dass STRING_SPLIT keine Reihenfolge garantiert, spielt hier keine Rolle, weil jede Zeile eine eigenständige Konfiguration ist. Danach öffnet eine rekursive CTE jeden Knoten mit OPENJSON: Der Anker ist das Dokument, der rekursive Teil öffnet alles, was ein Objekt oder ein Array ist, und hängt den Schlüssel beziehungsweise den Index an den Pfad. Was weder Objekt noch Array ist, ist ein Blatt.
  1: -- --------------------------------------------------------------------------------
  2: -- 147007: Derselbe Katalog als JSON Lines - rekursiv mit OPENJSON (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Eine Zeile pro Konfiguration; Attribute tragen die xmltodict-Konvention (@art),
  5: -- wiederholte Elemente sind Arrays. Array-Indizes werden wie bei XML ab 1 gezaehlt.
  6: DROP TABLE IF EXISTS [stage].[raw_json];
  7: SELECT
  8:    CAST(T02.value AS nvarchar(max)) AS doc
  9: INTO [stage].[raw_json]
 10: FROM
 11:    OPENROWSET(BULK '/tmp/configs.jsonl', SINGLE_CLOB) AS T01
 12:    CROSS APPLY STRING_SPLIT(CAST(T01.BulkColumn AS nvarchar(max)), CHAR(10)) AS T02
 13: WHERE
 14:    LEN(T02.value) > 2;
 15:
 16: -- --------------------------------------------------------------------------------
 17: -- Rekursiv oeffnen: Objekte (type 5) und Arrays (type 4) werden weiter zerlegt,
 18: -- alles andere ist ein Blatt. OPENJSON liefert key/value in Latin1_General_BIN2,
 19: -- deshalb COLLATE DATABASE_DEFAULT auf beiden Seiten der Rekursion.
 20: -- --------------------------------------------------------------------------------
 21: DROP TABLE IF EXISTS [stage].[leaf_json];
 22: WITH
 23: CTE_node AS
 24: (
 25:    SELECT
 26:        CAST(JSON_VALUE(doc, '$."@id"')  AS nvarchar(20))  COLLATE DATABASE_DEFAULT AS config_id
 27:       ,CAST(JSON_VALUE(doc, '$."@typ"') AS nvarchar(20))  COLLATE DATABASE_DEFAULT AS config_type
 28:       ,CAST(doc AS nvarchar(max))                         COLLATE DATABASE_DEFAULT AS node
 29:       ,CAST(N'' AS nvarchar(400))                         COLLATE DATABASE_DEFAULT AS path
 30:       ,CAST(5 AS int)                                                              AS json_type
 31:    FROM
 32:       [stage].[raw_json]
 33:    UNION ALL
 34:    SELECT
 35:        CAST(T01.config_id   AS nvarchar(20))  COLLATE DATABASE_DEFAULT
 36:       ,CAST(T01.config_type AS nvarchar(20))  COLLATE DATABASE_DEFAULT
 37:       ,CAST(T02.value       AS nvarchar(max)) COLLATE DATABASE_DEFAULT
 38:       ,CAST(T01.path
 39:             + CASE WHEN T01.json_type = 4
 40:                    THEN N'[' + CAST(CAST(T02.[key] AS int) + 1 AS nvarchar(10)) + N']'
 41:                    ELSE N'/' + T02.[key] END
 42:             AS nvarchar(400)) COLLATE DATABASE_DEFAULT
 43:       ,CAST(T02.type AS int)
 44:    FROM
 45:       CTE_node T01
 46:       CROSS APPLY OPENJSON(CASE WHEN T01.json_type IN (4, 5) THEN T01.node ELSE N'[]' END) AS T02
 47:    WHERE
 48:       T01.json_type IN (4, 5)
 49: )
 50: SELECT
 51:     config_id
 52:    ,config_type
 53:    ,CAST(path AS varchar(400)) AS path
 54:    ,CAST(node AS varchar(200)) AS value
 55: INTO [stage].[leaf_json]
 56: FROM
 57:    CTE_node
 58: WHERE
 59:    json_type NOT IN (4, 5);
 60:
 61: SELECT
 62:     COUNT(*)             AS leaves
 63:    ,COUNT(DISTINCT path) AS paths
 64: FROM
 65:    [stage].[leaf_json];
 66: -- 1528476   1026
Zwei Details machen den Unterschied zwischen einer Abfrage, die läuft, und einer, die nicht einmal kompiliert. Erstens liefert OPENJSON die Spalten key und value in der Sortierung Latin1_General_BIN2, während die Spalten des Ankers die Sortierung der Datenbank tragen. In einer rekursiven CTE müssen Anker und rekursiver Teil typgleich sein, Sortierung eingeschlossen, sonst meldet SQL Server „Types don’t match between the anchor and the recursive part“. Das COLLATE DATABASE_DEFAULT auf beiden Seiten ist deshalb Pflicht. Zweitens zählt OPENJSON Array-Indizes ab null, XML-Ordinale zählen ab eins. Das + 1 im Pfad gleicht das an, damit beide Wege dieselben Pfade liefern.
Der JSON-Weg braucht für Laden und Rekursion zusammen rund 25 Sekunden. Er liefert 1 528 476 Zeilen mit 1026 Pfaden, also 6000 Zeilen und zwei Pfade mehr als der XML-Weg. Der Unterschied sind @id und @typ, die JSON als eigene Pfade führt, während sie im XML-Weg Spalten sind. Alle 1 522 476 Zeilen des XML-Wegs finden sich mit Konfiguration, Pfad und Wert im JSON-Ergebnis wieder, die Ordinale der Listen eingeschlossen. Der Code ist mit einem Skript deutlich kürzer als die fünf Skripte des XML-Wegs von Pass 1 bis zum Zusammenführen, die Laufzeit liegt mit rund 25 Sekunden aber über den rund 15 Sekunden des XML-Wegs. Wer die Wahl hat, weil der Katalog ohnehin konvertiert wird, kann sich das XML-Shredden sparen. Wie die Konvertierung in Python aussieht, zeigt der Zwilling zu diesem Artikel, der in Kürze folgt.
Inventur: das Schema aus den Daten ablesen
Mit der Pfad/Wert-Tabelle ist die eigentliche Frage des Projekts eine Gruppierung: Welcher Typ trägt welche Pfade, und wie oft? Pro Typ und Pfad werden die Werte gezählt und die Konfigurationen, in denen der Pfad vorkommt. Der Anteil an allen Konfigurationen des Typs sagt dann, womit man es zu tun hat.
  1: -- --------------------------------------------------------------------------------
  2: -- 147009: Inventur - welcher Typ traegt welche Pfade wie oft (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: DROP TABLE IF EXISTS [stage].[inventory];
  5: WITH
  6: CTE_configs AS
  7: (
  8:    SELECT
  9:        config_type
 10:       ,COUNT(DISTINCT config_id) AS configs
 11:    FROM
 12:       [stage].[leaf]
 13:    GROUP BY
 14:       config_type
 15: )
 16: SELECT
 17:     T01.config_type
 18:    ,T01.path
 19:    ,COUNT(*)                                                                         AS n_values
 20:    ,COUNT(DISTINCT T01.config_id)                                                    AS n_configs
 21:    ,CAST(100.0 * COUNT(DISTINCT T01.config_id) / MAX(T02.configs) AS decimal(5, 1)) AS share_pct
 22: INTO [stage].[inventory]
 23: FROM
 24:    [stage].[leaf] T01
 25:    INNER JOIN CTE_configs T02
 26:    ON
 27:      T02.config_type = T01.config_type
 28: GROUP BY
 29:     T01.config_type
 30:    ,T01.path;
 31:
 32: -- --------------------------------------------------------------------------------
 33: -- Pflicht oder optional: Ab einem Anteil von 99 Prozent gilt ein Pfad als Pflicht
 34: -- des Typs, alles darunter ist optional oder gehoert zu einer Variante.
 35: -- Die Schwelle liegt bewusst nicht bei 100 Prozent. In echten Daten fehlt ein
 36: -- Pflichtwert in einzelnen Konfigurationen, und der Pfad soll dann Pflicht bleiben,
 37: -- damit genau diese Luecken auffallen. Wer streng zaehlen will, setzt 100.0 ein.
 38: -- --------------------------------------------------------------------------------
 39: SELECT
 40:     config_type
 41:    ,COUNT(*)                                           AS paths
 42:    ,SUM(CASE WHEN share_pct >= 99.0 THEN 1 ELSE 0 END) AS required_paths
 43:    ,SUM(CASE WHEN share_pct <  99.0 THEN 1 ELSE 0 END) AS optional_paths
 44: FROM
 45:    [stage].[inventory]
 46: GROUP BY
 47:    config_type
 48: ORDER BY
 49:    config_type;
 50: -- lastenrad     640   34   606
 51: -- rennrad       634   29   605
 52: -- trekkingrad   640   29   611
 53:
 54: SELECT
 55:     path
 56:    ,n_configs
 57:    ,share_pct
 58: FROM
 59:    [stage].[inventory]
 60: WHERE
 61:        config_type = 'trekkingrad'
 62:    AND path LIKE '/Antrieb/%'
 63: ORDER BY
 64:    path;
 65: -- /Antrieb/@art               980   100.0
 66: -- /Antrieb/Bandbreite         367    37.4
 67: -- /Antrieb/Gaenge             367    37.4
 68: -- /Antrieb/Kettenblaetter     613    62.6
 69: -- /Antrieb/Kettenlinie        613    62.6
 70: -- /Antrieb/Nabentyp           367    37.4
 71: -- /Antrieb/Riemen             367    37.4
 72: -- /Antrieb/Ritzel             613    62.6
 73: -- /Antrieb/Ruecktritt         367    37.4
 74: -- /Antrieb/Schaltwerk         613    62.6
 75: -- /Antrieb/Uebersetzung_max   613    62.6
 76: -- /Antrieb/Uebersetzung_min   613    62.6
 77: -- /Antrieb/Umwerfer           613    62.6
Ein Pfad mit einem Anteil nahe hundert Prozent ist ein Pflichtattribut des Typs. Die Abfrage zieht die Grenze bei 99 Prozent und nicht bei 100, damit ein Pflichtattribut, das in einzelnen Konfigurationen fehlt, Pflicht bleibt und genau diese Lücken auffallen. Die Einstufung ist ein Befund aus den Daten und keine Schema-Aussage. Ob ein Attribut fachlich Pflicht ist, entscheidet die Fachseite, und ein Element, das vorhanden, aber leer ist, zählt hier als vorhanden. Ein Pfad mit kleinem Anteil ist optional. Und ein Pfad, der in einem festen Bruchteil der Konfigurationen vorkommt, gehört zu einer Variante. Der Antrieb des Trekkingrads zeigt das ohne jedes Vorwissen: /Antrieb/@art steht in allen 980 Konfigurationen, die Ketten-Attribute stehen in 62,6 Prozent davon, die Naben-Attribute in den übrigen 37,4 Prozent. Die beiden Varianten des Antriebs sind aus der Zählung ablesbar, und ebenso, dass sie sich gegenseitig ausschließen. Die Inventur dauert unter einer halben Sekunde.
Dieselbe Zählung ist nebenbei ein Datenqualitätswerkzeug. Ein Pfad, der nur in drei von tausend Konfigurationen vorkommt, ist entweder ein seltenes Extra oder ein Tippfehler im Elementnamen. Ein Pflichtattribut mit 99,8 Prozent hat zwei Konfigurationen, bei denen es fehlt. Und ein Pfad, der mehr Werte als Konfigurationen zählt, ist entweder eine Wiederholung, die Pass 2 nicht aufgelöst hat, oder ein Paar von Elementnamen in derselben Konfiguration, die sich nur in der Groß- und Kleinschreibung unterscheiden und unter der Standard-Sortierung der Datenbank zusammenfallen. Diese Kennzahl, n_values größer als n_configs, ist eine Plausibilitätsprüfung auf Pfade, die innerhalb einer Konfiguration mehrfach belegt sind. Im Katalog trifft sie auf keinen Pfad zu. Ob die Zerlegung vollständig war, beantwortet sie nicht, dafür ist der Abgleich der Zeilenzahlen am Ende des Zusammenführens da. Wer Prüfregeln aus solchen Metadaten ableiten will, findet den Gedanken in Prüfregeln aus dem Schema ableiten weitergeführt, dort für relationale Schemata.
Views generieren statt schreiben
Niemand schreibt von Hand eine View mit sechshundert Spalten, und niemand sollte das müssen. Die Inventur kennt pro Typ jeden Pfad, und aus jedem Pfad wird eine Spalte: MAX(CASE WHEN path = '…' THEN value END) gruppiert nach Konfiguration. STRING_AGG setzt die Spaltenliste zusammen, QUOTENAME macht aus dem Pfad einen gültigen Spaltennamen und aus dem Typ einen gültigen View-Namen, und sp_executesql führt die DDL aus. Weil Pfade und Typ aus den Daten kommen, laufen sie als Bezeichner durch QUOTENAME und als Literal durch ein REPLACE, das Hochkommas verdoppelt. Bei XML-Namen ist das nur Vorsicht, weil sie keine Hochkommas enthalten können, bei Schlüsseln aus JSON ist es nötig. Listen-Pfade mit Ordinal bleiben außen vor. Sie bekommen eigene Views mit einer Zeile pro Listenelement, sonst entstünden Spalten wie zubehoer_teil_3_name, die bei vier Teilen leer bleiben.
  1: -- --------------------------------------------------------------------------------
  2: -- 147010: Views aus der Inventur generieren statt schreiben (SQL Server)
  3: -- --------------------------------------------------------------------------------
  4: -- Pro Objekttyp eine View mit einer Spalte je Pfad. Listen-Pfade (mit [n]) bleiben
  5: -- aussen vor; sie bekommen eigene Views mit einer Zeile pro Listenelement.
  6: -- Das Skript ist je Objekttyp einmal auszufuehren: zuerst wie es hier steht mit
  7: -- 'trekkingrad', danach mit 'rennrad' und mit 'lastenrad' in @config_type. Jeder
  8: -- Lauf erzeugt die View des Typs (vw_trekkingrad, vw_rennrad, vw_lastenrad).
  9: -- CREATE VIEW muss allein im Stapel stehen, deshalb laeuft die DDL ueber
 10: -- sp_executesql. Die typisierte View und die Beispielabfrage am Ende gehoeren zum
 11: -- Trekkingrad und setzen voraus, dass dessen Lauf der erste war.
 12: -- Bezeichner laufen durch QUOTENAME, Literale durch REPLACE('''') - Pfade aus JSON
 13: -- koennen anders als XML-Namen Hochkommas enthalten.
 14: DECLARE @config_type varchar(20) = 'trekkingrad';   -- danach 'rennrad', dann 'lastenrad'
 15: DECLARE @sql         nvarchar(max);
 16:
 17: SELECT
 18:    @sql = N'CREATE OR ALTER VIEW [dbo].' + QUOTENAME(N'vw_' + @config_type) + N' AS'
 19:         + N' SELECT config_id'
 20:         + STRING_AGG(
 21:              CAST(N', MAX(CASE WHEN path = ''' + REPLACE(path, '''', '''''') + N''' THEN value END) AS '
 22:                   + QUOTENAME(LOWER(REPLACE(REPLACE(SUBSTRING(path, 2, 400), '/', '_'), '@', 'attr_')))
 23:                   AS nvarchar(max))
 24:             ,N'') WITHIN GROUP (ORDER BY path)
 25:         + N' FROM [stage].[leaf] WHERE config_type = ''' + REPLACE(@config_type, '''', '''''') + N''' GROUP BY config_id;'
 26: FROM
 27:    [stage].[inventory]
 28: WHERE
 29:        config_type = @config_type
 30:    AND path NOT LIKE '%[[]%';
 31:
 32: EXEC sp_executesql @sql;
 33:
 34: SELECT
 35:    COUNT(*) AS columns_generated
 36: FROM
 37:    INFORMATION_SCHEMA.COLUMNS
 38: WHERE
 39:    TABLE_NAME = 'vw_' + @config_type;
 40: -- XML-Weg:   trekkingrad 621, rennrad 615, lastenrad 621
 41: -- JSON-Weg:  trekkingrad 623, rennrad 617, lastenrad 623
 42: GO
 43: -- --------------------------------------------------------------------------------
 44: -- Zweite Schicht: Typisierung dort, wo sie gebraucht wird. Alle Werte der
 45: -- generierten View sind Text; erst hier bekommen Preis, Gewicht und Lumen Typen.
 46: -- --------------------------------------------------------------------------------
 47: CREATE OR ALTER VIEW [dbo].[vw_trekkingrad_typed]
 48: AS
 49: SELECT
 50:     config_id
 51:    ,stammdaten_modell                                        AS modell
 52:    ,TRY_CONVERT(smallint,       stammdaten_modelljahr)       AS modelljahr
 53:    ,TRY_CONVERT(decimal(10, 2), stammdaten_preis)            AS preis
 54:    ,TRY_CONVERT(decimal(6, 2),  stammdaten_gewicht)          AS gewicht_kg
 55:    ,rahmen_material                                          AS rahmen_material
 56:    ,antrieb_attr_art                                         AS antrieb_art
 57:    ,TRY_CONVERT(tinyint,        antrieb_gaenge)              AS gaenge
 58:    ,TRY_CONVERT(smallint,       licht_vorn_lumen)            AS licht_vorn_lumen
 59: FROM
 60:    [dbo].[vw_trekkingrad];
 61: GO
 62: SELECT
 63:     rahmen_material
 64:    ,COUNT(*)                        AS n
 65:    ,CAST(AVG(preis) AS decimal(10, 0)) AS preis_avg
 66: FROM
 67:    [dbo].[vw_trekkingrad_typed]
 68: GROUP BY
 69:    rahmen_material
 70: ORDER BY
 71:    rahmen_material;
 72: -- Aluminium   246   3178
 73: -- Carbon      246   3443
 74: -- Stahl       248   3426
 75: -- Titan       240   3116
Die View für das Trekkingrad hat 621 Spalten und entsteht in unter einer halben Sekunde. Das Skript erzeugt je Lauf die View eines Typs. Für Rennrad und Lastenrad läuft es noch einmal mit dem jeweiligen Typ in @config_type und liefert Views mit 615 und 621 Spalten. Eine Abfrage darüber, etwa der Durchschnittspreis je Rahmenmaterial über 980 Konfigurationen, läuft in rund 40 Millisekunden. Das ist der Moment, in dem sich der Ansatz auszahlt: Ein neues Attribut im Katalog verlangt keine Änderung an Zerlegung, Inventur und View-Generator. Es ist eine neue Zeile in der Inventur und beim nächsten Lauf eine neue Spalte in der View. Handarbeit bleibt nur die typisierte View, falls das Attribut dort einen Typ bekommen soll.
Alle Werte der generierten View sind Text, so wie sie im XML standen. Typen bekommen sie in einer zweiten Schicht, und zwar nur die Spalten, die jemand typisiert braucht. Dafür ist TRY_CONVERT das richtige Werkzeug, weil ein einzelner fehlerhafter Wert nicht die ganze View zum Abbruch bringen darf. Was dabei je Datentyp zu beachten ist, behandelt Sichere Typ-Konvertierung mit T-SQL.
Drei Grenzen gehören dazu. Ein Spaltenname ist ein Bezeichner mit höchstens 128 Zeichen. Für längere Eingaben liefert QUOTENAME ein NULL, und weil STRING_AGG NULL-Werte überspringt, verschwindet die Spalte still aus der View. Die Zählung der Spalten am Ende des Skripts ist deshalb mehr als eine Kontrollausgabe: 620 Pfade ohne Ordinal plus config_id müssen 621 Spalten ergeben. Außerdem ist die Abbildung des Pfads auf den Spaltennamen nicht eindeutig. Aus /A/B und /A_B wird beides Mal a_b, und die View schlägt mit der Meldung fehl, dass Spaltennamen eindeutig sein müssen. Dasselbe passiert mit /A/@b und /A/attr_b, aus denen beides Mal a_attr_b wird, und mit Gaenge und gaenge, sobald die Pfadspalte eine binäre Sortierung trägt und die beiden Schreibweisen als getrennte Pfade in der Inventur stehen. Wer solche Namen hat, hängt eine laufende Nummer aus der Inventur an. SQL Server erlaubt 1024 Spalten je View, Postgres 1600, wobei in Postgres bei einer materialisierten Tabelle zusätzlich die Zeile in einen 8-KB-Block passen muss. Bei tausend Attributen und einer View pro Typ geht das noch auf, bei zweitausend nicht mehr. Dann wird pro Baugruppe generiert statt pro Typ, also eine View für den Rahmen, eine für den Antrieb, und die Abnehmer verbinden über die Konfigurations-ID. Und die Pfad/Wert-Tabelle selbst ist ein Zwischenformat, kein Zielmodell. Sie hat keine Typen, keine Constraints, und jede Abfrage muss erst pivotieren. Wer sie als Datenmodell für Anwendungen nutzt, baut sich das Entity-Attribute-Value-Muster mit all seinen bekannten Nachteilen. Als Landezone für ein Dokument mit unbekanntem Schema ist sie genau richtig, und die generierten Views sind die Schicht, die die Abnehmer sehen. Wird eine View häufig abgefragt, lässt sie sich als Tabelle materialisieren.
Postgres-Brücke
Derselbe Weg führt in Postgres über JSONB, und dort ist er sogar der schnellste. COPY lädt die JSON-Lines-Datei als eine Zeile pro Konfiguration, wobei der CSV-Modus mit unmöglichen Trenn- und Quote-Zeichen dafür sorgt, dass Backslashes im Text nicht als Escapes gelesen werden. Die rekursive CTE öffnet Objekte mit jsonb_each und Arrays mit jsonb_array_elements samt Ordinal, und beides passiert in einem Lateral Join, so dass eine Rekursion für beide Fälle reicht.
  1: -- --------------------------------------------------------------------------------
  2: -- JSON Lines laden: eine Zeile pro Konfiguration. Der CSV-Modus mit unmoeglichen
  3: -- Quote-/Trennzeichen verhindert, dass Backslashes im Text als Escapes gelten.
  4: -- --------------------------------------------------------------------------------
  5: DROP TABLE IF EXISTS stage.raw_json;
  6: CREATE TABLE stage.raw_json
  7: (
  8:     doc   jsonb NOT NULL
  9: );
 10: COPY stage.raw_json FROM '/tmp/configs.jsonl' WITH (FORMAT csv, QUOTE E'\x01', DELIMITER E'\x02');
 11:
 12: -- --------------------------------------------------------------------------------
 13: -- Rekursiv flachklopfen: Objekte per jsonb_each, Arrays per jsonb_array_elements
 14: -- mit Ordinal; alles, was weder Objekt noch Array ist, ist ein Blatt.
 15: -- --------------------------------------------------------------------------------
 16: DROP TABLE IF EXISTS stage.leaf_json CASCADE;   -- CASCADE: die Views eines frueheren Laufs haengen daran
 17: CREATE TABLE stage.leaf_json AS
 18: WITH RECURSIVE
 19: CTE_node AS
 20: (
 21:    SELECT
 22:        doc ->> '@id'  AS config_id
 23:       ,doc ->> '@typ' AS config_type
 24:       ,doc            AS node
 25:       ,''::text       AS path
 26:    FROM
 27:       stage.raw_json
 28:    UNION ALL
 29:    SELECT
 30:        T01.config_id
 31:       ,T01.config_type
 32:       ,T02.node
 33:       ,T01.path || T02.step
 34:    FROM
 35:       CTE_node T01
 36:       CROSS JOIN LATERAL
 37:       (
 38:          SELECT
 39:              '/' || key AS step
 40:             ,value      AS node
 41:          FROM
 42:             jsonb_each(CASE WHEN jsonb_typeof(T01.node) = 'object' THEN T01.node ELSE '{}'::jsonb END)
 43:          UNION ALL
 44:          SELECT
 45:              '[' || ordinality || ']'
 46:             ,value
 47:          FROM
 48:             jsonb_array_elements(CASE WHEN jsonb_typeof(T01.node) = 'array' THEN T01.node ELSE '[]'::jsonb END) WITH ORDINALITY
 49:       ) T02
 50: )
 51: SELECT
 52:     config_id
 53:    ,config_type
 54:    ,path
 55:    ,node #>> '{}' AS value
 56: FROM
 57:    CTE_node
 58: WHERE
 59:    jsonb_typeof(node) NOT IN ('object', 'array');
Das Laden dauert unter einer halben Sekunde, die Rekursion knapp vier, das Ergebnis ist zeilengleich mit dem OPENJSON-Weg: 1 528 476 Zeilen, 1026 Pfade. Mehr zu COPY und seinen Varianten steht in Daten transferieren.
XML direkt geht in Postgres ebenfalls, mit xmltable statt nodes(), und mit einer Falle, die größer ist als alles in SQL Server. Die Funktion xmltable über das ganze 27-MB-Dokument mit dem Zeilenpfad /Katalog/Konfiguration//*[not(*)] lief in der Messung mit Postgres 18.6 nach 36 Minuten noch. Sie reagierte weder auf pg_cancel_backend noch auf pg_terminate_backend und endete erst mit dem Container. Ein Ausreißer war das nicht, wie eine Nachmessung mit Teilkatalogen zeigt: Für 50, 100 und 200 Konfigurationen braucht dieselbe Abfrage 4, 17 und 99 Sekunden, je Verdopplung also gut das Fünffache, und für 3000 Konfigurationen wären das Stunden. Die naheliegende Erklärung ist ein Aufruf der XML-Bibliothek libxml2, der keine Unterbrechung prüft. Belegt ist in der Messung nur das Verhalten, nicht die Ursache. Nach dem Split in eine Zeile pro Konfiguration läuft dieselbe xmltable als Lateral Join über die Fragmente in rund vier Sekunden, und zwar auch dann, wenn sie die Positionen gleich mitberechnet, weil count(preceding-sibling::*) auf einem 9-KB-Fragment billig ist. Die Ordinale nur für wiederholte Geschwister entstehen dann set-basiert mit dense_rank() über Konfiguration, Elternpfad und Name. Das Skript dazu liegt im XML-Download für Postgres. Views erzeugt Postgres aus den Pfaden mit format() und führt die DDL mit \gexec aus, drei Views mit je rund 620 Spalten, jede in rund zehn Millisekunden.
  1: -- --------------------------------------------------------------------------------
  2: -- Views aus den Pfaden generieren: format() baut die DDL, \gexec fuehrt sie aus.
  3: -- Listen-Pfade (mit [n]) und die beiden Attribute der Konfiguration bleiben aussen vor.
  4: -- --------------------------------------------------------------------------------
  5: SELECT format(
  6:           'CREATE OR REPLACE VIEW stage.vw_%s AS SELECT config_id%s FROM stage.leaf_json WHERE config_type = %L GROUP BY config_id;'
  7:          ,config_type
  8:          ,string_agg(
  9:              format(E'\n   ,max(value) FILTER (WHERE path = %L) AS %I'
 10:                    ,path
 11:                    ,regexp_replace(lower(trim(both '/' from path)), '[^a-z0-9]+', '_', 'g'))
 12:             ,'' ORDER BY path)
 13:          ,config_type)
 14: FROM
 15:    (SELECT DISTINCT config_type, path FROM stage.leaf_json WHERE path NOT LIKE '/@%' AND path NOT LIKE '%[%') T01
 16: GROUP BY
 17:    config_type \gexec
 18:
 19: SELECT
 20:     table_name
 21:    ,count(*) AS columns_generated
 22: FROM
 23:    information_schema.columns
 24: WHERE
 25:    table_name LIKE 'vw\_%'
 26: GROUP BY
 27:    table_name
 28: ORDER BY
 29:    table_name;
 30: -- vw_lastenrad     621
 31: -- vw_rennrad       615
 32: -- vw_trekkingrad   621
Grenzen und Entscheidungen
Das Verfahren hat einen festen Rahmen, und der sollte vor dem Einsatz bekannt sein.
- Tiefe: Die Vorfahren-Namen sind Spalten, ihre Zahl ist fest. Vier Ebenen decken den Katalog ab, ein Dokument mit zehn Ebenen braucht zehn Spalten oder einen anderen Pfadaufbau, und die Kontrolle aus Pass 1 zeigt, ob die Reserve reicht. Die rekursive CTE des JSON-Wegs kennt diese Grenze nicht, in SQL Server aber eine andere: Nach 100 Rekursionsstufen bricht sie mit einem Fehler ab, bis
OPTION (MAXRECURSION 0)die Grenze aufhebt. Postgres rekursiert ohne Limit. - Namespaces:
local-name()ignoriert Namespaces, was hier gewollt ist. Zwei Elemente mit demselben lokalen Namen aus verschiedenen Namespaces fallen damit auf einen Pfad. Wer sie unterscheiden muss, nimmtnamespace-uri()als weitere Spalte dazu. Einname()mit Präfix gibt es in SQL Servers XQuery nicht, und das Präfix wäre ohnehin nur eine Schreibweise für die URI. Um im Pfad gezielt einen Namespace anzusprechen, dientWITH XMLNAMESPACES. - Schreibweise und Sortierung: XML-Namen unterscheiden Groß- und Kleinschreibung, die Textspalten der Datenbank mit der Standard-Sortierung
SQL_Latin1_General_CP1_CI_ASnicht. Zwei ElementeGaengeundgaengefallen damit in der Inventur auf einen Pfad zusammen, und die Erkennung der Wiederholungen meldet ihr Elternelement fälschlich als wiederholt. Wer solche Namen hat, legt die Namens- und Pfadspalten mit einer binären Sortierung wieLatin1_General_100_BIN2an. Stehen beide Schreibweisen in derselben Konfiguration, zeigt die Inventur den Fall an derselben Kennzahl wie ein fehlendes Ordinal: mehr Werte als Konfigurationen. Verteilen sie sich auf verschiedene Konfigurationen, bleibt die Kennzahl still, und der Fall zeigt sich erst, wenn die Pfade unter einer binären Sortierung gezählt werden. - Spaltenbreiten und Zeichensatz: Namen mit
varchar(100), Werte mitvarchar(200)und Pfade mitvarchar(400)sind auf den Katalog zugeschnitten, dessen längster Pfad 32 und dessen längster Wert 19 Zeichen hat. Längere Zeichenketten schneidetvalue()still auf die Zielbreite ab, ohne Fehler und ohne Warnung. Ebenso still gehen Zeichen verloren, die die Codepage vonvarcharnicht kennt: AusŁódźwirdLódz. Wer solche Werte erwartet, nimmtnvarchar. Für fremde Dokumente werden die Breiten an die Daten angepasst, ein erster Durchlauf mit breiten Spalten undMAX(LEN(…))zeigt, was nötig ist. Pauschalvarchar(max)ist für den Pfad keine Option: Er ist Schlüssel des Index auf der Pfad/Wert-Tabelle, und einmax-Typ kann kein Indexschlüssel sein. - Gemischter Inhalt: Text neben Kind-Elementen fällt durch
[not(*)]heraus. Solche Dokumente brauchen einen zusätzlichen Durchlauf übertext()-Knoten. - Elemente nur mit XML-Attributen: Ein Element wie
<Garantie jahre="2"/>hat weder Text noch Kinder. Pass 1 trifft es trotzdem und liefert eine Zeile mit leerem Wert, weil[not(*)]nur nach Kind-Elementen fragt. Das XML-Attribut sammelt der eigene Durchlauf als/Stammdaten/Garantie/@jahrekorrekt ein. Die leere Zeile fällt weg, wenn das Prädikat um[not(@*) or text()]erweitert wird: Blätter ohne XML-Attribute bleiben auch leer erhalten, Blätter mit XML-Attributen nur dann, wenn sie Text haben. Ein reines[text()]würde dagegen auch absichtlich leere Elemente wie<Riemen/>verwerfen. Wer dafür zunormalize-space()greift, bekommt einen Fehler, die Funktion fehlt in SQL Servers XQuery. - Typen und Lokalisierung: Alle Werte sind Text. Dezimalpunkt oder Komma, Datumsformate und Ja/Nein-Schreibweisen werden erst in der typisierten View entschieden, und dort mit
TRY_CONVERT, nicht mitCONVERT. - Dateigröße: Ein
xml-Wert fasst bis zu 2 GB, undSINGLE_BLOBliest die ganze Datei auf einmal. Bei Dokumenten im Gigabyte-Bereich ist der Split der Engpass, und ab einer gewissen Größe ist ein Streaming-Parser außerhalb der Datenbank die bessere Wahl. Das ist das Thema des Zwillingsartikels zu Python. - Bekanntes, kleines Schema: Wer zwanzig Attribute hat und sie kennt, braucht das alles nicht. Ein
nodes()mit zwanzigvalue()-Spalten ist dann kürzer und schneller. Der generische Weg lohnt sich, wenn das Schema groß, variabel oder unbekannt ist.
Als Entscheidungshilfe:
| Ausgangslage | Empfohlener Weg |
|---|---|
| XML, Schema groß oder unbekannt, Datei passt in den Speicher | Split, Pass 1, Erkennung, Pass 2, Inventur, generierte Views |
| JSON, Schema groß oder unbekannt | Eine Zeile pro Dokument, rekursive CTE mit OPENJSON oder JSONB, Inventur, generierte Views |
| XML, aber Konvertierung nach JSON ohnehin geplant | Konvertieren, dann der JSON-Weg |
| Schema klein und bekannt | nodes() mit festen value()-Spalten, keine Pfad/Wert-Tabelle |
| Datei im Gigabyte-Bereich | Streaming-Parser außerhalb der Datenbank, Laden als JSON Lines, Rest in SQL |
Zusammenfassung
- Die Stunden im damaligen Projekt kamen nicht aus der Programmiersprache, sondern aus dem Zuschnitt: Code pro Typ, Zugriff pro Attribut, Schema im Kopf.
- Der Datenbank-Weg kennt die Attribute nicht vorher. Er lädt roh, zerlegt generisch in Pfad und Wert, und zählt danach, was es gibt. Was er voraussetzt, sind das Element der Teildokumente, eine Obergrenze für die Tiefe und Listen, in denen sich in mindestens einer Konfiguration ein Elementname wiederholt.
- In SQL Server ist der Split in eine Zeile pro Konfiguration der entscheidende Schritt, danach liefert ein Durchlauf über
nodes()mit der Parent-Achse alle Blätter in rund zwei Sekunden. - Positionen für alle 1,5 Millionen Blätter zu berechnen hebt die Laufzeit von rund zwei auf rund 40 Sekunden. Berechnet werden sie deshalb nur für die Elemente, die sich laut Pass 1 wiederholen.
- Die Inventur macht Pflicht-, optionale und Varianten-Attribute je Typ sichtbar, und aus ihr generiert die Datenbank die Views mit hunderten Spalten selbst.
- JSON kommt ohne den zweiten Pass aus, in Postgres ist JSONB der schnellste Weg, und
xmltableüber ein ganzes großes Dokument ist dort eine Falle. - Die Pfad/Wert-Tabelle ist eine Landezone, kein Datenmodell. Die generierten und typisierten Views sind die Schicht für die Abnehmer.
FAQ
Das Dokument als xml-Wert laden, mit nodes() in eine Zeile pro Teildokument splitten und dann mit nodes('//*[not(*)]') jedes Blatt-Element holen. Die Parent-Achse local-name(..) liefert die Namen der Vorfahren, daraus entsteht der Pfad, und value('.') liefert den Wert. Das Ergebnis ist eine Pfad/Wert-Tabelle, aus der eine Gruppierung das Schema ablesbar macht. Vorausgesetzt werden das Element der Teildokumente und eine Obergrenze für die Tiefe des Baums. Listen erkennt das Verfahren nur, wenn sich darin in mindestens einer Konfiguration ein Elementname wiederholt.
Der XQuery-Ausdruck let $p := . return count(../*[local-name() = "Teil"][. << $p]) + 1 zählt die gleichnamigen Geschwister, die im Dokument vor dem aktuellen Element stehen, und liefert so dessen Position. Für alle 1,5 Millionen Blätter ist dieser Ausdruck zu teuer, er hebt die Laufzeit von rund zwei auf rund 40 Sekunden. Deshalb holt Pass 1 alle Blätter ohne Position, eine Gruppierung liest daraus ab, an welchen Stellen sich Elemente überhaupt wiederholen, und Pass 2 berechnet die Position nur dort. Ein ROW_NUMBER() über die Ausgabe von nodes() sieht einfacher aus, garantiert die Dokumentreihenfolge aber nicht.
Ja, in der Form. Nein, in der Rolle. Das Entity-Attribute-Value-Muster ist dann ein Problem, wenn es das dauerhafte Datenmodell einer Anwendung ist, weil Typen, Constraints und einfache Abfragen fehlen. Hier ist die Tabelle eine Zwischenstufe zwischen dem rohen Dokument und den generierten Views. Sie wird einmal pro Ladelauf gefüllt, einmal gezählt, und die Abnehmer sehen Views mit echten Spalten. Wer die Views häufig abfragt, materialisiert sie und ist damit wieder bei einem normalen Tabellenmodell.
JSON, wenn die Ordinale von Listen wichtig sind und die Konvertierung ohnehin stattfindet. Ein Array bringt seine Reihenfolge mit, und die rekursive CTE braucht keinen zweiten Pass. XML direkt, wenn die Datei so ankommt und nicht noch einmal angefasst werden soll. In SQL Server brauchte der XML-Weg rund 15 und der JSON-Weg rund 25 Sekunden für 1,5 Millionen Werte, in Postgres war JSONB mit rund vier Sekunden klar vorn.
OPENXML liefert mit sp_xml_preparedocument eine Kantentabelle des ganzen Dokuments, in der jeder Knoten eine Zeile mit Kennung und Elternkennung ist, in Dokumentreihenfolge. Das klingt nach genau dem generischen Zugriff, den dieser Artikel sucht. In der Messung brauchte allein die Kantentabelle für 3 Millionen Knoten rund 55 Sekunden, die Textspalte kommt als ntext und lässt sich nicht indizieren, und das vorbereitete Dokument belegt Arbeitsspeicher, bis es explizit freigegeben wird. Der Weg über nodes() war in dieser Messung rund dreißigmal schneller und braucht keine Handles.
nodes() mit festen Pfaden pro Attribut? Weil das genau die Schleife im Code ist, nur in SQL: ein value()-Aufruf pro Attribut, tausend Aufrufe pro Typ, und bei jedem neuen Attribut eine Änderung. Für ein bekanntes Schema mit zwanzig Attributen ist das der richtige Weg. Für tausend Attribute, die niemand vollständig kennt, ist die generische Zerlegung mit anschließender Inventur in SQL die Fassung, die sich nicht bei jeder Katalogänderung mitändern muss.
Verwandte Artikel
Vorgelagert:
- Set-basiert statt Schleife: PostgreSQL-Refresh von 114 auf 12 Sekunden (das allgemeine Argument gegen die Schleife je Element)
- ETL vs. ELT — woran du erkennst, welches Muster du wirklich gebaut hast (roh laden, dann in SQL transformieren)
- Design Pattern // Architektur eines ETL-Prozesses (die Schichten, in die sich die Pfad/Wert-Tabelle einordnet)
Weiterführend:
- Prüfregeln aus dem Schema ableiten (die Inventur als Datenqualitätswerkzeug)
- Design Pattern // Sichere Typ-Konvertierung mit T-SQL (die typisierte zweite View-Schicht)
- Daten transferieren: bcp, COPY, pgloader, ETL (das Laden auf der Postgres-Seite)
Downloads: