Mitte September 2026 stand in diesem Blog eine Zahl über den Katalog manueller Testfälle im DI²-Projekt: 27 von 32 Testfällen gab es nur, weil vorher etwas kaputt gewesen war. Ob dieser Anteil sinkt, wenn die Praxis reift, blieb offen. Ein dritter Messpunkt sollte das zeigen, frühestens in einigen Monaten.
Sieben Wochen später hat der Katalog 159 aktive Testfälle, und 31 davon stammen aus einem Fehler. Der Anteil ist von 84 auf 19,5 Prozent gefallen, und das lag nicht an einer gereiften Praxis, denn die Regeln für das Schreiben von Testfällen sind dieselben geblieben. Geändert hat sich der Zeitpunkt, zu dem ein Testfall entsteht, und zugleich kam eine Phase mit vielen Features. Fehler gab es weiterhin, in diesen sieben Wochen kamen vier Testfälle aus einem Fehler dazu, von 27 auf 31. Gefallen ist der Anteil, weil die Testfälle aus Anforderungen um ein Vielfaches schneller wuchsen.
Dieser Artikel erzählt, wie die Entscheidung zustande kam, die Testfälle vor dem Code zu schreiben, zeigt den Anteil der Testfälle aus einem Fehler über die zehn Wochen seit dem Start des Katalogs und zieht Bilanz, was ein so entstandener Katalog in 34 Läufen gefunden hat, was er nicht geleistet hat und warum die wichtigeren Befunde bei den bestandenen Testfällen stehen.
Alle Zahlen stammen aus einem Projekt, von einem Maintainer, aus zehn Wochen Katalog. Sie zeigen, was in diesem Projekt geschehen ist. Ob das Schreiben der Testfälle vor dem Code in anderen Projekten ähnlich wirkt, lässt sich daraus nicht ableiten.
Den Katalog, die Testfälle seit dieser Entscheidung, die automatische Formprüfung, die bei jeder Änderung kontrolliert, ob ein Testfall richtig aufgebaut ist, und die Protokolle hat ein Coding-Agent geschrieben, Claude Code überwiegend mit dem Modell Claude Opus 5.5, daneben Claude Fable 5.1 und Claude Opus 5, nach Vorgaben des Maintainers. Der Maintainer hat die Entscheidung getroffen, er klickt die Läufe und meldet, was er sieht. Den Code der Anwendung liest er nicht selbst.
Das Wichtigste vorab:
- Der Anteil der Testfälle aus einem Fehler fiel von seinem Höchststand von 90 Prozent Anfang September auf 19,5 Prozent, weil der Zeitpunkt der Testfall-Erstellung wanderte und eine Phase mit vielen Features folgte, nicht weil die Testfälle besser geschrieben wurden: Seit Mitte September entstehen die Testfälle im UX-Schritt aus den Akzeptanzkriterien der Anforderungen, und die Bau-Schritte warten auf sie. In sieben Wochen kamen so 123 Testfälle aus Anforderungen dazu und vier aus Fehlern.
- Die Testfälle müssen vor dem Code entstehen, und das lässt sich nur erzwingen, indem der Bau wartet: Der erste Vorschlag des Agenten war, die Testfälle in der QA nach dem Bau zu schreiben. Ein Testfall, der dann entsteht, beschreibt, was das Programm schon tut, und am fertigen Testfall sieht niemand mehr, wann er geschrieben wurde. Deshalb starten Backend und Oberfläche im DI²-Projekt nicht, solange ein Klick-Kriterium ohne Testfall ist.
- In 34 Läufen sind zehnmal Testfälle fehlgeschlagen. Jedes Mal lag der Fehler im gerade gebauten Feature, kein einziges Mal am Testfall selbst: Die meisten dieser Testfälle waren geschrieben, bevor es den Code gab. Einer deckte auf, dass eine ganze Suchfunktion ausgefallen war. Ein anderer fand in der Kopie eines Projekts Regeln der Anwendung, die auf die falschen Spalten zeigten, obwohl der automatisierte Test des Features sie für richtig gehalten hatte, denn der hatte sie nur Wort für Wort mit dem Original verglichen.
- Fehler in Testfällen selbst und geänderte Anforderungen findet man nicht bei den fehlgeschlagenen, sondern bei den bestandenen Testfällen: Ein Testfall, der im Lauf korrigiert oder an eine geänderte Anforderung angepasst wird, läuft danach noch einmal und steht im Protokoll als bestanden, die Korrektur steht nur als Vermerk daneben. Rund ein Dutzend Testfälle wurden so korrigiert, bei fünf Features änderte der erste Blick auf die Oberfläche die Anforderung, zweimal war ein „pass“ falsch, also ein Schritt als bestanden gemeldet, der es nicht war. Und seit der Katalog 30 Testfälle hatte, ist er nicht ein zweites Mal vollständig gelaufen.
Voraussetzung: Keine. Aufbau eines Testfalls und die Regeln für das Schreiben beschreibt der Artikel Manuelle Testfälle schreiben, hier geht es um die Entwicklung danach. Die Beispiele stammen aus einer Web-Anwendung, die Tabellen und Spalten einer Datenbank verwaltet. Gebaut wird sie in einem festen Ablauf, den ein Coding-Agent Schritt für Schritt abarbeitet: Anforderung mit Akzeptanzkriterien, UX-Schritt mit den Mockups, Bau von Backend und Oberfläche, QA, Review, Auslieferung. Wo der Text einen dieser Schritte nennt, ist dieser Ablauf gemeint. Es geht um manuelle Testfälle, die ein Mensch am Bildschirm ausführt, nicht um die automatisierten Tests, die bei jeder Änderung von selbst laufen. Für die gibt es den Artikel Der grüne Test, der nichts beweist. Ein Wort aus dieser Anwendung kommt mehrfach vor und gehört nicht in die Testwelt: Eine Prüfregel ist dort eine Regel, mit der die Anwendung die Daten einer Spalte prüft, etwa auf einen erlaubten Wertebereich. Mit dem Testen der Anwendung hat sie nichts zu tun.
Inhalt
- Der Stand im September und die offene Frage
- Zehn Klick-Kriterien, null Testfälle
- Die Sperre an der falschen Stelle
- Der Anteil aus Fehlern: von 90 auf 20 Prozent
- Was die Testfälle fanden
- Was sonst in den Läufen passierte
- Was der Katalog nicht geleistet hat: der Regressionstest
- Was der Zeitpunkt leistet und was nicht
- Arbeits-Prompts als Beispiel
- Was am Ende trägt
- FAQ
- Verwandte Artikel
Der Stand im September und die offene Frage
Ein Testfall hat im DI²-Katalog zwei mögliche Anlässe. Er entsteht aus einer Anforderung und prüft, ob die Anwendung ein Akzeptanzkriterium erfüllt. Oder er entsteht aus einem Fehler und prüft, ob der Fehler wiederkommt. Die Übersicht des Katalogs führt in einer eigenen Zeile, wie viele der aktiven Testfälle aus einem Fehler entstanden sind. Die Formprüfung rechnet diese Zeile bei jeder Änderung nach, denn sie ergibt sich aus dem Feld, in dem jeder Testfall seine Anforderung oder seinen Fehler nennt.
Mitte September stand diese Zeile auf 27 von 32. Der Hub-Artikel ordnete das vorsichtig ein: Der Anteil sagt etwas über die Zusammensetzung eines Katalogs, nicht über seine Qualität, und dass ein drei Wochen alter Katalog überwiegend aus Fehlern besteht, war zu erwarten. Ob der Anteil sinkt, sobald mehr Testfälle aus Anforderungen entstehen, sollte ein späterer Messpunkt zeigen. Mit diesem Artikel liegt er vor, und er fiel anders aus, als die vorsichtige Einordnung erwarten ließ.
Kernaussage: Der Hub ließ offen, ob ein Katalog mit der Zeit von selbst mehr Testfälle aus Anforderungen bekommt. Die Antwort nach sieben Wochen lautet: nicht von selbst. Gedreht hat ihn eine Entscheidung und die Phase mit vielen Features, die auf sie folgte: Die Testfälle werden seitdem im UX-Schritt geschrieben, bevor gebaut wird, und jedes neue Feature brachte seine mit.
Zehn Klick-Kriterien, null Testfälle
Einen Tag nach dieser Zählung war ein Feature fertig. Seine Anforderung hatte 19 Kriterien, zehn davon ausdrücklich als solche markiert, die sich nur am Bildschirm prüfen lassen. Der QA-Schritt, in dem der Agent nach dem Bau jedes Kriterium am Code und über automatisierte Tests abnimmt, hatte alle 19 bestätigt. Dann fragte der Maintainer, ob es zu diesem Feature Testfälle gebe. Es gab keine.
Das war keine Nachlässigkeit. Der Ablauf hatte zwei Lücken. Erstens war niemand dafür zuständig, die Testfälle zu schreiben. Das Werkzeug, mit dem im Projekt Anforderungen geschrieben werden, markierte die Klick-Kriterien korrekt und vermerkte, dass die Testfälle „später“ entstünden, nach dem Bau der Oberfläche, ohne zu sagen, wer sie schreibt. Die vier Schritte danach, nämlich Bau, QA, Review und Auslieferung, erwähnten den Katalog mit keinem Wort. Zweitens hielt nichts den Ablauf an, wenn Testfälle fehlten. Die Formprüfung prüfte den Katalog gegen sich selbst, also Felder, Namen und die Übereinstimmung mit der Übersicht. Die Anforderungen kannte sie nicht. Zehn Klick-Kriterien ohne Testfall waren für jede Prüfung im Projekt grün.
Eine Messung über alle Anforderungen mit Klick-Kriterien ergab genau eine im Rückstand, eben diese. Der Rückstand war klein, aber unsichtbar, und nichts im Ablauf hätte danach gefragt. Ein Nachtrag aus derselben Sitzung passt dazu: Die Markierung der Klick-Kriterien kam in zwei Schreibweisen vor, und ein Zähler, der nur eine kennt, hätte neun statt zehn gemeldet und wäre grün geblieben. Deshalb wurde zuerst die Markierung auf eine Form festgelegt, und erst danach zählt etwas sie.
Kernaussage: Eine Pflicht, bei der nicht steht, wer sie erfüllt, erfüllt niemand, und eine Prüfung, die nur den Katalog kennt, sieht nicht, was im Katalog fehlt. Aufgefallen ist der Rückstand durch eine Frage.
Die Sperre an der falschen Stelle
Der eigentliche Fund kam im Gespräch über die Reparatur. Der erste Vorschlag kam vom Agenten und lautete, dass der QA-Schritt die Testfälle schreibt. Das klang schlüssig, denn der QA-Schritt geht ohnehin jedes Kriterium einzeln durch, und die Klick-Kriterien, die er nicht selbst prüfen kann, sind genau die, die einen manuellen Testfall brauchen. Hätte die Formprüfung dazu für jedes Kriterium nachgesehen, ob ein Testfall existiert, wäre das sogar messbar gewesen.
Der Einwand des Maintainers kippte den Vorschlag. Der QA-Schritt läuft nach dem Code. Ein Testfall, der dort entsteht, wird aus dem fertigen Programm geschrieben und nicht aus dem Kriterium. Damit fällt die einzige Trennung weg, die ein Ein-Personen-Projekt mit einem Coding-Agenten herstellen kann: die zeitliche. Der erste Vorschlag hätte also nicht gar keine Sperre bedeutet, sondern eine zur falschen Zeit. Sie hätte dafür gesorgt, dass zu jedem Klick-Kriterium eine Testfall-Datei existiert. Ob die Erwartung darin aus dem Kriterium stammt oder vom fertigen Programm abgeschrieben ist, sieht man der Datei nicht an, und der Katalog zählt Dateien. So eine Lösung fühlt sich richtig an und sieht in jeder Übersicht richtig aus, und genau deshalb ist sie die gefährlichere.
Die Entscheidung vom selben Tag hat vier Teile. Autor der Testfälle ist der UX-Schritt, in dem die Mockups entstehen. Er ist der erste Schritt, der neben dem Kriterium auch den Klick-Weg kennt, und der letzte vor dem Bau. Die Sperre sind die beiden Bau-Schritte für Backend und Oberfläche. Sie starten nicht, solange die Anforderung ein Klick-Kriterium ohne Testfall hat. Der QA-Schritt schreibt selbst keine Testfälle mehr. Er geht die vorhandenen durch und vermerkt im Protokoll, welche er nicht am Bildschirm fahren kann, weil ihm Browser oder Anmeldung fehlen. Diese Testfälle klickt danach der Maintainer. Die Formprüfung, die bis dahin nur den Katalog kannte, liest seitdem auch die Anforderungen und sieht für jedes Klick-Kriterium nach, ob ein Testfall existiert. Sie ist dabei das Netz hinter der Sperre: Sie läuft bei jedem Push und hält einen Rückstand sichtbar, falls die Sperre doch umgangen wird. Ob Schritte und Erwartung eines Testfalls sein Kriterium auch treffen, prüft sie weiterhin nicht. Für Fehler gilt die Regel bewusst enger. Ein Testfall aus einem Fehler entsteht nur, wenn sich der Fehler allein am Bildschirm nachstellen lässt und sein Fix sich nicht mit einem automatisierten Test sichern lässt. Eine Sperre, die bei jedem Fehler auslöst, würde mehr Testfälle erzwingen, als ein Mensch je fahren würde.
Kernaussage: Der Bau muss warten, nicht die QA. Der erste Schritt, der neben dem Kriterium auch den Klick-Weg kennt, ist der UX-Schritt, und dort entstehen die Testfälle seitdem.
Der Anteil aus Fehlern: von 90 auf 20 Prozent
Die Übersicht des Katalogs liegt im Repository, und jede Änderung an ihr ist ein Commit. Aus der Historie lässt sich deshalb für jeden Tag ablesen, wie viele Testfälle aktiv waren und wie viele davon aus einem Fehler stammten:
| Zeitpunkt | Aktive Testfälle | Aus einem Fehler | Anteil |
|---|---|---|---|
| Ende August, Start des Katalogs | 7 | 5 | 71 % |
| drei Tage später | 16 | 13 | 81 % |
| Anfang September | 21 | 18 | 86 % |
| eine Woche später | 30 | 27 | 90 % |
| Mitte September, Stand des Hub-Artikels | 32 | 27 | 84 % |
| Tag der Entscheidung | 38 | 27 | 71 % |
| zehn Tage später | 50 | 27 | 54 % |
| Anfang Oktober | 58 | 28 | 48 % |
| Mitte Oktober | 69 | 28 | 41 % |
| Ende Oktober | 115 | 28 | 24 % |
| Anfang November | 159 | 31 | 19,5 % |
Dieselben elf Messpunkte als Linie, mit dem Tag der Entscheidung als senkrechter Markierung:
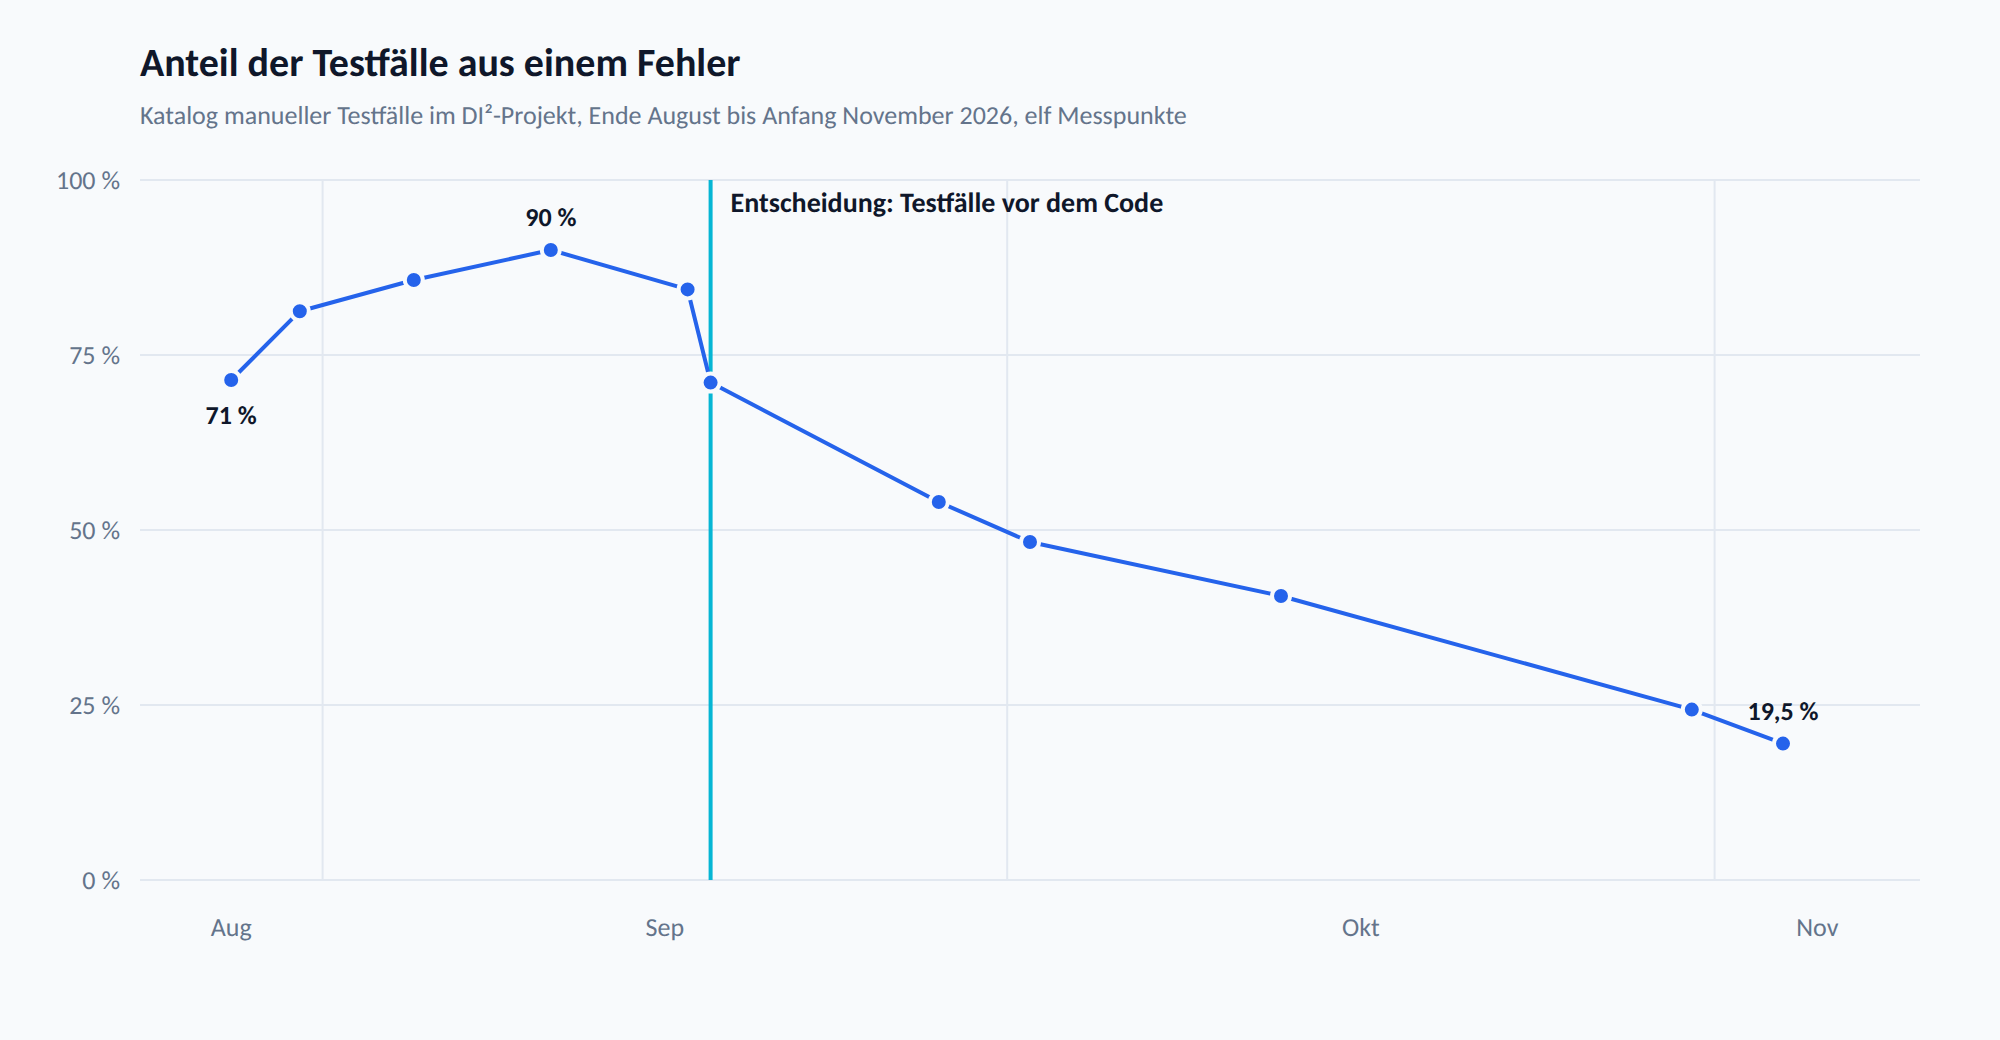
Zähler und Nenner getrennt gelesen: Die Testfälle aus einem Fehler wuchsen in sieben Wochen von 27 auf 31, die aus einer Anforderung von 5 auf 128. Der Anteil fiel also fast nur, weil der Nenner wuchs. Allein in der zweiten Oktoberhälfte kamen 46 Testfälle dazu, und keiner stammte aus einem Fehler.
Dass der Zähler fast stehen blieb, hat zwei Ursachen, und beide folgen aus der Entscheidung von Mitte September. Die eine ist die enge Regel für Fehler. Die andere ist weniger offensichtlich: Ein Fehler, der in einem gerade gebauten Feature auffällt, bekommt im Projekt keine eigene Fehler-Datei. Er wird im Lauf behoben und in der Anforderung vermerkt. Die Übersicht zählt einen Testfall aber nur dann zu denen aus einem Fehler, wenn er auf eine Fehler-Datei verweist. Alle acht Fehler, die der Katalog seitdem an seinen Erwartungen fand, erzeugten deshalb keinen Testfall aus einem Fehler. Sie hatten schon einen Testfall aus einer Anforderung, und der hatte sie gefunden.
Der Nenner wuchs nicht gleichmäßig. Die 123 neuen Testfälle kamen mit 20 Commits des UX-Schritts, einem je Feature, mit jeweils zwei bis 13 Testfällen. Nach Monaten gezählt entstanden im August 18 Testfall-Dateien, im September 40, im Oktober 66 und in den ersten Novembertagen 36. Der Rückgang des Anteils hat damit zwei Ursachen, die sich nicht trennen lassen: eine Sperre und eine Phase mit vielen Features. Ohne die Sperre hätte diese Phase womöglich Features ohne Testfälle hervorgebracht wie das eine am Tag der Entscheidung, und ohne die Phase hätte die Sperre nichts zu erzwingen gehabt. Für elf Features lässt sich die Reihenfolge an den Commit-Zeiten belegen: zuerst der UX-Schritt mit Mockup und Testfällen, dann Backend, dann Oberfläche, beim kleinsten Feature im Abstand von 18 Minuten, beim größten von drei Tagen.
Kernaussage: Der Anteil misst die Zusammensetzung des Katalogs, nicht die Qualität der Testfälle. Gesunken ist er, weil jedes Feature seine Testfälle vor dem Bau bekam, nicht weil weniger schiefging.
Was die Testfälle fanden
Seit der Entscheidung gibt es 34 Protokolle. Jedes hält je gefahrenem Testfall in einer Zeile fest, ob er bestanden hat, fehlgeschlagen ist oder übersprungen wurde, zusammen 166 Zeilen: 136 bestanden, zehn fehlgeschlagen, 19 übersprungen, und eine Zeile ist offen geblieben, weil eine Sichtprüfung nicht einzeln zurückgemeldet wurde. Hinter den zehn Fehlschlägen stecken acht Fehler in der Anwendung, denn zweimal traf dieselbe Ursache zwei Testfälle. Alle acht lagen im Code des gerade gebauten Features und wurden behoben, die meisten noch im selben Lauf, keiner später als zwei Tage danach. Keiner der zehn Fehlschläge ging auf einen Fehler im Testfall zurück, keiner auf die Umgebung.
Sechs der acht fanden Testfälle, die vor dem Bau geschrieben waren. Ein Beispiel aus dem Oktober: Ein neues Register für ein Aktivitäts-Protokoll bekam eine Suche, und der Testfall verlangte in Schritt 8, dass die Suche nach einem Tabellennamen nur die passenden Einträge zeigt. Stattdessen endete jede Suche in einem Fehler-Banner. Die Datenbank-Abfrage enthielt einen Syntaxfehler, und im DI²-Projekt fährt kein automatisierter Test den Text einer Abfrage gegen eine echte Datenbank. Die Funktion war komplett ausgefallen, und bemerkt hat das kein Test, nur der Mensch am Bildschirm.
Ein Beispiel aus dem November zeigt, wie ein manueller Testfall und ein automatisierter Test aneinander vorbeilaufen. Ein Feature kopiert ein ganzes Projekt samt seiner Prüfregeln, also der Regeln, mit denen die Anwendung die Daten einer Spalte prüft. Der Testfall verlangte, dass die Prüfregeln der Kopie auf die Spalten der Kopie zeigen. Sie zeigten auf die Spalten des Originals, und die Kopie meldete „entfernte Spalte“. Der automatisierte Test des Kopiervorgangs hatte die Regeln Wort für Wort mit dem Original verglichen, und Wort für Wort waren sie gleich. Er hielt den Fehler für richtig. Das ist das Muster aus dem Artikel über den grünen Test, der nichts beweist, nur dass hier der manuelle Testfall den Fehler fand.
Das dritte Beispiel aus diesen sechs hat am Bildschirm niemand gesehen. Ein Testfall verlangte, dass ein Verbindungstest genau einen Eintrag im Protokoll hinterlässt. Der Agent, der den Lauf führte, las parallel den Stand der Datenbank und fand zwei Einträge in derselben Sekunde. Die Ursache lag im Code des Features: Zwei Stellen schrieben denselben Eintrag, einmal der Verbindungstest selbst und einmal das Speichern seines Ergebnisses. Die zweite Stelle schreibt seitdem keinen Eintrag mehr, und der nächste Verbindungstest hinterließ genau einen. Der Maintainer hatte am Bildschirm nichts Falsches gesehen. Gefunden hat den Fehler der Mitschnitt der Datenbank, den der Artikel zur ersten Ausführung als Nachweis beschreibt.
Die zwei übrigen Fehler stammen aus dem Lauf am Tag der Entscheidung, aus dem Feature, das die Entscheidung ausgelöst hatte. Seine Testfälle entstanden nach dem Code, aber aus den Kriterien. In Schritt 5 zweier Testfälle fehlte am Bildschirm ein Warn-Marker, den das Kriterium verlangte: gezeichnet, aber in der Farbe seines Hintergrunds und halb von der Nachbarzelle verdeckt. Der automatisierte Test hatte geprüft, dass der Marker im Dokument steht. Ob er sichtbar ist, kann ein solcher Test nicht prüfen.
Kernaussage: Ein Testfall, dessen Erwartung vor dem Code feststand, kann gegen den ersten Code fehlschlagen, und im DI²-Projekt hat er das sechsmal getan. Zwei weitere Fehler fanden Testfälle, die erst nach dem Code, aber ebenfalls aus dem Kriterium geschrieben waren. Alle acht Fehler lagen im gerade gebauten Feature, und kein automatisierter Test hatte sie gesehen.
Was sonst in den Läufen passierte
Wer nur die Fehlschläge zählt, sieht einen Katalog, dessen Testfälle nie falsch waren. Das liegt an der Konvention: Ein im Lauf korrigierter Testfall läuft danach erneut, die Zeile endet mit bestanden, und die Korrektur steht als Vermerk daneben. In den 34 Protokollen stehen deshalb vier Arten von Vorgängen bei den bestandenen Testfällen, und keine davon taucht in einer Zählung der Fehlschläge auf.
Der Testfall war falsch: Rund ein Dutzend Testfälle wurden im Lauf korrigiert, etwa weil ein Testfall einen Bestätigungs-Dialog erwartete, den die Oberfläche in dieser Situation gar nicht zeigt. Das sind dieselben Fehlermodi wie bei den ersten 30 Testfällen im September, nur erkennbar seltener. Das passt zu Testfällen, deren Schritte aus einem Mockup stammen statt aus dem Kopf.
Die Anforderung war falsch: Bei fünf Features änderte der erste Lauf nicht den Code, sondern das Kriterium. Der deutlichste Fall: Ein Testfall bestand seinen ersten Schritt, eine Zelle ohne Inhalt blieb leer, wie es die Erwartung verlangte. Beim Anblick der leeren Spalte wünschte sich der Maintainer einen Platzhalter in jeder Zeile, und die Erwartung wurde geändert, nachdem sie bestanden war. In einem anderen Fall verlangte ein Kriterium ein Verhalten, das eine ältere Regel der Anwendung absichtlich verhindert, und das Kriterium wurde zurückgenommen.
Der Fehler lag neben dem Schritt: Rund 25 Fehler fielen während der Läufe auf, ohne dass ein Schritt sie verlangt hätte, 18 davon waren alt und lagen außerhalb des gebauten Features. Gegen acht Fehler an den Erwartungen ist das ein Verhältnis von gut drei zu eins. Beim ersten vollständigen Lauf im September waren es 17 gegen zwei. Die Zählweisen unterscheiden sich, ein Prozentvergleich wäre deshalb nicht seriös. Die Richtung ist trotzdem erkennbar: Die neuen Testfälle finden an ihren Schritten mehr als die alten, und das meiste findet weiterhin der Mensch, der beim Klicken hinschaut.
Das „pass“ stimmte nicht: Zweimal meldete der Maintainer Schritte als bestanden, die es nicht waren. Einmal war ein Element erst beim nächsten Wechsel der Ansicht erschienen, einmal waren fünf Schritte auf einem anderen Datensatz gelaufen als dem, den der Testfall verlangte. Beide Male zeigte erst der Mitschnitt der Datenbank, dass das „pass“ nicht stimmte.
Kernaussage: Die zehn Fehlschläge zeigen nur die Fehler, die ein Testfall an seiner Erwartung gefunden hat. Was am Testfall selbst falsch war, wo die Anforderung beim ersten Blick auf die Oberfläche geändert wurde und wo ein „pass“ nicht stimmte, steht bei den bestandenen Testfällen. Wer nur Fehlschläge zählt, sieht die Hälfte seiner Läufe.
Was der Katalog nicht geleistet hat: der Regressionstest
Jeder Testfall trägt eine Lauf-Klasse. Ein Smoke-Testfall läuft bei jeder Auslieferung. Ein Regressions-Testfall läuft, wenn eine der Dateien geändert wurde, die er abdeckt, außerdem vor jeder Auslieferung in die Produktion und einmal im Quartal über den ganzen Katalog. So steht es in der Regel für die Lauf-Klasse. Erzwungen wird sie von nichts, und seit Mitte September wurde sie nicht eingehalten. Nötig war das bisher auch nicht. Die Regel schützt Nutzer vor Fehlern, die mit einer späteren Änderung zurückkehren, und in einem privaten Projekt gibt es diese Nutzer nicht.
Der erste vollständige Lauf fand Mitte September statt, über drei Tage, mit 30 Testfällen. Seitdem hat sich der Katalog verfünffacht, und einen zweiten vollständigen Lauf gab es nicht. Die 34 Läufe seither sind Abnahme-Läufe je Feature und Wiederholungen je Fehler. Der Katalog hat 160 Testfall-Dateien, 159 aktive und eine zurückgezogene. 158 der 159 aktiven Testfälle sind mindestens einmal gelaufen, die meisten genau einmal, bei der Abnahme ihres Features. Gegen die Produktion lief ein einziges Protokoll mit einem einzigen Schritt. Der Testfall, der noch nie lief, stammt aus einem Fehler und braucht die Server-Umgebung, zwei Konten und zwei Browser.
Das Material zu diesem Artikel hatte dafür schon im September eine Vermutung, und die Läufe seither bestätigen sie: Ein Fälligkeits-Kriterium, das in einer Bauphase ständig auslöst, wird nicht befolgt, nicht aus Nachlässigkeit, sondern weil es mehr verlangt, als der Tag hergibt. Der erste vollständige Lauf wurde nicht durch eine geänderte Datei ausgelöst, sondern durch eine Ansage: einmal alles. Für einen Katalog mit 159 Testfällen, von denen mehrere Suiten zwei Konten, ein eigenes Prüf-Projekt oder die Server-Umgebung brauchen, ist das der realistische Weg. Ein vollständiger Lauf ist dann ein Meilenstein mit Termin.
Eingelöst hat der Katalog in dieser Zeit etwas anderes. Alle 19 Fälle, in denen ein Testfall übersprungen wurde, nennen ihren Grund. 14 stammen vom QA-Schritt des Agenten, dem Browser, Anmeldung oder Konten fehlen, und in jedem Fall hat der Maintainer die Testfälle am selben oder am nächsten Tag auf dem Server gefahren. Ein übersprungener Testfall ist damit ein sichtbarer Rückstand, kein vergessener.
Kernaussage: Die Lauf-Klasse verspricht einen Regressions-Lauf, den es seit Mitte September nicht gab. Die meisten der 159 Testfälle sind genau einmal gelaufen. Ob sie als Regressionsnetz taugen, ist damit ungeprüft. Ein vollständiger Lauf braucht bei dieser Größe einen Termin, keinen Trigger.
Was der Zeitpunkt leistet und was nicht
Dieselbe Instanz schreibt im DI²-Projekt die Anforderung mit ihren Kriterien, den Testfall und den Code. Die Entscheidung von Mitte September hat daran nichts geändert, sie hat nur die Reihenfolge festgelegt. Die Läufe seither zeigen ziemlich genau, was diese Reihenfolge leistet und was nicht.
Sie leistet, dass die Erwartung nicht vom Code abgeschrieben ist. Sechs Fehler an Testfällen, die vor dem Bau entstanden, belegen das, denn eine Erwartung, die vom fertigen Code abgeschrieben ist, übernimmt dessen Fehler, statt sie zu finden. Hätte der Testfall den fertigen Code beschrieben, hätte er die ausgefallene Suche und die falsch verknüpften Prüfregeln als gegeben hingenommen. Die zwei Fehler vom Tag der Entscheidung zeigen daneben, dass auch eine Erwartung, die nach dem Code aus dem Kriterium geschrieben wird, noch findet. Entscheidend ist die Quelle der Erwartung, der Zeitpunkt sichert die Quelle ab.
Sie leistet nicht, dass die Erwartung richtig ist. Ein Testfall, der vor dem Code aus einem unvollständigen Kriterium entsteht, besteht gegen einen Code, der das unvollständige Kriterium erfüllt. Die fünf Anforderungen, die beim ersten Lauf geändert wurden, sind dafür der Beleg, und der Fall mit dem Platzhalter ist der deutlichste: Die Erwartung war bestanden, und sie war trotzdem nicht das, was der Maintainer wollte. Wer das Kriterium schreibt und zugleich weiß, wie er es umsetzen wird, schreibt es im Zweifel so, wie er es umsetzen wird. Den Irrtum im Kriterium sieht erst ein Mensch an der fertigen Oberfläche, und der Lauf ist der Moment, in dem das geschieht.
Kernaussage: Der Zeitpunkt vor dem Code sichert die Quelle der Erwartung, nicht ihre Richtigkeit. Sechs Funde belegen das eine, fünf geänderte Anforderungen das andere. In einem Ein-Personen-Projekt übernimmt die Reihenfolge von der zweiten Person, die den Testfall sonst schriebe, genau eines: Der Testfall entsteht nicht am fertigen Code entlang. Mehr übernimmt sie nicht.
Arbeits-Prompts als Beispiel
Die Sitzungen sind nicht versioniert. Die zwei Prompts sind aus den Regeln des Katalogs und den Notizen zu der Sitzung, in der die Entscheidung fiel, rekonstruiert und keine Zitate. Sie zeigen, was der Maintainer verlangt hat, nicht wie der Agent es umgesetzt hat.
Der erste ist der Einwand gegen den Vorschlag, den QA-Schritt zum Autor der Testfälle zu machen. Er legt das Was fest und überlässt dem Agenten das Wie:
Der QA-Schritt als Autor der Testfälle ist zu spät. Er läuft nach dem Code, und
ein Testfall, der dort entsteht, wird aus dem fertigen Programm geschrieben,
nicht aus dem Kriterium. Die Testfälle müssen vor dem Code geschrieben sein.

Schlag vor, welcher Schritt in unserem Ablauf der früheste ist, in dem das
Kriterium und der Klick-Weg beide feststehen, und wie die Bau-Schritte das
erzwingen. Abnahme: Eine Anforderung mit Klick-Kriterien ohne Testfall
blockiert den Bau, und die Prüfung bei jedem Push zeigt den Rückstand.
Der UX-Schritt als Autor war der Vorschlag des Agenten, der den Ablauf des Projekts kennt. Die Bedingung „vor dem Code“ kam vom Maintainer.
Der zweite ist die Übergabe an den UX-Schritt, wie sie seitdem bei jedem Feature lautet:
Hier sind die Anforderung und die freigegebenen Mockups. Schreib für jedes
Klick-Kriterium einen Testfall nach der Konvention des Katalogs: Erwartung
aus dem Kriterium, Schritte aus dem Mockup, mindestens eine Aussage darüber,
was nicht passieren darf, Schritt und Erwartung nebeneinander.

Abnahme: Die Formprüfung des Katalogs ist grün, und jedes Klick-Kriterium
der Anforderung hat einen Testfall.
Der Prompt wiederholt die Regeln nicht, er verweist auf sie. Das Abnahme-Kriterium macht aus einem Vorschlag eine Vorgabe: Ohne die zweite Bedingung wäre der Katalog grün, auch wenn ein Kriterium fehlt.
Was am Ende trägt
Der Anteil der Testfälle aus einem Fehler ist im DI²-Katalog von 90 auf 19,5 Prozent gefallen, und die Gründe waren eine Sperre vor dem Bau und eine Phase mit vielen Features, nicht eine gereifte Praxis. Die so entstandenen Testfälle haben in sieben Wochen acht Fehler an ihren Erwartungen gefunden, alle im gerade gebauten Feature, und sie haben bei den bestandenen Testfällen gezeigt, wo der Testfall falsch war und wo die Anforderung.
Für einen eigenen Katalog ergeben sich daraus drei Entscheidungen:
| Lage | Entscheidung |
|---|---|
| Der Katalog ist jung und besteht überwiegend aus Fehlern | Den Bau warten lassen: Kein Feature wird gebaut, solange ein Klick-Kriterium ohne Testfall ist. Eine QA nach dem Bau stellt nur fest, dass es die Datei gibt. |
| Der Katalog wächst mit den Features | Den vollständigen Lauf als Meilenstein mit Termin planen. Ein Fälligkeits-Kriterium, das in der Bauphase ständig auslöst, wird nicht befolgt. |
| Ein Testfall lässt sich gerade nicht fahren | Überspringen mit Grund und nachfahren, sobald die Umgebung da ist. Ein übersprungener Testfall mit Grund ist ein Rückstand, ein vergessener ist keiner. |
Und bei jedem Lauf lohnt der Blick auf die Testfälle, die bestanden haben. Im Protokoll steht daneben, ob der Testfall korrigiert wurde, ob die Anforderung sich beim ersten Anblick geändert hat und ob ein „pass“ gegen den Mitschnitt gehalten wurde.
Ein Katalog wird nicht dadurch belastbar, dass seine Testfälle einmal bestanden haben. Dafür müssen sie nach späteren Änderungen erneut laufen, und das ist der Lauf, den es seit Mitte September nicht gab. Der Zeitpunkt vor dem Code sichert, woher die Erwartung stammt. Ein Nachweis, dass sie stimmt, ist er nicht.
FAQ
Nicht die ganzen. Vorbedingung, Schritte und Aufräumen brauchen die fertige Oberfläche oder zumindest ein Mockup davon. Das erwartete Ergebnis dagegen kommt aus dem Kriterium der Anforderung, und das steht vor dem Code fest. Im DI²-Projekt schreibt der UX-Schritt die Testfälle aus Kriterium und Mockup, bevor Backend und Oberfläche gebaut werden. Entscheidend ist die Quelle der Erwartung, der Zeitpunkt sorgt dafür, dass niemand sie vom fertigen Code abschreibt.
Sie sorgt dafür, dass die Erwartung nicht am fertigen Code entlanggeschrieben wird. Im DI²-Projekt fanden sechs Testfälle, die vor dem Bau entstanden, einen Fehler im ersten Code. Sie sorgt nicht dafür, dass das Kriterium richtig ist. Bei fünf Features wurde in sieben Wochen die Anforderung beim ersten Blick auf die Oberfläche geändert, einmal nachdem der Testfall schon bestanden war. Den Irrtum im Kriterium sieht erst ein Mensch an der Oberfläche.
Weil eine QA nach der Umsetzung nur sehen kann, ob es zu jedem Kriterium einen Testfall gibt. Ob seine Erwartung aus dem Kriterium stammt oder vom fertigen Programm abgeschrieben ist, sieht man dem Testfall nicht an. Wenn der Bau wartet, bis die Testfälle da sind, kann das Abschreiben vom fertigen Programm gar nicht erst passieren. Eine Prüfung bei jedem Push bleibt daneben sinnvoll, damit ein Rückstand auffällt, falls doch einmal ohne Testfälle gebaut wurde. Ob das Kriterium selbst richtig ist, sichert weder die Sperre noch die Prüfung. Das zeigt erst der Lauf.
Nein. Seine Testfälle sollen absichern, was schon einmal schiefgegangen ist, und das ist für einen jungen Katalog der normale Zustand. Der Anteil sagt etwas über die Zusammensetzung, nicht über die Qualität. Zur Aussage wird er erst, wenn er sich nicht ändert, obwohl Features dazukommen. Im DI²-Projekt hat er sich von selbst nicht geändert, sondern erst, als jedes Feature seine Testfälle vor dem Bau bekommen musste.
Ein Abnahmelauf prüft ein Feature direkt nach dem Bau gegen seine Testfälle, im DI²-Projekt meist genau einmal. Ein Regressionslauf wiederholt Testfälle nach späteren Änderungen und zeigt, ob etwas Bestehendes dabei kaputtgegangen ist. Ein Testfall, der nur seine Abnahme bestanden hat, ist deshalb noch kein nachgewiesener Regressionstest. Im DI²-Katalog sind die meisten der 159 Testfälle nur in der Abnahme gelaufen, und ob sie als Netz taugen, zeigt erst der zweite vollständige Lauf.
Verwandte Artikel
Vorgelagert:
- Manuelle Testfälle schreiben — der Hub dieses Themas: Aufbau eines Testfalls, die vier Schreibregeln und der Stand der Herkunft im September, an den dieser Artikel anschließt.
- Die erste Ausführung testet den Testfall — der erste vollständige Lauf des Katalogs, die zwei Fehlermodi einer Deklaration und der Mitschnitt als Nachweis.
Nebenan:
- Der grüne Test, der nichts beweist — warum ein automatisierter Test den Fehler bestätigen kann, den er finden sollte, hier wiedererkannt an einem Test, der Prüfregeln Wort für Wort verglich.
- Unit-Test grün, Integration kaputt — der Fall, in dem ein manueller Testfall den Fehler fand, den zwölf grüne Tests nicht sahen.
Übergeordnet:
- KI-gestützte SQL-Entwicklung mit Claude Code — der Hub des KI-Coding-Clusters: Rules, Skills und Agenten im Überblick.
- Agentic Coding aus Anwender-Sicht — die Erfahrung des Anwenders, der den Code nicht selbst schreibt.
Kontrolle und Regeln:
- Die Kontroll-Schleife — die wiederkehrende Kontrolle von Code, den man selbst nicht lesen kann, mit den Testfällen als einer Station.
- Der Agent misst, wo der Mensch klickt — dieselbe Arbeitsteilung bei der Fehlersuche, mit dem Mitschnitt der Datenbank als Beleg.
- Warum sqlfluff unsere SQL-Konventionen nicht prüfen kann — ein eigenes Prüfprogramm als Netz für Regeln im Code, dieselbe Mechanik wie hier für eine Pflicht im Ablauf.